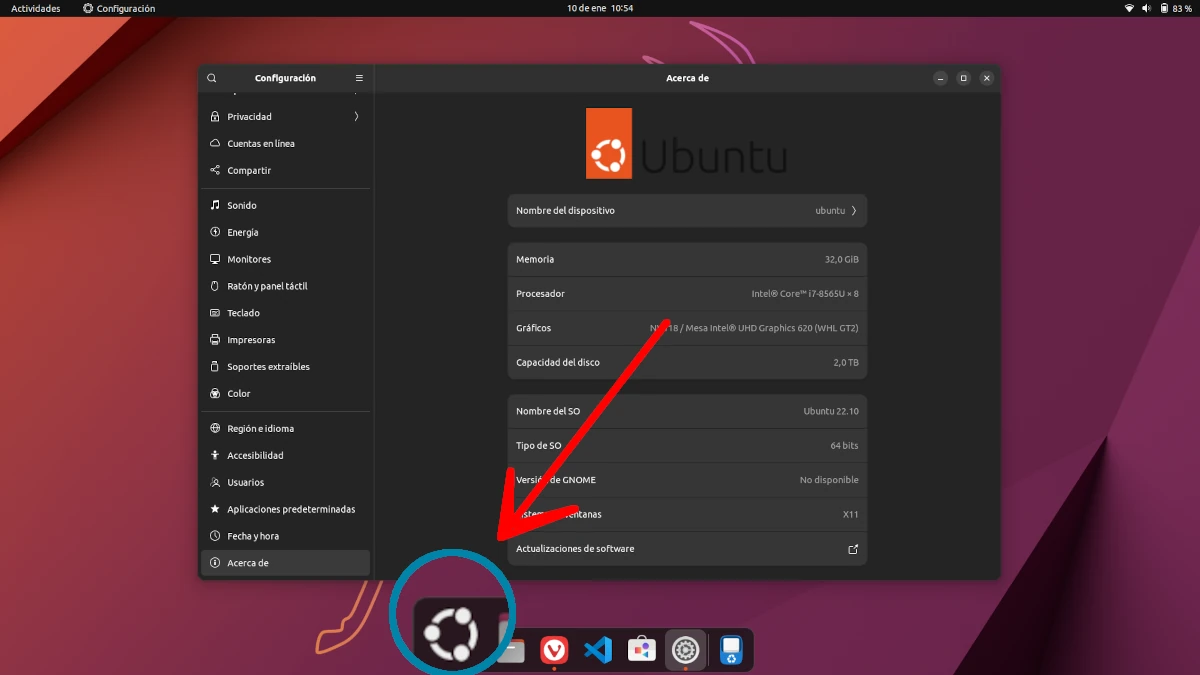
Pon el botón de «Mostrar Aplicaciones» a la izquierda en Ubuntu

Logotipo de Ubuntu en el botón Mostrar Aplicaciones

Para ser totalmente sincero, yo no recordaba dónde estaba el botón de «Mostrar aplicaciones» en GNOME sencillamente porque dejé de usarlo cuando Ubuntu se pasó a Unity. Pero mirar un poco por Internet me ha recordado que o no estaba o siempre estuvo a la parte de abajo. En un principio, era un dock que estaba a la izquierda, pero en la actualidad ha pasado a situarse a la parte inferior por defecto. Lo que no se ha movido ha sido ese botón de «Mostrar aplicaciones», pasando a estar a la derecha ahora que el dock está por defecto en «Bottom».

Hacer modificaciones en el diseño de un sistema operativo debe ser una decisión personal. Por ejemplo, yo solía poner los botones de cerrar, restaurar y minimizar a la izquierda, pero ver que casi todas las distribuciones Linux las ponen por defecto a la derecha, que en Windows también está ahí y que en estos momentos no tengo pensado adquirir un Mac me ha hecho cambiar de opinión. Con lo del menú de «Mostrar aplicaciones» estamos en una situación diferente: Plasma, LXQt, Cinnamon, Xfce, Windows… la mayoría ponen ese menú a la izquierda, por lo que puede ser buena idea mover ese botón y cambiarlo de lado.

«Mostrar aplicaciones» a la izquierda

Esto tenía mucho más sentido en Ubuntu hasta que empezó a permitir (más bien a tener instalado por defecto Dash To Dock) convertir el panel de lado a lado en un dock. Hace varias versiones, el panel estaba de arriba a abajo y sólo podía estar a la izquierda, y más adelante permitió que se moviera a la parte inferior. Era en ese momento en el que ponerlo a la parte izquierda tenía más sentido: del botón «Mostrar aplicaciones» a los iconos fijados había mucho espacio, y era de todo menos intuitivo. Ahora que se puede convertir en un dock de verdad ya es una cuestión de gustos.

Para ponerlo en la izquierda si estamos en Ubuntu basta con abrir un terminal y escribir lo siguiente:

gsettings set org.gnome.shell.extensions.dash-to-dock show-apps-at-top true

Si leemos con atención, veremos que lo que estaremos haciendo en verdad es mover el icono arriba, y no a la izquierda. Esto es así porque la posición natural del dock de Ubuntu es a la izquierda, y no funcionará en distribuciones que no usen el panel de Ubuntu y tengan instalada la extensión «dash-to-dock».

Si os estáis preguntando cómo cambiar el logotipo, en Ubuntu se hace como explicamos en este otro artículo. Opciones al rescate.

from Linux Adictos https://ift.tt/1DaAslS
via IFTTT
OpenAI trabaja en una solución para detectar texto generado por ChatGPT

ChatGPT

ChatGPT es un prototipo de chatbot de inteligencia artificial

Se dio a conocer la noticia de que OpenAI está desarrollando un software que puede detectar si su modelo ChatGPT generó texto, esto poco después de que los funcionarios de educación de la ciudad de Nueva York anunciaran que bloquearían el acceso de los estudiantes a la herramienta en las escuelas públicas.

Y es que han dado a conocer diversos informes de qué estudiantes que usan IA para hacer sus tareas, han hecho que los maestros piensen en cómo afecta la educación.

Algunos han expresado su preocupación acerca de cómo los modelos de lenguaje pueden permitir que los estudiantes hagan trampa.

Ante ello OpenAI anuncio que está trabajando para desarrollar «mitigaciones» que ayudarán a las personas a detectar el texto generado automáticamente por ChatGPT.

«Hemos hecho que ChatGPT esté disponible como una vista previa de investigaciónaprender del uso en el mundo real, que creemos que es una parte esencial del desarrollo y la implementación de sistemas de IA capaces y seguros. Estamos constantemente incorporando comentarios y lecciones aprendidas”, dijo un portavoz de la compañía.

Según testimonios de profesores universitarios, los estudiantes confían a ChatGPT para resolver sus tareas, especialmente en los ensayos.

“La academia no lo vio venir. Así que nos tomó por sorpresa”, dice Darren Hudson Hick, profesor asistente de filosofía en la Universidad de Furman.

«Lo informé en Facebook, y mis amigos [maestros] dijeron: ‘¡sí! Yo también atrapé uno’», agregó. A principios de este mes, según los informes, Hick le pidió a su clase que escribiera un ensayo de 500 palabras sobre el filósofo escocés del siglo XVIII David Hume y la paradoja del horror, que examina cómo las personas pueden obtener placer de algo que temen, para una prueba en casa. Pero según el profesor de filosofía, uno de los ensayos que le llegó tenía algunas características que «marcaban» el uso de la IA en la respuesta «rudimentaria» del estudiante. Hick explica que esto puede ser detectado por un ojo entrenado.

Ser capaz de distinguir la escritura a mano producida por un humano o una máquina cambiará la forma en que se pueden usar en la academia. Las escuelas podrían hacer cumplir de manera más efectiva la prohibición de prueba generada por IA,

Sí, los modelos de lenguaje generativo pueden ser buenos, pero no saben de lo que están hablando.

Tan impresionante como suena la escritura generada por IA en los titulares con conferencias universitarias y escuelas que prohíben los artículos escritos a máquina, aquí hay un recordatorio de que carecen de comprensión de escritura humana real.

Y es que OpenAI ha estado impresionando a Internet con sus esfuerzos para replicar la inteligencia humana y las habilidades artísticas desde 2015. Pero en noviembre pasado, la compañía finalmente se volvió mega viral con el lanzamiento del generador de texto AI ChatGPT. Los usuarios de la herramienta beta publicaron ejemplos de respuestas de texto generadas por IA a indicaciones que parecían tan legítimas que infundieron miedo en los corazones de los maestros e incluso hicieron que Google temiera que la herramienta podría acabar con su actividad de investigación.

Si los ingenieros de OpenAI pueden crear un bot que pueda escribir tan bien o mejor que el humano promedio, es lógico que también puedan crear un bot que sea mejor que el humano promedio para detectar si el texto fue generado por IA.

Ya que como se mencionó por el momento OpenAI trabaja en una solución, ya se han dado a conocer al menos tres herramientas de detección que se pueden usar:

Detector de salida GPT-2

La demostración en línea del modelo de detector de salida GPT-2 le permite pegar texto en un cuadro y ver de inmediato la probabilidad de que el texto haya sido escrito por la IA. Según la investigación de OpenAI, la herramienta tiene una tasa de detección relativamente alta, pero «debe combinarse con enfoques basados ​​en metadatos, juicio humano y educación pública para ser más eficaz».

GLTR 

Cuando OpenAI lanzó GPT-2 en 2019, la gente del MIT-IBM Watson AI Lab y el Harvard Natural Language Processing Group se unieron para crear un algoritmo que intenta detectar si el texto ha sido escrito por un bot.

El texto generado por computadora puede parecer escrito por un ser humano, pero es más probable que un escritor humano seleccione palabras impredecibles. Usando el método «se necesita uno para conocer uno», si el algoritmo GLTR puede predecir la siguiente palabra en una oración, asumirá que la oración fue escrita por un bot.

GPTZero

Durante la temporada navideña, Edward Tian estuvo ocupado creando GPTZero, una aplicación que puede ayudar a determinar si el texto fue escrito por un humano o un bot. Como académico en Princeton, Tian comprende cómo los profesores universitarios pueden tener un interés personal en detectar el IAgiarismo o el plagio asistido por IA.

Tian dice que su herramienta mide la aleatoriedad de las oraciones («zumbidos») más la aleatoriedad general («ráfagas») para calcular la probabilidad de que el texto haya sido escrito por ChatGPT. Desde que tuiteó sobre GPTZero el 2 de enero, Tian dice que ya se le han acercado capitalistas de riesgo que desean invertir y que pronto desarrollará versiones actualizadas.

Fuente: https://techcrunch.com

from Linux Adictos https://ift.tt/6VKhBj9
via IFTTT

Buscan cambiar el nombre de los proyectos Apache

Apache

Piden Apache que cambie de nombre

Hace poco se dio a conocer la noticia de que Natives in Tech, una organización sin fines de lucro dedicada a desarrollar un ecosistema tecnológico para los pueblos indígenas, realizo una petición a Apache Software Foundation en la que pidió que dejara de usar la palabra «Apache» y los símbolos nativos americanos en el logotipo, incluido el cambio de nombre de todos los proyectos desarrollados con este nombre.

Sobre la petición se menciona que usar la palabra «Apache» y marcar una identidad indígena para lograr los propios objetivos se percibe como una manipulación inaceptable de los valores culturales de las minorías nacionales, distorsionando la imagen de los indígenas y basándose en estereotipos establecidos después de las películas spaghetti western.

Asociar una empresa de tecnología con una noción tan romántica, en la que la comunidad nativa americana existente y en crecimiento es tratada como muerta y desaparecida, se considera ignorante y ofensivo.

Uno de los fundadores, Brian Behlendorf, describe cómo decidió elegir el nombre Apache en el documental “Trillions and Trillions Served” :

Sugerí el nombre Apache en parte porque las tecnologías web en el momento del lanzamiento se llamaban cyber this o spider that o algo sobre esos temas y pensé que necesitábamos algo un poco más interesante, un poco más romántico, no para ser un apropiador cultural o algo por el estilo, acababa de ver un documental sobre Gerónimo y los últimos días de una tribu de nativos americanos llamada los apaches, verdad, que sucumbieron a la invasión del oeste, de los Estados Unidos, y fueron la última tribu renunciar a su territorio y para mí eso representó casi románticamente lo que sentía que estábamos haciendo con este proyecto de servidor web…

Según los autores de la iniciativa, la Fundación Apache debería actuar de acuerdo con su código de conducta, cuyo quinto párrafo exige cautela en las palabras escogidas.

Esta presentación “romántica” spaghetti-western francamente obsoleta de una comunidad viva y vibrante como muerta y desaparecida para construir una empresa de tecnología “para el bien común” es tan ignorante como ofensiva. Instamos a The Apache® Software Foundation a tomar las medidas necesarias para expresar el aliado que promueven tan profundamente en su sitio web, a actuar de acuerdo con su propio código de conducta , a “tener cuidado con las palabras que [ellos] eligen ”, y cambiar su nombre.

El portavoz de la Fundación Apache dijo que la comunidad ha escuchado y escuchará las preocupaciones de los nativos americanos, pero el cambio tomará el tiempo que le tome a la comunidad discutir el tema, evaluar las implicaciones legales y tomar una decisión informada. También se están estudiando formas alternativas de resolver el problema, pero aún no se han anunciado públicamente.

Idealizar las culturas indígenas es una forma de enmarcarlas como estáticas en lugar de dinámicas. Tampoco reconoce años de guerra, asimilación forzada y otras políticas adversas arraigadas como trauma histórico a lo largo de las generaciones y hasta el día de hoy. Las organizaciones que dicen apoyar a los pueblos indígenas pero que carecen de una conexión real con ellos, y en su lugar se basan en estereotipos históricos, no logran ser aliados de aquellos a quienes intentan emular.

Hasta 2003, el nombre del servidor Apache http se trataba en las preguntas frecuentes del proyecto como «un servidor PATCHy», es decir, Un servidor HTTP resultante de modificaciones al código base del servidor http de NCSA. En 2003, se cambió la aclaración para indicar que el nombre se eligió por respeto a las tribus indígenas apaches.

Para promover la iniciativa, 40 activistas han publicado y firmado una petición y entre los partidarios de la petición ademas de incluir a Bradley M. Kuhn, fundador de Software Freedom Conservancy (SFC), tambien se encuentran otras personas de renombre, tales como Josh Simmons, presidente de la junta directiva de OSI (Open Source Initiative) y Erin Stein, directora de Data and Tech for Good.

Finalmente si estás interesado en poder conocer más al respecto, puedes consultar los detalles en el siguiente enlace.

from Linux Adictos https://ift.tt/qhnY8Df
via IFTTT

Discourse, la plataforma de debate celebra 10 años de su primer lanzamiento

Discourse

Discourse es una plataforma de debate 100 % de código abierto

Se dio a conocer el lanzamiento de la nueva versión de la plataforma Discourse 3, la cual esta diseñada para respaldar las discusiones en línea que utilizan muchos proyectos de código abierto en lugar de listas de correo, foros web y salas de chat.

Esta nueva versión incluye chat en tiempo real y estado del usuario para permitir una comunicación más informal, una barra lateral personalizable para un acceso más fácil a las cosas que más le importan a cada usuario y una nueva interfaz de notificaciones que facilita decidir qué es importante para el seguimiento. , junto con muchas otras mejoras.

Cabe mencionar que esta plataforma soporta la división de temas en base a etiquetas, envío de notificaciones sobre la aparición de respuestas a mensajes, actualización de la lista de mensajes en temas en tiempo real, carga dinámica de contenido a medida que lee, posibilidad de suscribirse a temas de interés y envío de respuestas por Email.


Con este lanzamiento también celebramos 9 años desde Discourse 1.0 , cuando nos propusimos construir una plataforma para el discurso civilizado que permitiera a las comunidades mejorar la calidad de las conversaciones en Internet. A medida que nos acercamos a una década en nuestro viaje, nuestro deseo de mejorar Discourse para diversas comunidades de todos los tamaños es más fuerte que nunca y esperamos seguir evolucionando con usted durante la próxima década.

Principales novedades de Discourse 3

En esta nueva versión que se presenta de Discourse 3 podremos encontrar que se ha agregado una implementación de chat que permite a los participantes comunicarse en tiempo real, ademas de que ahora los miembros tienen la capacidad de poder agregar categorías, etiquetas, chats al panel y que este ultimo también tiene una sección de «Comunidad» con los enlaces más utilizados.

Otro de los cambios que podremos encontrar es que se ha propuesto una nueva barra lateral configurable por el usuario, asi como tambien que se proporciona la posibilidad de exhibición por parte del usuario del estado. El estado se establece en forma de emoji o mensaje que se mostrará asociado al participante en todas las secciones de la plataforma (por ejemplo, al lado del avatar en las publicaciones, en el chat y en el perfil).

Tambien podremos encontrar que se agregó una nueva interfaz para mostrar notificaciones, lo que facilita la separación de notificaciones importantes y secundarias. Los diferentes tipos de notificaciones ahora se colocan en pestañas separadas, así como una sección general con notificaciones recientes.

Se ha propuesto un nuevo asistente de configuración inicial que le permite al usuario poder configurar los parámetros más importantes de la plataforma, como el modelo de acceso (disponible para todos o solo los usuarios registrados), el formulario de registro (para todos o solo por invitación), la necesidad de confirmar participantes , la presencia de un chat y la inclusión de una barra lateral.

De los demás cambios que se destacan

  • Se ha proporcionado la capacidad de mostrar sugerencias emergentes a los nuevos usuarios con información básica sobre las capacidades de la plataforma.
  • Se ha rediseñado el sistema de hashtags, lo que facilita el envío por nombres de canales, categorías y etiquetas.
  • Proporcionó la capacidad de definir grupos de participantes que pueden comunicarse entre sí de forma privada por separado en temas.
  • Se mejoró la interfaz de búsqueda, se agregó la capacidad de buscar rápidamente usuarios y temas en una determinada categoría adjuntando filtros «#» y «en:» a la solicitud.
  • La pila de software de la plataforma se ha actualizado: Ruby 3.1, Rails 7 y Ember 3.28.
  • Información ampliada en las páginas mostradas en caso de errores. Pantalla de inicio mejorada que aparece durante la carga.
  • Modo oscuro mejorado.

Finalmente para los interesados, deben saber que el sistema está escrito en Ruby utilizando el marco Ruby on Rails y la biblioteca Ember.js (los datos se almacenan en PostgreSQL DBMS, el caché rápido se almacena en Redis). El código se distribuye bajo la licencia GPLv2.

Ademas, tambien vale la pena mencionar que se ofrecen planes de alojamiento que van desde $25 USD en adelante, aunque como se menciono, el código de la plataforma está a disposición del publico en general en el siguiente repositorio.

Si estás interesado en poder conocer más al respecto sobre este nuevo lanzamiento, puedes consultar los detalles en la publicación original, el enlace es este.

from Linux Adictos https://ift.tt/5CohU1z
via IFTTT

LibreOffice 7.4.4 llega como nueva actualización de punto para corregir más de 100 bugs

LibreOffice 7.4.4

The Document Foundation ha lanzado hoy una nueva actualización de punto para su suite de ofimática. Lo que nos han entregado esta vez es LibreOffice 7.4.4, y con esta nos acercamos a una versión que podrán recomendar para equipos de producción. Porque esta es una actualización para su versión o canal «fresh», es decir, para la que incluye todas las novedades, pero está menos probada que la «still» que es la que se recomienda cuando necesitamos algo más fiable.

LibreOffice 7.4.4 ha llegado corrigiendo un total de 114 bugs, recogidos en las notas de la RC1 y la RC2. TDF no destaca nada como función especial, y se limita a decir qué es este software, como trabajan, que existe la versión Community para un uso personal y la Enterprise para quien necesite soporte mejorado y que para poder usarlo hace falta como mínimo Windows 7 SP1 y macOS 7; de Linux no dicen nada, en parte porque se puede instalar en cualquier distribución si su arquitectura es compatible.

LibreOffice 7.4.4 sigue sin recomendarse para equipos de producción

Para los que prefieran la fiabilidad, TDF recomienda usar LibreOffice 7.3.7, que con ya 7 actualizaciones de mantenimiento tiene dos más de las necesarias para considerarse 100% segura. Y es que entre los bugs que se corrigen, también se incluyen parches de seguridad, y cuando se llegan a numeraciones tan altas es porque se han corregido fallos importantes. Por otra parte, LibreOffice 7.4.4 ya ha recibido 4 actualizaciones de punto, pero The Document Foundation aún se esperará hasta por lo menos una más para recomendar esta serie para equipos de producción.

LibreOffice 7.4.4 ya está disponible desde su página web oficial para todos los sistemas soportados. Los usuarios de Linux también tenemos la posibilidad de instalar sus paquetes snap, flatpak (ambos por actualizar) y un repositorio para Ubuntu que pronto debería recibir los nuevos paquetes.

from Linux Adictos https://ift.tt/10ifqDt
via IFTTT

Xubuntu 23.04 llegará con una nueva imagen «minimal» de unos 700mb

Xubuntu en versión minimal

A pocos les gusta el bloatware. Casi todos los sistemas operativos del mundo vienen con lo necesario para funcionar y otras cosas que podríamos no usar nunca, por no hablar de lo que se añade por acuerdos con algunas compañías. Por ese motivo hay sistemas operativos como Manjaro que ofrece una ISO «minimal», y por el mismo Ubuntu ofrece la «instalación mínima». Xubuntu pretende ir un poco más allá que su hermano mayor, y para ello hará algo parecido a lo que hacen otros sistemas operativos.

Así lo ha anunciado Steve Langasek en un correo con el que pretende informar de manera oficial de todo esto. Lo más llamativo es el peso que tendrá esa imagen: cabrá en un CD. Ahora bien, hay que dejar claro que esta imagen minimal tendrá lo justo para funcionar con Xubuntu y su entorno gráfico; casi cualquier cosa que se quiera habrá que instalarla por nuestra cuenta, peccata minuta para los que prefieren tener sólo lo que van a usar.

La nueva imagen minimal de Xubuntu cabrá en un CD

Esto es paralelo a los objetivos de instalación mínima existentes de las imágenes de Ubuntu Desktop y Ubuntu Server para proporcionar una huella de instalación más pequeña sin aplicaciones que los desarrolladores quieren instalar como parte de la experiencia por defecto, pero que no son esenciales. A diferencia de Ubuntu Desktop y Ubuntu Server, se entrega como una imagen separada para soportar medios de instalación más pequeños (específicamente, está diseñado para caber en un CD-ROM clásico).

Tal y como destaca Langasek, esta imagen será una opción nueva diferente a lo que se ofrece ahora, que si bien es cierto que se consigue una instalación con menos software, también lo es que para conseguirlo hay que descargar la imagen entera que suele estar por encima de los 2GB.

Xubuntu 23.04 llegará en abril con Linux 6.2, las novedades base de Ubuntu y la última versión de Xfce.

from Linux Adictos https://ift.tt/3NT2IMC
via IFTTT

VK, Yandex, Sberbank y Rostelecom pretenden desarrollar su propia versión de Android

Android

La creación de su propia solución basada en Android sistema será beneficioso para las empresas

VK, Yandex, Sberbank y Rostelecom establecerán conjuntamente una nueva empresa que desarrollará una plataforma móvil rusa basada en el código base de Android.

Se menciona que sobre el proyecto, el usar Android como base permitirá mantener la compatibilidad con una gran cantidad de aplicaciones ya lanzadas. La plataforma se diseñará para el segmento de consumidores, mientras que el sistema operativo Aurora que ya está desarrollando Rostelecom en la base de código de Sailfish se destinará a su uso en agencias gubernamentales y corporaciones.

El desarrollo de un nuevo sistema operativo por parte de un grupo no contradice los planes de Rostelecom de desarrollar un ecosistema móvil basado en el sistema operativo Aurora, que, según una fuente de Kommersant en el gobierno, se utilizará en el sector público y corporativo «para trabajar con datos confidenciales”: “El nuevo sistema operativo apuntará al segmento de consumidores.

En diciembre, el gobierno incluyó el proyecto de Rostelecom para crear un ecosistema móvil nacional basado en el sistema operativo Aurora para 2030 en la hoja de ruta del nuevo software del sistema general. El costo del proyecto, que incluye la producción de 70 millones de dispositivos, fue estimado por el operador en 480 mil millones de rublos hasta 2030.

Las autoridades rusas, después de haber decidido apoyar el desarrollo de un nuevo sistema operativo basado en Android, en realidad están siguiendo el camino de Huawei. Cuando la empresa perdió su asociación con Google en 2018, al caer bajo las sanciones de EE. UU., comenzó a desarrollar el sistema operativo Harmony basado en Android abierto, la tienda de aplicaciones AppGallery y la plataforma Huawei Mobile Service (HMS). En 2021, la cantidad de usuarios de AppGallery alcanzó los 580 millones, en general, 730 millones de personas usan los servicios HMS y 5 millones de desarrolladores están involucrados en su creación

Para la plataforma, planean desarrollar análogos de aplicaciones y servicios propietarios del conjunto de servicios móviles de Google (GMS), lo que permitirá deshacerse del vínculo con los servicios y la infraestructura de Google.

Por ejemplo, se pueden implementar servicios propios para la entrega de actualizaciones, distribución de software, ubicación, sincronización de tiempo, DNS, almacenamiento de copias de seguridad y sincronización de archivos, así como análogos para aplicaciones como Google Search, Chrome, YouTube, Google Play, Google Drive, Gmail. ., Google Maps, Google Photos, Google TV y YouTube Music. Vale la pena señalar que una tarea similar de crear ediciones de Android que no estén vinculadas a los servicios y aplicaciones de Google ya está siendo resuelta por proyectos abiertos como microG, CalyxOS ,/e/OS y ​​LineageOS para microG.

Lanzar una plataforma de servicios móviles para un sistema operativo basado en Android abierto será más fácil que para el sistema operativo Aurora, dice una de las fuentes de Kommersant. La mayoría de las aplicaciones de los desarrolladores rusos ya se han adaptado para Android, y su adaptación a Aurora requerirá tiempo e inversión:

“Por lo tanto, para el segmento de consumidores de teléfonos inteligentes y tabletas, se decidió hacer un sistema operativo en Android, especialmente desde el complemento principal, a saber, la tienda de aplicaciones RuStore, ya se ha lanzado VK. Cómo el gobierno está explorando el potencial de los sistemas operativos móviles en ausencia del exterior

El desarrollo de un ecosistema basado en Android abierto costará varias veces más barato que el proyecto Rostelecom

“Dicho sistema operativo podrá recibir actualizaciones de seguridad de Android, como Huawei, están disponibles para gratis en el sitio web de Google, como el propio sistema». En su opinión, sería aún más fácil negociar con Huawei sobre el uso de sus bibliotecas de desarrollo móvil en RuStore. Una fuente de Kommersant en el mercado electrónico ruso agrega que no llevará más de un año desarrollar un sistema operativo basado en Android: «Esta es una tarea factible si las empresas combinan experiencia».

Nikolai Komlev, director de la Asociación de Empresas de Tecnología Informática y de la Información, considera exitosa la idea de desarrollar diferentes sistemas operativos móviles para el mercado de consumo y el sector público:

“La plataforma que ejecuta Aurora OS se puede implementar en instituciones donde hay altos requisitos para la seguridad de los datos, por ejemplo, en las agencias de aplicación de la ley y las corporaciones estatales». En este sentido, sería adecuada la armonización de Aurora con dispositivos sobre procesadores domésticos, añade el experto.

Fuente: https://sputniknews.com/

from Linux Adictos https://ift.tt/WXjmHru
via IFTTT

Privaxy, un proxy de bloqueo de anuncios

privaxy

Un proxy bloqueador de publicidad

Hoy en día una de las principales preocupaciones de los usuarios en la red es el tema relacionado con la privacidad de su información y ante ello existen una gran cantidad de soluciones que van desde las implementadas por los propios navegadores web, hasta opciones como usar aplicaciones de terceros entre otras cosas.

El día de hoy hablaremos sobre Privaxy el cual es un proxy de bloqueo de anuncios y un código de seguimiento entre sitios.

Privaxy recientemente se actualizo a su versión 0.5 y puedo mencionar que es un proxy MITM HTTP(s) que se encuentra entre las aplicaciones de conversación HTTP(s), como un navegador web y los servidores HTTP, como los sitios web de servicio. Al establecer un túnel bidireccional entre ambos extremos, Privaxy puede bloquear solicitudes de red basadas en patrones de URL e inyectar scripts y estilos en documentos HTML.

Operando a un nivel más bajo, Privaxy es más eficiente y más optimizado que los bloqueadores basados ​​en complementos del navegador. Una sola instancia de Privaxy en una pequeña máquina virtual, servidor o incluso, en la misma computadora desde la que se origina el tráfico, puede filtrar miles de solicitudes por segundo y requiere una cantidad muy pequeña de memoria.

La implementación del bloqueador es en forma de un servidor proxy separado que permite usarlo como una solución universal que le permite al usuario filtrar solicitudes no solo de los navegadores web. El proxy también es independiente de las restricciones del navegador, como las impuestas por la tercera versión del manifiesto de Chrome, y proporciona un mejor rendimiento y menores requisitos de recursos.

Por ejemplo, al cargar 320 mil filtros, el consumo de memoria es de 50 MB y es posible filtrar miles de solicitudes por segundo.

La forma en que funciona Privaxy es implementar un filtro intermedio entre el usuario y los sitios, utilizando la suplantación de identidad del certificado TLS para interceptar el contenido de las sesiones HTTPS cifradas y ocultar la advertencia MITM.

Privaxy genera su propio certificado, que el usuario instala en el almacén de certificados de su sistema (/usr/local/share/ca-certificates/) y prescribe el funcionamiento de las aplicaciones a través del proxy localhost:8100. Se proporcionan dos opciones de compilación: una utilidad de consola y una interfaz gráfica que le permite administrar la configuración, realizar un seguimiento visual de la actividad actual y ver las estadísticas de bloqueo.

Cuando se recibe una solicitud HTTPS de un usuario, Privaxy establece una conexión TLS con el servidor de destino en su propio nombre y obtiene su certificado, después de lo cual utiliza el nombre de host del certificado real recibido del servidor y crea un certificado ficticio vinculado por un cadena de confianza al certificado raíz generado para el usuario.

Usando un certificado ficticio, el proxy se hace pasar por el servidor solicitado cuando se comunica con el cliente, mientras continúa usando la conexión TLS establecida con el servidor de destino para recibir datos. Para hosts y dominios seleccionados, es posible deshabilitar el reenvío utilizando la técnica MITM.

Además de eliminar los anuncios en función de las máscaras de URL, Privaxy también ofrece la posibilidad de insertar código JavaScript y estilos CSS en documentos HTML renderizados.

Se admiten filtros compatibles con Adblock Plus, como Easylist . La sustitución de contenido admite la sintaxis de uBlock Origin para secuencias de comandos, controladores y redireccionamientos, así como su propia sintaxis para configurar filtros personalizados arbitrarios. Las listas externas conectadas con filtros se actualizan automáticamente.

De las características que se destacan de Privaxy:

  • Soporte para filtros Adblock Plus, como easylist
  • Interfaz gráfica de usuario web con una pantalla de estadísticas, así como un explorador de solicitudes en vivo.
  • Soporte para la sintaxis de origen de uBlock js.
  • Soporte para la sintaxis de origen de uBlock redirect.
  • Soporte para scriptlets de uBlock origin.
  • Independiente del navegador y del cliente HTTP.
  • Soporte para filtros personalizados.
  • Compatibilidad con la exclusión de hosts de la canalización de MITM.
  • Compatibilidad con actualizaciones de protocolo, como con websockets.
  • Actualizaciones automáticas de listas de filtros.
  • Muy bajo consumo de recursos.
  • Alrededor de 50 MB de memoria con aproximadamente 320 000 filtros habilitados.
  • Capaz de filtrar miles de solicitudes por segundo en una máquina pequeña.

Finalmente si estás interesado en poder conocer más al respecto, puedes consultar los detalles en el siguiente enlace.

El código del proyecto está escrito en Rust y se distribuye bajo la licencia AGPLv3 y se brindan compilaciones preparadas para Linux (AppImage, deb), Windows y macOS.

from Linux Adictos https://ift.tt/8zfgosV
via IFTTT

PostgREST: un webserver y API RESTful para cualquier base de datos PostgreSQL

PostgREST

PostgREST sirve una API RESTful completa desde cualquier base de datos PostgreSQL existente. Proporciona una API más limpia, más compatible

El día de hoy vamos a hablar sobre PostgREST, el cual es un servidor web independiente que transforma una base de datos PostgreSQL directamente en una API RESTful. Las restricciones estructurales y los permisos de la base de datos determinan los puntos finales y las operaciones de la API.

Según sus diseñadores, usar PostgREST es una alternativa a la programación CRUD manual. Recuerde que el acrónimo informático inglés CRUD (Create, Read, Update, Delete) designa las cuatro operaciones básicas para la persistencia de datos, en particular el almacenamiento de información en una base de datos.

“PostgREST es potente, estable y transparente. Nos permite iniciar proyectos muy rápidamente y centrarnos en nuestros datos y aplicaciones en lugar de construir la capa ORM. En nuestro clúster k8s, ejecutamos algunos pods por esquema que queremos exponer y escalamos hacia arriba o hacia abajo según la demanda. 

Para quienes desconocen de PostgreSQL, deben saber que este es un sistema de administración de datos conocido por su confiabilidad y robustez, se beneficia de más de 25 años de desarrollo de código abierto por parte de una comunidad global de desarrolladores. Es uno de los sistemas de gestión de bases de datos de código abierto más avanzados. Es rico en funciones, con tipos de datos robustos, indexación potente y una amplia gama de funciones integradas que se pueden usar para simplificar la pila de datos y permitir que los desarrolladores se centren en crear su aplicación.

PostgREST tiene un alcance específico, ademas de que funciona bien con otras herramientas como el servidor web Nginx. Esto obliga a una clara separación de las operaciones CRUD centradas en datos de otras preocupaciones.

PostgREST maneja la autenticación (a través de JSON Web Tokens) y delega la autorización a la información del rol definida en la base de datos. Esto asegura que solo haya una fuente declarativa de verdad para la seguridad.

Al tratar con la base de datos, el servidor asume la identidad del usuario autenticado actualmente y durante la conexión no puede hacer nada que el propio usuario no pueda hacer. Se pueden construir otras formas de autenticación en la primitiva JWT.

Por otro lado, cuando se trata de la integridad de los datos, PostgREST en lugar de confiar en un Object Relational Mapper (ORM) y una codificación imperativa personalizada, este sistema impone restricciones declarativas directamente en su base de datos.

Con PostgREST, no se involucra ORM (mapeo relacional de objetos), ademas de que la creación de nuevas vistas se realiza en SQL, con conocidas consecuencias sobre el rendimiento. Un administrador de base de datos ahora puede crear una API desde cero, sin programación personalizada.

El ORM es un tipo de programa informático que se coloca como interfaz entre un programa de aplicación y una base de datos relacional para simular una base de datos orientada a objetos. Este programa define correspondencias entre los esquemas de la base de datos y las clases del programa de aplicación.

Finalmente si estás interesado en poder conocer más al respecto, puedes consultar los detalles en el siguiente enlace.

¿Como instalar PostgREST en Linux?

La versión 10.1.1 se lanzó en noviembre pasado con nuevas adiciones y algunos cambios. Esta versión se puede obtener desde github. El enlace es este.

De igual forma, para quienes estén interesados en poder instalar PostgREST, deben saber que se puede obtener la actual versión en estos momentos con ayuda de una terminan. Solo en ella vamos a teclear:

wget https://github.com/PostgREST/postgrest/releases/download/v10.1.1/postgrest-v10.1.1-linux-static-x64.tar.xz

Ahora solo deben de descomprimir el paquete con el siguiente comando:

tar Jxf postgrest-v10.1.1-linux-static-x64.tar.xz

Mientras que para el caso en especial de los que utilizan una versión de Ubuntu de 64 bits:

wget https://github.com/PostgREST/postgrest/releases/download/v10.1.1/postgrest-v10.1.1-ubuntu-aarch64.tar.xz
tar Jxf postgrest-v10.1.1-ubuntu-aarch64.tar.xz

Y pueden ejecutar con:

./postgrest --help

Otro método de instalación, es con una imagen de Docker que está preparada, esta la pueden obtener tecleando:

docker pull postgrest/postgrest

Finalmente pueden obtener más información sobre la configuración de ello, desde la documentación en su página web. El enlace es este.

from Linux Adictos https://ift.tt/YtaqKgQ
via IFTTT

Cómo instalar LibreOffice en Ubuntu desde su repositorio, para los que prefieran escapar de la versión snap

LibreOffice en Ubuntu

Instalas Ubuntu, eliges la instalación mínima para controlar un poco el bloatware, vas a instalar LibreOffice, abres GNOME Software porque quieres evitar las restricciones de Canonical y su Ubuntu Software… ¿y dónde está la versión DEB? Junto a Firefox: ya no está. Se puede buscar en Ubuntu Software, GNOME Software o con apt install, pero no aparece. Canonical no ofrece la suite en sus repositorios oficiales, por lo que lo mejor es hacer lo que se hacía antaño: añadir un repositorio.

Hace mucho tiempo que The Document Foundation ofrece las versiones flatpak y snap de LibreOffice. También hace mucho que hay disponible un repositorio para sistemas operativos basados en Ubuntu, pero que venga instalado por defecto en los sistemas de Canonical, si se instala la versión «normal», hace que muchos ni pensemos en estas cosas. Pero el repositorio existe, y aquí te vamos a explicar cómo añadirlo y usarlo.

Añadir el repositorio de LibreOffice y actualizarlo a la última versión

Antes de indicar los comandos, hay que explicar qué se instala al añadir el repositorio. The Document Foundation ofrece, además de las versiones beta, rc y demás, dos versiones estables de su suite de ofimática: la «still», que es el nombre que le dan a la «refrenada» más probada, y la «fresh», que es la versión más actualizada, actualmente v7.4.3. Lo que hay en este repositorio es la «fresh».

Explicado esto, los comandos a escribir son:

sudo add-apt-repository ppa:libreoffice/ppa
sudo apt update && sudo apt upgrade && sudo apt install libreoffice libreoffice-l10n-es

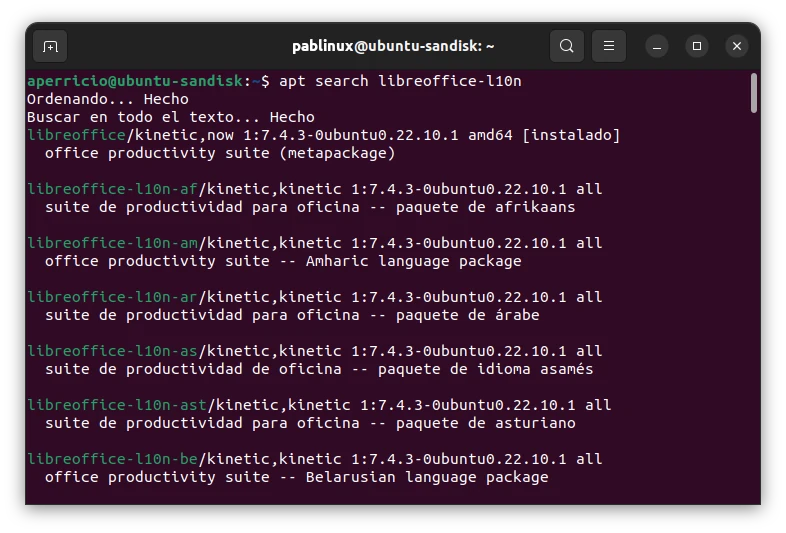
libreoffice-l10n-es es el paquete necesario para que LibreOffice esté en español; se puede cambiar por otro. Para ver los idiomas disponibles, se pueden buscar en Synaptic (sudo apt install synaptic) o desde el mismo terminal con el comando apt search libreoffice-10n.

instalar idiomas a libreoffice

Y eso sería todo. Al final, como hemos explicado, es lo que se hacía antes de que tanto y tanto software apareciera en los repositorios oficiales. Con unos pasos tan sencillos, LibreOffice instalado, y en DEB.

from Linux Adictos https://ift.tt/HNTU8su
via IFTTT