When a down-on-his-luck basketball scout finds a potential superstar in Spain, he sets out to prove they both have what it takes to make it in the NBA.
from New On Netflix USA https://ift.tt/Z2ecYEU
via IFTTT

When a down-on-his-luck basketball scout finds a potential superstar in Spain, he sets out to prove they both have what it takes to make it in the NBA.
from New On Netflix USA https://ift.tt/Z2ecYEU
via IFTTT
This docuseries examines the rise of Warren Jeffs in the Fundamentalist Church of Jesus Christ of Latter-Day Saints and his shocking criminal case.
from New On Netflix USA https://ift.tt/PmxnjGf
via IFTTT
When a fertility doctor drunkenly inseminates herself with her ex-boyfriend’s sperm, she scrambles to explain her pregnancy — and win back her lost love.
from New On Netflix USA https://ift.tt/ktKlRvE
via IFTTT
A pesar de sus desventajas con respecto a sus competidores, WhatsApp sigue siendo la aplicación de mensajería más utiilizada.
(adsbygoogle = window.adsbygoogle || []).push({});
Nos guste o no, WhatsApp es el medio de comunicación más usado en la actualidad. Y, aunque los servicios de la competencia sean mejores y, más respetuosos de la privacidad de los usuarios, estamos obligados a usar lo que usa la mayoría a menos que nos resignemos a perder clientes o no enterarnos de lo que sucede alrededor. Preguntadle sino a los fanáticos del software libre que solo hablaban con Softphone Ekiga.
Es por eso que. en este artículo vamos a ver cómo instalar WhatsApp en Ubuntu.
(adsbygoogle = window.adsbygoogle || []).push({});
Para entender cómo instalar WhatsApp en Ubuntu y las limitaciones y dificultades que nos enfrentamos al hacerlo, necesitamos primero entender qué es.
WhatsApp Messenger es un servicio de mensajería instantánea y de voz sobre IP propiedad de Meta (la empresa madre de Facebook e Instagram). Se usa para enviar mensajes de texto y mensajes de voz, realizar llamadas de voz y video, y compartir imágenes, documentos, ubicaciones de usuarios y otro contenido.
La utilización principal es mediante aplicaciones para dispositivos móviles, una dirigida a los usuarios normales y otra a los comerciales, siendo en ambos casos el servicio gratuito. Aunque se puede acceder al servicio desde computadoras de escritorio, se requiere un número de teléfono móvil celular para registrarse.
(adsbygoogle = window.adsbygoogle || []).push({});
Quienes seleccionaron la versión business pueden utilizar la versión web sin necesidad de que el teléfono móvil esté conectado, aunque seguirán necesitándolo para acceder por primera vez.
Esto nos lleva al punto clave. No hay una forma de instalar WhatsApp en Ubuntu. Dado que Meta está decidido a hacer rentable el servicio y no puede cobrar por utilizarlo ya que se irían todos a Telegram, lo que hace es restringir el acceso a sus API’s (interfaz de programación de aplicaciones) lo que impide la creación de aplicaciones de terceros a menos que pases por caja.
Lo que podemos hacer es optar por alguna de las siguientes alternativas:

Para usar WhatsApp Web tenemos que escanear el código de pantalla en el móvil. El móvil deberá permanecer conectado a la red.
(adsbygoogle = window.adsbygoogle || []).push({});
Para esto solo tenemos que abrir el navegador e ir a esta página.
La página nos mostrará un código QR que deberás escanear con el teléfono. Lo hacemos de esta manera:
Cuando la aplicación del teléfono lea el código veremos en la pantalla del navegador un aviso de que está sincronizando. Cuando termine verás los mensajes.
La versión web tarda mucho en iniciar y, como te dije más arriba necesitaremos tener el móvil conectado para ver los mensajes. Sin embargo, la versión Business nos ofrece en fase de prueba la opción de ver sin conexión.
Te recomiendo limpiar el monitor y conseguirte un teléfono con una buena cámara. Caso contrario el proceso de sincronización es una verdadera tortura.
Las aplicaciones web no son más que un navegador que abren una sola página (en este caso la de WhatsApp Web) por lo que la única ventaja es que pulsamos sobre un icono y ya tenemos WhatsApp, pero, deberémos pasar por el procedimiento de escanear el código QR y tener conectado el teléfono.
Algunas aplicaciones web son:
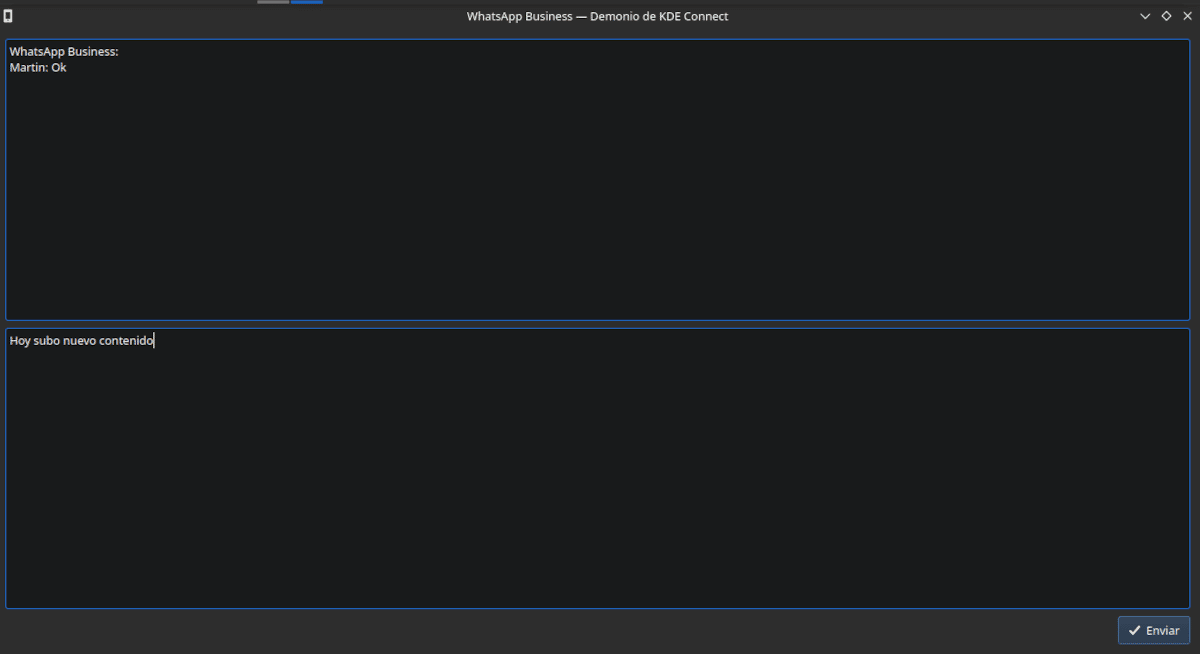
Con KDE Connect podemos hacer que el móvil nos envíe las notificaciones de WhatsApp al ordenador y responderlas.
Si en algo le gana el software libre al privativo, es en las aplicaciones que permiten conectar el móvil al ordenador para que interactuemos. En este caso hay dos títulos que se destacan. Scrcpy y KDE Connect.
Scrcpy nos permite establecer conexión con el móvil en forma inalámbrica o conectada. Este programa se consigue en los repositorios o en la tienda de Snap.
Primero debemos habilitar las opciones de programador en el móvil. Para esto tendremos que ir a la sección de la configuración donde está el número de compilación de Android y presionarlo siete veces. Luego vamos a Sistema → Opciones avanzadas (Puede estar en otra ubicación) y pulsa en Opciones para programadores. Activamos la depuración por USB.
En el teléfono se abrirá una ventana que te autoriza a establecer la conexión.
Una vez hecho esto verás aparecer la pantalla de tu teléfono en el monitor del ordenador. Solo tienes que pulsar con el ratón en el icono de WhatsApp para abrir la aplicación. Si bien podremos escribir con el teclado del ordenador., no funcionan los caracteres españoles como la ñ o ¿, para usarlos deberemos presionar en el teclado en pantalla con el ratón.
Está en los repositorios de las distribuciones basadas en KDE y existe una versión GNOME que se instala como extensión. La aplicación móvil la puedes instalar desde la App Store de Android o (mi recomendación) desde F-Droid.
Una vez con el ordenador y el teléfono conectados a la misma red, iniciamos ambas aplicaciones y desde el móvil damos los permisos necesarios. Cuando llegue un mensaje veremos la notificación y tendremos la posibilidad de responderlo.

Utilizando Anbox podemos ejecutar Android en un contenedor e instalarle Anbox.
Este método es completamente desaconsejable. No solo porque resulta un desperdicio de recursos de nuestro ordenador, sino porque ya no tendremos disponible WhatsApp en el móvil. Al menos con el número que estamos usando.
Anbox, es una aplicación gratuita y de código abierto para ejecutar aplicaciones de Android en Linux. Se basa en la última versión del Proyecto de código abierto de Android (AOSP) y ofrece un entorno de Android basado en ventanas. Utiliza la tecnología de contenedores para ejecutar el sistema operativo del teléfono.
Podemos instalarlo con:
sudo snap install --devmode --beta anbox
A continuación, comprobamos que tenemos las dependencias necesarias
sudo modprobe ashmem_linux

sudo modprobe binder_linux

lsmod | grep -e ashmem_linux -e binder_linux
Si no lo están
sudo apt install mokutil

sudo mokutil --sb-state
Reiniciamos el sistema.
sudo reboot
Ahora instalamos la tienda de aplicaciones de Google:
Conseguimos las dependencias
sudo apt install wget curl lzip tar unzip squashfs-tools
Descargamos el script de instalación
wget https://raw.githubusercontent.com/geeks-r-us/anbox-playstore-installer/master/install-playstore.sh
Lo hacemos ejecutable
chmod +x install-playstore.sh
Lo ejecutamos
./install-playstore.sh
Es posible que Anbox no se conecte a la red. Esto lo solucionamos con el siguiente procedimiento
Reseteamos Anbox
sudo systemctl restart snap.anbox.container-manager.service
Copiamos y pegamos el código de esta página en un archivo de texto y lo guardamos como bridge.sh
Damos permisos.
chmod +x bridge.sh
Ejecutamos con
sudo ./bridge.sh
Deberemos hacer lo mismo cada vez que reinicies sesión.
Luego reiniciamos Anbox y pulsamos en Settings. A continuación, vamos a Google Play Services y Google Play y pulsando en Permissions se los damos.
A continuación, cerramos la ventana, pulsamos en el símbolo de Google Play, iniciamos sesión e instalamos WhatsApp con el procedimiento habitual. Necesitaremos un teléfono móvil para recibir el código de autenticación.
Cómo dije más arriba, los propietarios de WhatsApp exigen que si quieres crear tus propias soluciones para usar la red de WhatsApp tienes que pagar. Aunque de vez en cuando aparecen en GitHub soluciones parciales construidas en base a ingeniería inversa, no funcionan durante demasiado tiempo. Lo que si suele funcionar mejor es un conjunto de bibliotecas basadas en Python que interactúan con WhatsApp Web ejecutada desde el navegador. He probado un par y he tenido un éxito parcial, pero nada que justifique la complicada configuración. Si sientes curiosidad dale una mirada a WhatsApp-web 0.01 y a Auto-whatsapp 0.0.5.
Para mí, la más práctica es WhatsApp Web, las otras opciones exigen demasiado tiempo, recursos o aportan muy poco.
from Linux Adictos https://ift.tt/WFZxeXj
via IFTTT
(adsbygoogle = window.adsbygoogle || []).push({});
Proporcionamos una serie de utilidades, incluyendo herramientas para aumentar su productividad, ayudarle a gestionar su flujo de trabajo y mucho más. La tabla al final de esta página enumera las utilidades de esta serie. Aunque Google controla el escritorio, sus productos y servicios están muy extendidos, no nos malinterpretes. Hace tiempo que somos fans de varios artículos y servicios de Google. A pesar de todas sus ventajas, confiar en una empresa concreta tiene sus desventajas. Las ofertas de Google suelen ser de gran calidad, sencillas de usar y «gratuitas», pero hay problemas con sus políticas de privacidad, los comportamientos de la empresa y su deseo de manipular todos nuestros datos en todo momento. Un ejemplo de preocupación con sus políticas de privacidad es que si quieres escapar del ecosistema de Google y avanzar hacia la libertad en línea, donde no serás continuamente rastreado, monetizado y conectado al ecosistema de Google, puede que quieras probar Whoogle Search. Tiene exactamente los mismos resultados que Google Search pero con mucha más privacidad.
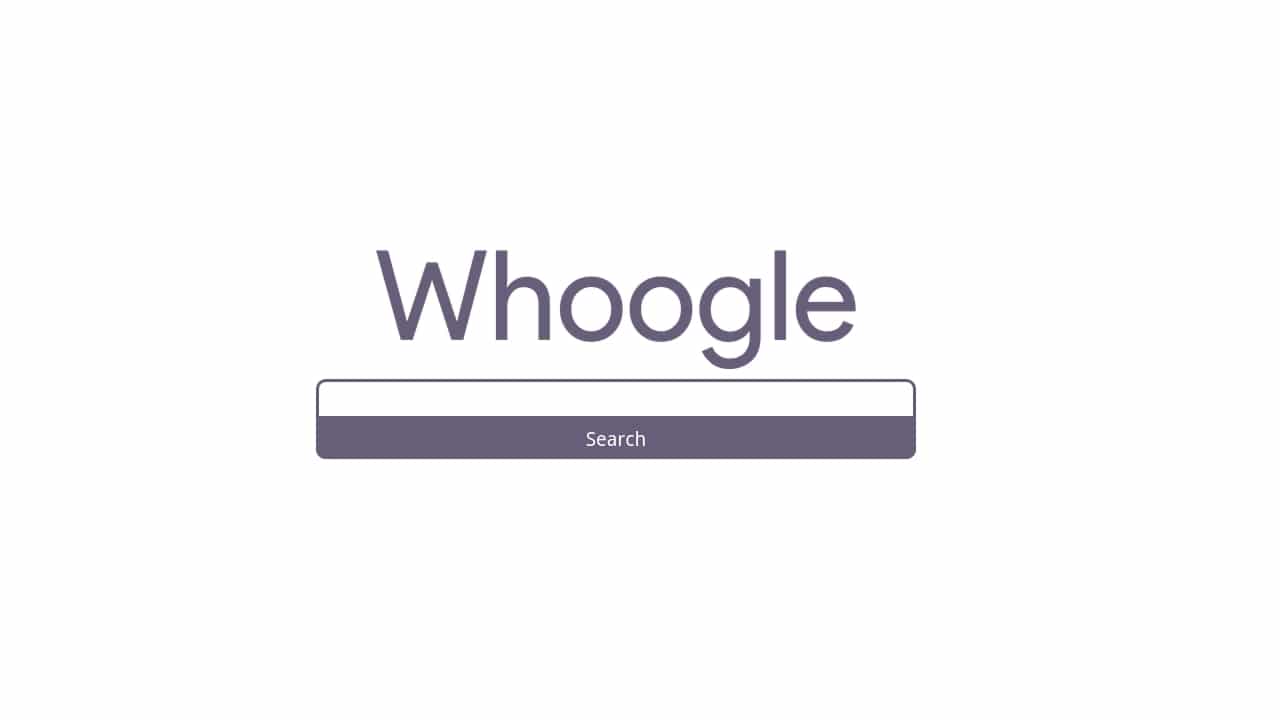
Whoogle Search es un motor de búsqueda centrado en la privacidad. Muestra los mismos resultados que la Búsqueda de Google, pero sin anuncios/contenido patrocinado, JavaScript, cookies ni seguimiento.
(adsbygoogle = window.adsbygoogle || []).push({});
Para poder probar este Whoogle Search, lo primero que hay que hacer es instalarlo, para ello debemos usar Docker, que deberás tener instalado en tu sistema previamente para que funcionen los siguientes comandos:
docker pull benbusby/whoogle-search
Después de esto, el siguiente comando que hay que ejecutar es:
docker run --publish 5000:5000 --detach --name whoogle-search benbusby/whoogle-search:latest
Una vez hecho esto, ya podremos probar en nuestro navegador web favorito cómo funciona Whoogle. Para ello, tan solo tienes que poner la siguiente URL en la barra de direcciones del navegador web:
(adsbygoogle = window.adsbygoogle || []).push({});
Entonces te aparecerá el logo del bsucador y la barra de búsqueda para comenzar a usarlo. También tienes varios ajustes como el idioma de la interfaz, idioma de búsqueda, etc.
Más información – Sitio de GitHub
from Linux Adictos https://ift.tt/ilm6DCu
via IFTTT

By Tiffany Hsu
A picture of Jordie Jordan, an online gamer, has been attached to a fake name and numerous bogus reports of his death, including from the mass shootings in Uvalde, Texas.
Published: June 6, 2022 at 07:00PM
from NYT Technology https://ift.tt/R9s2fAe
via IFTTT
European lawmakers have mandated that mobile devices (looking at you, Apple) must charge using the same standard connector cable.
from Gear Latest https://ift.tt/xC9K5hf
via IFTTT
Los superordenadores superan largamente la velocidad de cálculo de los de escritorio.
(adsbygoogle = window.adsbygoogle || []).push({});
Todos los años en Linux Adictos nos hacemos eco de la publicación de la lista de los 500 mayores superordenadores del mundo. Y, en un artículo anterior te conté sobre Frontier, el que en este momento no solo es el más rápido del mundo sino también el de mejor rendimiento del mundo.
Como siempre es interesante saber de qué forma llegamos hasta aquí, vamos con una breve historia de los superordenadores.
(adsbygoogle = window.adsbygoogle || []).push({});
Es un equipo capaz de ejecutar cálculos largos y complejos a una velocidad enorme. El rendimiento de una supercomputadora se mide comúnmente en operaciones de punto flotante por segundo (FLOPS) en lugar de millones de instrucciones por segundo (MIPS).
Las supercomputadoras se utilizan en un amplio campo de actividades que necesitan un uso intensivo del cálculo como la mecánica cuántica, el pronóstico del tiempo, la investigación climática, la exploración de petróleo y gas, el modelado molecular (computar las estructuras y propiedades de compuestos químicos, macromoléculas biológicas, polímeros y cristales) y simulaciones de física teórica del tipo de las simulaciones de los primeros momentos del universo, aerodinámica de aviones y naves espaciales, detonación de armas nucleares y fusión nuclear. También en la creación y rompimiento de métodos de cifrados seguros.
En 1956, un equipo de la Universidad de Manchester en el Reino Unido comenzó a desarrollar MUSE. Su objetivo era construir una computadora que pudiera operar a velocidades de procesamiento cercanas a un microsegundo por instrucción, es decir alrededor de un millón de instrucciones por segundo Póco tiempo después se cambió el nombre del proyecto por el de Atlas.
(adsbygoogle = window.adsbygoogle || []).push({});
El primer Atlas se encargó oficialmente el 7 de diciembre de 1962 y fue considerado en el momento de su puesta en marcha como el ordenador más potente del mundo, El Atlas fue pionero en el uso de la memoria virtual y la paginación como una forma de ampliar su memoria de trabajo mediante la combinación de sus 16 384 palabras de memoria principal y 96 000 palabras adicionales de memoria de batería secundaria.
El primer ordenador que provino de una empresa privada fue de una compañía fundada en 1957 por un grupo de ingenieros en computación entre los que se encontraba Seymour Cray quién después se convertiría en una de las personalidades más destacadas de la industria. La empresa se llamó Control Data Corporation y produjo un ordenador llamado CDC 6000 que se componía de cuatrocientos mil transistores, cien millas de cableado, un novedoso sistema de enfriado y una potencia de cálculo record para la época de 3 megaFLOPS. Este ordenador apareció en 1964
El secreto de la velocidad del CDC 6600 estaba en su capacidad de compartir trabajo con los periféricos permitiendo que la CPU se dedicará únicamente al procesamiento de datos. El lenguaje de programación era FORTRAN.
En 1968, Cray produjo la CDC 7600 que también logró el título del ordenador más veloz del mundo. Funcionando a 36 MHz, el 7600 tenía 3,6 veces la velocidad de reloj del 6600, pero, no tuvo el éxito comercial esperado y Cray dejó CDC en 1972 para formar su propia empresa.
(adsbygoogle = window.adsbygoogle || []).push({});
Sin su participación, CDC produjo el STAR-100 con una velocidad de 100 megaFLOPS, es decir tres veces más la velocidad de su antecesor. y utilizaba el llamado procesamiento vectorial, es decir que la CPU estaba diseñada para realizar múltiples cálculos matemáticos en forma simultánea.
Ya en su propia compañía, Seymour Cray produjo tres modelos
Como muchos otros pioneros, Cray no supo detectar el cambio de paradigma y su compañía presentó quiebra en 1995. Mientras tanto sus competidores abrazaban el actual modelo de computación paralela en el que una tarea se divide entre dos o más procesadores que se encargan de resolverla en forma simultánea.
from Linux Adictos https://ift.tt/bZWEFUr
via IFTTT
El ordenador más lento del mundo operará un reloj destinado a durar 10000 años
(adsbygoogle = window.adsbygoogle || []).push({});
En un artículo anterior te contaba la historia del que hasta este momento es el ordenador más rápido del mundo. Ahora vamos a ver la historia del que según Google es más lenta que, curiosamente comparten un mismo pionero.
La universidad de Tel Aviv entrega todos los años el premio Dan David que se reparte en tres categorías; pasado, presente y futuro. En la edición del año 2002, el galardonado en la categoría «Presente» fue para el doctor Daniel Hill, el primero en crear un ordenador utilizando la tecnología de procesamiento paralelo que hoy utilizan los superordenadores de todo el mundo. En los comienzos de la década del ochenta, Hill demostró que era posible que un ordenador funcionara con varios procesadores en paralelo. Fue en 1985, mientras trabajaba en su doctorado, que construyó para una empresa privada uno que utilizaba 64000 procesadores.
(adsbygoogle = window.adsbygoogle || []).push({});
Sin embargo, al momento de recibir el premio, Hill parecía haber perdido interés en el tema.
La informatización paralela se ha convertido en una forma muy común de informatización así que, en lo que a mí respecta, el tema se ha agotado.
Toda mi contribución a este campo fue para probar que la informatización paralela era bastante simple y no tan complicado como se pensaba anteriormente
En 1996 se creó el fondo Long Now destinado a financiar la construcción de un reloj de 20 metros en lo alto de la cumbre de la Montaña de la Serpiente en el Parque Nacional Great Basin en el desierto de Nevada. La montaña ya había sido adquirida por un fondo especial. establecido por Mitch Kapor, fundador de la desaparecida compañía de software Lotus, la la familia Jay Walker, creadores de Priceline y Bill Joy, fundador de Sun Microsystem. Esta montaña se eligió porque su cumbre se eleva a una altura de 3.000 metros y está rodeada de un bosque de pinos centenarios, algunos de los cuales superan los 4.900 años.
En el momento de recibir el premio, Hill estaba construyendo un prototipo de dicho reloj, destinado a funcionar nada menos que por 10000 años. Sus planes incluían construirlo completamente de bronce, un material que el hombre conoce hace miles de años. Este reloj será controlado por el ordenador más lento del mundo que puede trabajar con 5 dígitos (Recordemos que tiene que mostrar la fecha después del año 10000) y será operado por lo que se describe como un movimiento mecánico, enorme, voluminoso y preciso. El ordenador será responsable de una precisión de un día cada 20000 años.
(adsbygoogle = window.adsbygoogle || []).push({});
Forma parte de un proyecto de la Long Now Foundation, una entidad sinfines de lucro que busca fomentar el pensamiento a (Muy) largo plazo. A lo que ellos denominan a «escala de civilización».
El reloj, que todavía no fue terminado se llama «Reloj del largo ahora» y como dije más arriba, tendrá escala de monumento, estará construido dentro de una montaña y estará pensado para mantener la hora exacta durante los próximos diez milenios. Cuando esté funcionando requerirá un mantenimiento mínimo y funcionará con energía mecánica recolectada de la luz solar y de las personas que lo visiten.
El Reloj marcará el tiempo con pantallas astronómicas y calendáricas y un generador de campanas diseñado por el compositor Brian Eno que tocará más de 3,5 millones de secuencias únicas de campanadas, una por cada día que se visite el Reloj durante los próximos 10.000 años.
Diez mil años es aproximadamente la edad de la civilización moderna, por lo que el reloj medirá un futuro de civilización igual a su pasado. Esto supone que nuestra civilización está en medio de cualquier viaje en el que estemos, lo que los promotores del proyecto califican como una «muestra de optimismo»
(adsbygoogle = window.adsbygoogle || []).push({});
De la web del proyecto
¿Por qué alguien construiría un reloj dentro de una montaña con la esperanza de que suene durante 10.000 años?
Parte de la respuesta: solo para que la gente haga esta pregunta, y habiéndola hecho, se inciten a conjurar con nociones de generaciones y milenios. Si tiene un reloj en marcha durante 10,000 años, ¿qué tipo de preguntas y proyectos a escala generacional sugerirá? Si un reloj puede seguir funcionando durante diez milenios, ¿no deberíamos asegurarnos de que nuestra civilización también lo haga? Si El Reloj sigue funcionando después de que llevamos mucho tiempo muertos, ¿por qué no intentar otros proyectos que requieren que las generaciones futuras terminen?
La pregunta más importante es, como preguntó una vez el virólogo Jonas Salk: «¿Estamos siendo buenos antepasados?»
from Linux Adictos https://ift.tt/4dDbgv3
via IFTTT
(adsbygoogle = window.adsbygoogle || []).push({});
Hace poco el IETF (Grupo de Trabajo de Ingeniería de Internet), que desarrolla los protocolos y la arquitectura de Internet, dio a conocer la noticia de que completó la formación del RFC para el protocolo HTTP/3.0 y publicó las especificaciones relacionadas bajo los identificadores RFC 9114 y RFC 9204.
La especificación HTTP/3.0 recibió el estado de «Estándar propuesto», después de lo cual se comenzará a trabajar para darle a RFC el estado de un borrador de estándar (Draft Standard), lo que en realidad significa una estabilización completa del protocolo y teniendo en cuenta todos los comentarios realizados.
(adsbygoogle = window.adsbygoogle || []).push({});
El protocolo HTTP/3 define el uso del protocolo QUIC (Quick UDP Internet Connections) como transporte para HTTP/2. QUIC es un complemento del protocolo UDP que admite la multiplexación de varias conexiones y proporciona métodos de cifrado equivalentes a TLS/SSL.
El protocolo fue creado en 2013 por Google como una alternativa a TCP + TLS para la Web, resolviendo el problema de la configuración de conexión prolongada y el tiempo de negociación en TCP y eliminando las demoras debido a la pérdida de paquetes durante la transferencia de datos.
Actualmente, la compatibilidad con QUIC y HTTP/3.0 ya está implementada en todos los navegadores web populares. Del lado del servidor, las implementaciones de HTTP/3 están disponibles para nginx (en una rama separada y en forma de un módulo separado), Caddy , IIS y LiteSpeed. HTTP/3 también es compatible con la red de entrega de contenido de Cloudflare.
(adsbygoogle = window.adsbygoogle || []).push({});
Características principales de QUIC:
Ademas de ello, tambien al mismo tiempo, se publicaron versiones actualizadas de las especificaciones para los protocolos HTTP/1.1 (RFC 9112) y HTTP/2.0 (RFC 9113 ), así como documentos que definen la semántica de las solicitudes HTTP (RFC 9110) y los encabezados de control de almacenamiento en caché HTTP (RFC 9111).
De los cambios en la especificación HTTP/1.1, se puede notar la prohibición del uso separado del carácter de retorno de carro (CR) fuera del cuerpo con el contenido, es decir en elementos de protocolo, el carácter CR solo se puede utilizar junto con el carácter de nueva línea (CRLF).
El algoritmo de diseño de solicitudes fragmentadas se ha mejorado para simplificar la separación de campos adjuntos y secciones con encabezados. Se agregaron pautas para manejar contenido ambiguo para bloquear ataques de clase «Contrabando de solicitudes HTTP» que pueden entrometerse en el contenido de las solicitudes de otros usuarios en el flujo entre el frontend y el backend.
(adsbygoogle = window.adsbygoogle || []).push({});
Una actualización de la especificación HTTP/2.0 define explícitamente la compatibilidad con TLS 1.3, se descartaron el esquema de priorización y los campos de encabezado relacionados y el mecanismo de actualización de conexión HTTP/1.1 obsoleto ha quedado obsoleto.
Finalmente si estás interesado en poder conocer más al respecto, puedes consultar los detalles en el siguiente enlace.
from Linux Adictos https://ift.tt/UjMEBbm
via IFTTT

