Firefox cerrará su Lockwise en diciembre. Las contraseñas se integrarán en el navegador

Adios Firefox Lockwise

Hace ahora un par de años, Mozilla cambió el logotipo de su navegador web. El anterior estaba bien, pero el nuevo era más moderno y, además, aprovecharon para sacar otros cuatro logotipos: Firefox sería la marca, y el logotipo era como un círculo que se parecía y dejaba de parecerse al viejo logo del navegador; con la misma marca presentaron Send, Monitor, Lockwise y el navegador sería Firefox Browser. El primero en caer de los cuatro fue Firefox Send, y pronto le acompañará el gestor de contraseñas.

Porque eso es lo que es en la actualidad Lockwise. ¿El problema? Bueno, en mi opinión personal e intransferible, creo que no tiene mucho sentido sacar un gestor de contraseñas independiente si no se va a sacar una extensión para que podamos usarlo en cualquier otro navegador. Si Lockwise sólo se puede usar en Firefox, pues me parece lógico el paso que darán a mediados de diciembre: las contraseñas seguirán estando disponibles en el navegador, pero ya no en las aplicaciones móviles.

Las apps de Lockwise ya no se actualizarán ni recibirán soporte

«La aplicación Firefox Lockwise dejará de ser actualizada y soportada por Mozilla y no estará disponible en las tiendas App Store y Google Play. Después de esa fecha, los usuarios actuales de Lockwise podrán seguir accediendo a sus contraseñas guardadas y a su gestión de contraseñas en los navegadores Firefox de escritorio y móvil».

Ahora mismo y hasta que echen el cierre, Lockwise también está disponible como aplicación de iOS y Android. A partir del 13 de diciembre, si queremos consultar nuestras contraseñas en un dispositivo móvil de Apple o Android, tendremos que hacerlo desde el navegador web. Simplemente, Lockwise será absorbido por el navegador, pero las contraseñas de la versión de escritorio estarán donde siempre han estado.

Si tienes una cuenta de Firefox, probablemente ya hayas recibido un correo informando de los cambios. Lo que no han mencionado ni he encontrado en el blog de Mozilla es qué pasará con Monitor. Es probable es que siga funcionando como hasta ahora, es decir, el navegador nos avisará cuando Mozilla se entere de que una de nuestras contraseñas haya sido comprometida por un ataque a un servicio web en el que estemos registrados.

Lo único cierto es que Mozilla ha descontinuado ya dos de los cuatro servicios que convivían bajo la marca Firefox. Si esto son pasos atrás para coger carrerilla, bienvenidos sean.

from Linux Adictos https://ift.tt/2ZeXwX8
via IFTTT

Un estado alemán se pasa al código abierto y usará Linux y LibreOffice, entre otros

Alemania, Linux y el código abierto

Está claro que Windows es el sistema operativo de escritorio más usado del mundo, y personalmente dudo que eso vaya a cambiar nunca. Prácticamente todo el software está para Windows, la mayoría de ordenadores traen Windows instalado por defecto… la historia es bien conocida. Pero usar un sistema privativo que además requiere licencia no es siempre la mejor opción, algo que quedó demostrado cuando países como Corea, Rusia y China se pasaron a Linux.

En aquel momento, uno de los motivos fue el abandono del soporte de Windows 7. Las administraciones de algunos países se replantearon si les merecía la pena seguir usando el sistema operativo de Microsoft y software como su Office, y la respuesta fue que no. Ahora, un estado alemán pretende dar un paso similar, tal y como podemos leer en este artículo de Heise o en este otro de The Document Foundation, compañía que desarrolla la suite de ofimática libre más popular, es decir, LibreOffice.

Linux y software de código abierto en 25.000 ordenadores

El estado es Schleswig-Holstein, y podría ser el primero de muchos. En Heise dicen que el gobierno federal, junto a otros estados federales, han estado desarrollando software de código abierto para reducir la dependencia de la administración de compañías como Microsoft. Los planes están sobre la mesa, pero de momento es sólo Schleswig-Holsten el que va a dar el paso, y no será a corto plazo.

La intención es sustituir Microsoft Office por LibreOffice y Windows por Linux en unos 25.000 ordenadores de funcionarios y empleados del estado, entre los que también hay maestros. La transición se llevará a cabo en 2026. Pero, además, también están usando mucho Jistsi en sus comunicaciones, otro software de código abierto.

Los cambios como los mencionados de países como Rusia, China y Corea son pequeños, aunque dos de esos tres países sean grandes. Este de un estado alemán tampoco es un paso enorme, pero desde allí aseguran que están animando a otros países, y también se están planteando lo mismo en Bremen, Hamburgo y Sajonia-Anhalt. ¿Qué pasaría si toda Alemania sigue el mismo camino?

En cuanto a la distribución Linux que usarían, no han dado detalles. Sí aseguran que hay cinco que pueden servirles, pero no darán más detalles hasta que lo tengan claro.

¿Bueno para todos?

Bueno, para los usuarios de Linux no es malo. Cuanto más se use, más nos cuidarán los desarrolladores, aunque dudo que Microsoft lance su Office para Linux en un movimiento desesperado para recuperar usuarios perdidos. También hay que tener en cuenta que, del mismo modo que podría llegar software que no está disponible en la actualidad, también podrían llegar software y ataques de usuarios malintencionados. Pero vamos a pensar en positivo. Linux y el código abierto siguen dando pequeños pasos adelante.

from Linux Adictos https://ift.tt/3oSi7JM
via IFTTT

Códigos de estado HTTP, ¿qué son?

error 404 not found

Hoy en día las empresas necesitan soluciones y no problemas. El medio digital se ha convertido en una oportunidad de negocio para algunos, pero también una asignatura pendiente para otros. Muchas compañías están especializadas en un tipo de trabajo específico, en el que destacan sobre el resto. Sin embargo, su presencia online contradice esta afirmación. Hablamos de empresas con páginas web poco intuitivas, no adaptadas a formatos móviles o con un mal posicionamiento en buscadores. En general, una mala experiencia de usuario.

¿Qué son los status code?
http status code

Para comprender qué es lo que hay más allá de una página web, es importante saber cómo funciona. A la hora de hacer una web óptima influyen tanto los aspectos propios de su creación como los aspectos externos, es decir, cómo han accedido los usuarios a ella. Para estudiar de forma profunda el comportamiento del usuario, los códigos de estatus pueden resultar muy útiles.

Hablamos de una serie de códigos y números que identifican diferentes situaciones, también conocidas como status. Esto significa que podemos saber en qué estado se encuentra nuestro navegador o en qué estado está el navegador de un usuario en nuestra web. Por ejemplo, podemos ver si está en línea o si su conexión es intermitente por algún motivo. La innovación en el sector está haciendo que cada vez se pueda conocer más de forma consensuada sobre la conexión y la intercomunicación de los usuarios y las web.

Esto aporta información vital para la UX o User Experience, la nueva ciencia que estudia las sensaciones y opiniones que tienen los usuarios al interactuar con un elemento, en este caso una web. Si esta web tiene un tiempo de carga excesivo, es probable que la puntuación en cuanto a experiencia de usuario baje.

Veamos qué tipos de códigos podemos encontrar:

Errores 5XX

error 500

Por un lado, están los códigos que empiezan por 5, que hacen referencia a un fallo por parte del servidor, es decir, el proveedor de la conexión y la estructura de la web. Dentro de esta categoría también encontramos diferentes variantes. Para empezar, el código 500 hace referencia a condiciones inesperadas que impiden ejecutar una orden, mientras que el 501 apela a una funcionalidad incompatible con el servidor a la hora de tramitar una solicitud. A medida que avanzamos en este tipo de cifras, encontramos el error 502, muy común también. Este se relaciona con una respuesta inválida de un servidor que actuaba como puerta de enlace. Este tipo de cuestiones técnicas son algo sencillo de tratar para un especialista informático. También son muy comunes los errores 503 y 504, con utilidades muy distintas.

Errores 4XX
error 400

Luego tenemos los errores de tres cifras que empiezan por 4, que habitualmente se vinculan a errores cometidos por el usuario, es decir, el cliente que navega en la página web en cuestión. El primero es uno de los más comunes y se identifica con el número 400. Es el llamado bad request, que hace referencia a una solicitud que el servidor no ha podido interpretar, debido a una sintaxis errónea. También esta petición puede ser no autorizada, como en el error 401. Este hace referencia a los casos en los que una respuesta necesita de la autoidentificación del usuario. En este ámbito encontramos los casos en los que el usuario es incapaz de aportar dicha validación. También el servidor puede negarse a aceptar la petición, como en el error 403. Otro motivo puede ser el 405, que menciona que el método de solicitud empleado no es válido. También puede anularse dicha solicitud si el usuario o su equipo tardan demasiado tiempo en formalizarla, como en el error 408.

El error 404 Not Found es uno de los errores más comunes que se encuentran en internet y hace referencia a una búsqueda para la cual el servidor no tiene ninguna respuesta. Puede ser que la página que buscamos no exista, esté mal redactada o que nuestra búsqueda sea demasiado específica. Profundizaremos en este error en el siguiente apartado.

Cómo solventar errores 4xx y 5xx

Disponer de un departamento dentro del equipo puede ser complicado, sobre todo en el caso de pequeñas compañías cuyo negocio no tiene su núcleo en el ámbito online. Sin embargo, es necesario examinar regularmente ecommerces y páginas web para detectar errores que provoquen problemas de indexación y de UX en la página.

  • Para solucionar errores 5xx, es aconsejable realizar un análisis de logs para obtener información adicional del por qué se están generando. En muchas ocasiones, estos errores surgen como resultado de una mala configuración del servidor o, incluso, como consecuencia de alguno de los últimos cambios web realizados (como puede ser la mala actualización de un plugin o el cambio de alguna funcionalidad de la página).
  • Los errores 4xx más habituales son los 404 y, en ocasiones, pueden ser provocados por un comportamiento lógico si se ha eliminado contenido en la web que no va a volver. Sin embargo, es común encontrar en la página contenido similar al eliminado, al cual poder dirigir a los usuarios para facilitar la navegación. Por ello, en casos como este es importante realizar una redirección a través del archivo .htaccess.

En ambos casos, a través de la utilización de herramientas de crawleo web que simulan cómo visualiza Google la página y qué bloqueos se encuentra para hacerlo, podemos detectar el estado http de las URL que componen cualquier página web. Este trabajo es habitual que lo realicen especialistas en posicionamiento SEO, pero que técnicamente resolverá el equipo IT o informático de la empresa. Y, si no contamos internamente con este departamento, hoy en día es posible contratar a un desarrollador web freelance que analice la salud del sitio web y solvente los errores según cuál sea su naturaleza. Asimismo, contar con una comunicación fluida con el proveedor de alojamiento web es algo imprescindible para poder solventar ciertos errores de forma ágil, así como para tener alerta de cualquier problema de servidor que puede provocar una sobrecarga o caída de la página web.

Cómo optimizar la página de error 404
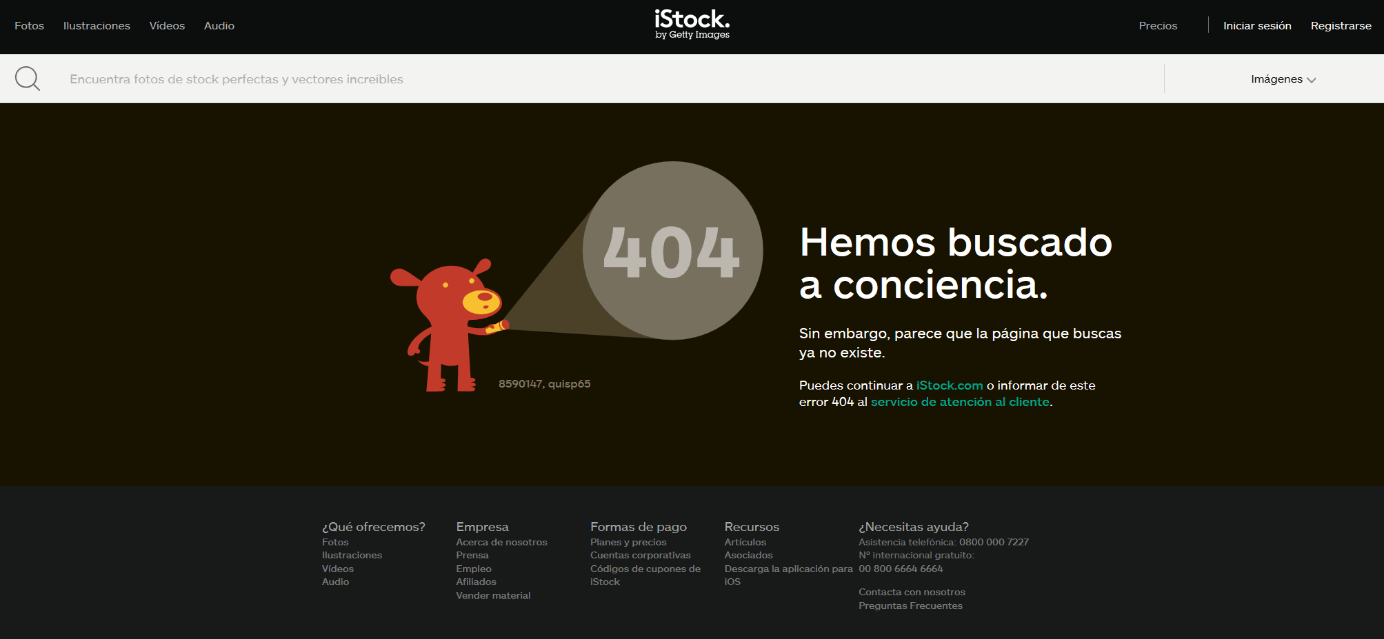
error 404 optimizada

La página de error 404 es más común de lo que parece dentro de las webs. A menudo ocurre cuando se está preparando una pestaña en concreto pero aún no está lista. Así, los usuarios pueden pinchar en enlaces o escribir peticiones muy concretas que no llevan a ningún sitio. Una forma de optimizar esta página de error es personalizarla de alguna manera, de forma que no parezca un error informático tan grave. Algunas compañías ya implementan soluciones informáticas que hacen que esta página aporte soluciones.

Hablamos, por ejemplo, de pequeños apartados de Q&A (Preguntas y Respuestas) en los que se mencionan los casos más frecuentes que han podido llevar al usuario a dicho limbo digital. Las compañías que no optimizan esta página de error o no prevén los errores por adelantado pueden ser vistas como ineptas a nivel digital.

Es importante contar con especialistas que puedan sacar la mejor versión de una empresa o profesional independiente en internet. Optimizar los códigos HTTP es solo uno de los motivos por los que sus servicios son esenciales.

from Linux Adictos https://ift.tt/3r8pMGJ
via IFTTT
Deepin 20.3 llega con Linux 5.15 y mejoras en las apps del escritorio

Deepin 20.3

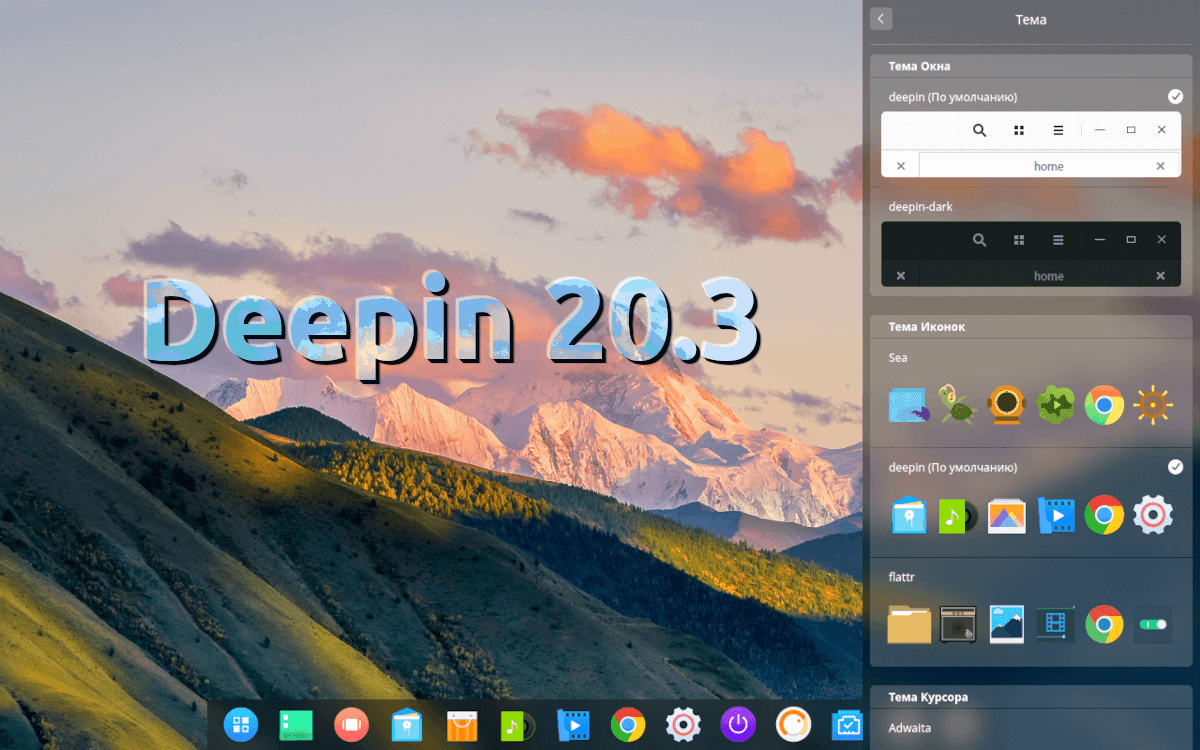
Aproximadamente mes y medio después de la versión anterior, ya tenemos nueva entrega de la distribución china más popular. Estamos hablando de Deepin 20.3, entre cuyas novedades destaca que han actualizado el kernel a la última versión. Deepin Linux suele poner a nuestra distribución dos núcleos, uno reciente y al último LTS, algo que también han hecho en esta ocasión, aunque el último LTS también coincide con la última versión estable del kernel de Linux, por lo que hay dos LTS.

Si esta distribución es tan popular es por dos motivos: primero, lo es más en China, país de origen del proyecto; segundo, por su escritorio, en lo que se incluye un entorno gráfico con interfaz moderna y aplicaciones útiles como la herramienta de capturas de pantalla. En Deepin 20.3 se ha mejorado de todo un poco, algo que se esperaba por el cambio del primer decimal.

Novedades más destacadas de Deepin 20.3

  • Linux 5.15. Se menciona que es el kernel estable y algunas de las bondades que trae. Deepin dice que hay disponible uno LTS y uno estable, por lo que debería ofrecer Linux 5.10 y Linux 5.15, aunque 5.15 también es LTS.
  • Mejoras en la app del álbum, como una mejor selección por lotes de fotos y nuevos botones para acciones rápidas, entre otras novedades.
  • Ahora la herramienta de capturas soporta capturas desplazables, en vez de hacer varias capturas.
  • Se ha añadido un atajo de teclado para búsquedas globales.
  • Añadida interfaz de información de vídeo.
  • Soporte de ffmpeg para tarjetas NVIDIA.
  • El OCR también soporta los «scrollshots».
  • Añadida la gestión, previsualización y búsqueda de vídeo.
  • Mejoras en el programa GRUB EFI para generar archivos EFI con la última visión de GRUB.
  • Lista completa de cambios en este enlace.

El lanzamiento de Deepin 20.3 ya es oficial, y se puede descargar desde el enlace propio del proyecto, OSDN, Google Drive y por la red Torrent. Después de haber probado todas las opciones, yo recomendaría intentarlo con la de Google Drive, que es la única que va rápida (aunque a veces se corta la descarga…). Si sólo queréis el escritorio, pronto estará disponible en las distribuciones Linux que lo ofrecen, como Manjaro DDE de la comunidad. UbuntuDDE no ha lanzado su versión 21.10, por lo que no parece ser una opción. En cualquier caso, Deepin 20.3 ha llegado y ya se puede instalar.

from Linux Adictos https://ift.tt/3DJtgCY
via IFTTT

screenFetch: perfecto generador de información del sistema

screenfetch

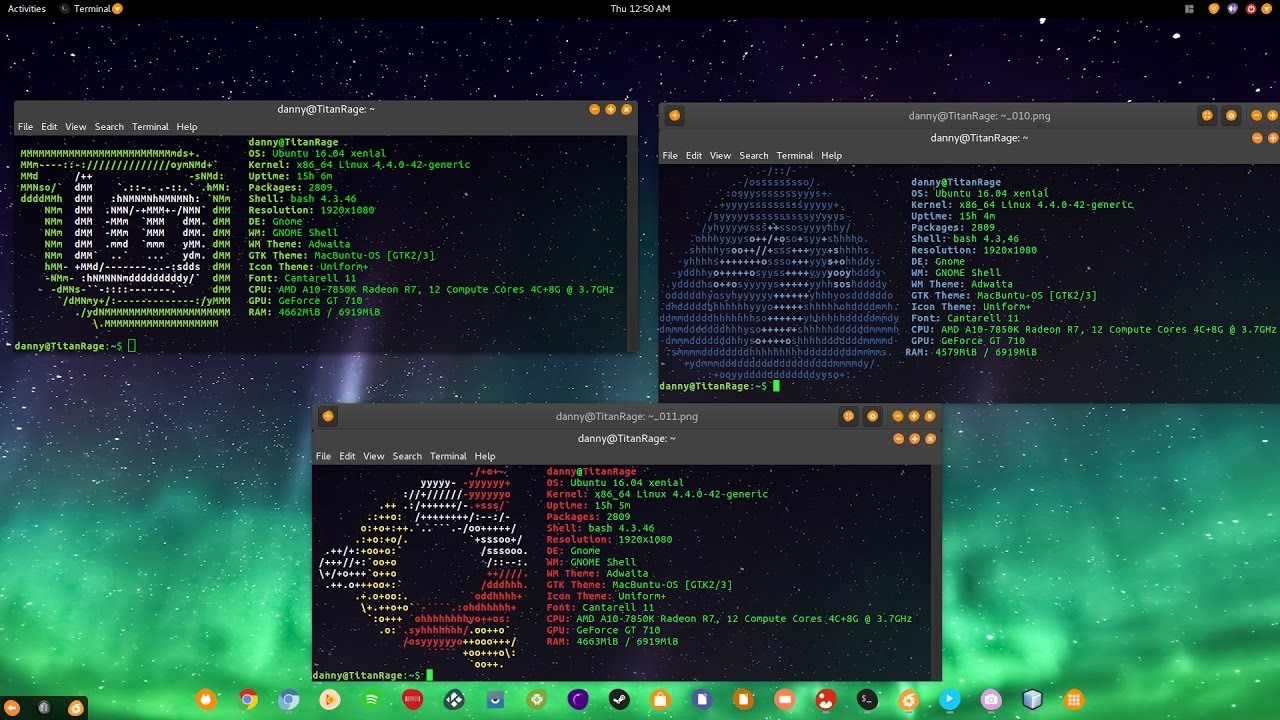
Seguramente que lo has visto en muchas capturas y tutoriales, muchos ya conocen qué es screenFetch, pero para aquellos que aún no saben de qué se trata, esta herramienta es un magnífico informador sobre tu sistema. Similar a otros programas con GUI, pero en esta ocasión basado en texto, para poderlo ejecutar desde la línea de comandos.

Gracias a esta herramienta screenFetch, podrás tener toda la información de una forma ordenada, intuitiva y fácil, sin necesidad de tener que ejecutar varios comandos de forma independiente para saber todo lo que necesitas. Además, aunque fue desarrollada para Bash, funciona en otros shells, y es lo suficientemente inteligente como para detectar la distro en la que trabaja y generar el logotipo de ésta en ASCII art.

En cuanto a la información que se muestra cuando se usa screenFetch, están los siguientes campos:

  • Nombre de usuario.
  • Hostname o nombre de la máquina.
  • Sistema Operativo o distro.
  • Kernel Linux.
  • Tiempo de actividad del sistema.
  • Packaging.
  • Shell.
  • Resolución de pantalla.
  • Entorno de escritorio.
  • Temas e iconos.
  • Fuente.
  • CPU.
  • RAM.

Si te interesa instalarlo en tu distro, es muy sencillo. ScreenFetch estará listo para usar siguiendo estos sencillos pasos:

  1. Descargar ScreenFetch desde GitHub.
  2. Verás que es un .zip, un archivo comprimido. Puedes usar la herramienta que prefieras para descomprimir.
  3. Una vez hecho, puedes mover el directorio obtenido a /usr/bin. Para ello, puedes hacerlo desde el entorno de escritorio o desde la línea de comandos con el comando «sudo mv screenFetch-master/screenfetch-dev /usr/bin/» sin comillas.
  4. Lo siguiente es desplazarte hasta /usr/bin con «cd /usr/bin».
  5. Ahora renombra screenfetch-dev a screenfetch con «sudo mv screenfetch-dev screenfetch».
  6. Después debes darle los permisos necesarios con «chmod 755 screenfetch».
  7. Por último, ya podrás ejecutarlo usando la orden:

screenfetch

Como puedes comprobar, aparecerá el logo de tu distro (si está entre las más conocidas) y la información del sistema que te puede ser útil.

from Linux Adictos https://ift.tt/3DJ8ins
via IFTTT

Acerca del protocolo BitTorrent. Su comportamiento y algunos clientes para Linux

Acerca del protocolo BitTorrent

Para terminar con esta serie de artículos sobre el protocolo BitTorrent veremos las reglas que rigen su comportamiento. A continuación, enumeraré algunos clientes disponibles para Linux.

Acerca del protocolo BitTorrent y cómo funciona

Selección de partes del archivo

Habíamos visto en el artículo anterior que cuando el sembrador sube por primera vez un archivo, este se divide en partes que serán distribuidas entre los diferentes leechers con el objeto de asegurar de que el archivo completo siempre esté disponible. Si falta una parte, la descarga fallará para todo el enjambre.  Por esto se implementa un algoritmo de selección que determinará cuál es la que se descargará en cada momento.

Existen diferentes opciones:

  • Selección al azar: Se le asigna cualquiera de las partes disponibles para que este pueda empezar a compartirla
  • La parte menos compartida: Se asigna primero la parte menos compartida hasta el momento. Esto en general se hace cuando el archivo original ya no está disponible.
  • Política estricta: Traducción mía literal del inglés. Cuando las partes se dividen a su vez en partes más pequeñas, la subparte que se descargue primero hará que a continuación se descarguen las subpartes relacionadas para reconstruirla y hacerla disponible para el resto del enjambre.
  • Modo final de juego: Se aplica cuando el archivo se descargó casi totalmente.  Para evitar que el tiempo de descarga se extienda innecesariamente por culpa de que la parte final esté disponible solo de un origen con bajo ancho de banda, se permite excepcionalmente que se pida a todos los miembros del enjambre.

Mecanismo de reciprocidad

Para lograr velocidades de carga consistente se utiliza un mecanismo de reciprocidad. Esto significa que un par reaccionará a lo que hagan los pares con los que están conectados. Mientras dure la conexión, cada par compartirá sus partes del archivo con otros cuatro pares. La selección se hace en función de la velocidad de descarga que comparten con dicho par. Estas tasas de descarga se calculan en base a un promedio continuo de 20 segundos y el cliente las recalcula cada 10 segundos.

Sin embargo, se producen las siguientes excepciones:

  • Cada 30 segundos se conecta a un par adicional sin considerar su velocidad de descarga para encontrar conexiones no utilizadas que puedan ser mejores que las actuales. Esto suele ser el cado de leechers recién conectados que todavía no empezaron a compartir.
  • Cuando un par no recibe nada de los pares con los que se conecta, intentará establecer más de una de las conexiones descripta en el punto anterior.
  • En el caso de que el leecher haya descargado todo su archivo convirtiéndose en seeder, privilegiará a aquellos pares con los que nadie está compartiendo el archivo.

Clientes BitTorrent para Linux

A diferencia de lo que sucede con las redes ED2K y Kademlia, existen múltiples clientes para la red BitTorrent que pueden utilizarse en Linux.  En general, las distribuciones Linux más populares traen uno preinstalado.  Transmission en el caso de las basadas en escritorios GNOME y KTorrent en las basadas en KDE. El navegador Brave trae el cliente WebTorrent incorporado y, este también puede utilizarse como una aplicación de escritorio.

Otras opciones

qBitTorrent

Es un cliente de código abierto multiplataforma inspirado en el conocido µTorrent. Para mi gusto tiene el mejor buscador, aunque hay que configurarlo manualmente con un proceso algo engorroso. Podemos trabajar con enlaces magnet y utilizar los protocolos DHT y PEX, además de concertarnos con torrents privados y mediante conexiones cifradas.

Deluge

Otro cliente multiplataforma con soporte para DHT, Local Peer Discovery (LSD), Peer Exchange (PEX), UPnP y NAT-PMP. Es compatible con el uso de un proxy y puede usarse vía web mediante una conexión remota.

FrostWire

En este caso tenemos algo más que un simple cliente BitTorrent. Con FrostWire no solo podemos buscar el archivo que nos interesa en la red BitTorrent sino también en diversos orígenes de recursos online. Además, dispone de un reproductor incorporado y de un gestor de medios para localizarlos archivos descargados en forma fácil.


from Linux Adictos https://ift.tt/3nELnEy
via IFTTT

Code Club World: para que los niños aprendan a programar desde casa

code club world

La Raspberry Pi Foundation ha anunciado recientemente el lanzamiento de un sitio web llamado Code Club World. Esta página web es apta para los niños, con el propósito de que puedan aprender a programar con edades desde 9 a 13 años y en casa. Allí encontrarán un montón de recursos y ayuda para aprender a hacer sus primeros pinitos con el código.

Este anuncio se hizo en el blog, por parte de la directora de experiencia de aprendizaje de la Fundación Raspberry Pi, Laura Kirsop, quien dijo que este proyecto era el resultado de un esfuerzo para crear herramientas para ayudar a los padres con la educación de sus hijos sobre nuevas tecnologías y desde casa, durante la pandemia de Covid-19.

“Cuando hablamos con padres e hijos sobre el aprendizaje en casa durante la pandemia, nos quedó claro que estaban buscando herramientas educativas que los niños pudieran disfrutar y dominar de manera independiente, y que fueran tan divertidas y sociales como los juegos de computadora y otros aplicaciones que les encantan a los niños ”, dijo Laura en el anuncio oficial.

“Una herramienta gratuita para aprender a codificar en casa es particularmente importante para los jóvenes que no pueden asistir a los clubes de codificación en persona”, agregó. “Creemos que todos los niños deben tener acceso a una educación de codificación y creación digital de alta calidad. Y con esto en mente, nos propusimos crear Code Club World, un entorno en línea tan rico y atractivo como una experiencia de aprendizaje extracurricular presencial, donde todos los jóvenes pueden aprender a codificar «.

En Code Club World, los niños pueden comenzar creando su avatar de robot personal, luego pasar a hacer música, diseñar una camiseta e incluso enseñarle a bailar a su avatar robot. Pueden aprender a codificar en islas con actividades estructuradas y descubrir codificación basada en bloques y en texto en Scratch y Python, todo mientras obtienen insignias para marcar su progreso y compartir sus creaciones de codificación con familiares, amigos y la comunidad en línea en Code. Club World. Una especie de gamificación del aprendizaje de la programación para los peques.

“Eso significa que cuando los niños están en el entorno de Code Club World, están aprendiendo a codificar y usar la creación digital para crear de forma independiente sus ideas y abordar los desafíos que les importan”, dijo Kirsop. “Al proporcionar un camino estructurado a través de las actividades de codificación, un sistema de recompensas de insignias para involucrar y motivar a los alumnos, y una amplia gama de proyectos que cubren diferentes temas, Code Club World apoya a los alumnos en cada etapa, mientras hace que las actividades sean significativas, divertidas y flexible.«

Otra ventaja es que los usuarios jóvenes no necesariamente necesitarán acceso a una computadora de escritorio o portátil para usar Code Club World, ya que la fundación se ha asegurado de que el proyecto brinde una buena experiencia de usuario en dispositivos móviles, así como en su propia SBC, a pesar de que aún está en fase beta…

from Linux Adictos https://ift.tt/3qV3ZSu
via IFTTT

find: los mejores ejemplos prácticos para localizar lo que buscas

find

El comando find es uno de los más importantes en el mundo *nix. En Linux se puede usar para localizar todo aquello que necesitas, como directorios y ficheros. Además, es extremadamente poderoso y flexible, ya que admite argumentos y opciones para crear prácticos filtros (fecha, tamaño, tipo, nombre, extensión,…). Incluso puede ser una práctica herramienta para auditar la seguridad de la distro, ya que también podrá localizar ficheros o directorios con permisos inapropiados.

Sin embargo, debido a esa versatilidad y cantidad de opciones, no es de los comandos que más fáciles son de recordar, y muchos usuarios siguen teniendo ciertos problemas. Por eso, aquí verás algunos ejemplos prácticos de los más prácticos para que aprendas a defenderte con find:

  • Buscar un archivo o directorio por su nombre (en el directorio actual, en todos los directorios, y con sensibilidad para distinguir entre minúsculas y mayúsculas):

find . -name "ejemplo.txt"

find / -name "ejemplo.txt"

find . -iname "ejemplo.txt"

  • Buscar un archivo o directorio por su nombre dentro de un directorio concreto:

find /home/usuario/prueba -name "ejemplo.txt"

  • Buscar todos los directorios (puedes usar l para enlaces simbólicos, c para dispositivos de carácter, f para ficheros, y b para dispositivos de bloque) y evitar archivos, o usar también el nombre:

find /home/usuario/prueba -type d
find /home/usuario/prueba -type d -name "ejemplo"

  • Buscar archivos con una extensión particular:

find . -type f -name "*.txt"

  • Buscar archivos por su nombre y eliminarlo:

find . -name "ejemplo.txt" -delete

  • Buscar todos los archivos accedidos más viejos de 10 años, o también puedes hacerlo por fecha de modificación en los últimos 60 min y por fecha de cambios en menos de 1 día:

find / -atime 10
find / -mmin -60
find / -ctime -1

  • Buscar los archivos que sean mayores de 500MB y menores de 1GB:

find / -size +500M -size -1G

  • Buscar los archivos que superan los 10GB y eliminarlos de una sola vez:

find / -size +10G -exec rm -rfv {} \;

  • Buscar los archivos que pertenezcan a un usuario o a un grupo:

find / -user nombre
find / -group nombre

  • Buscar los archivos que tengan unos permisos concretos:

find / -perm 644

  • Buscar los archivos vacíos (si cambias f por d puedes buscar directorios vacíos):

find / -type f -empty

  • Buscar los archivos ocultos (d en vez de f para directorios ocultos):

find / -type f -name ".*"

  • Buscar texto dentro de ficheros:

find / -type f -name "*.txt" -exec grep 'texto-a-buscar' {} \;

from Linux Adictos https://ift.tt/3kV0QhU
via IFTTT

WINE 6.22 llega con Mono 7.0 preparando el camino para las Release Candidates

WINE 6.22

Como comentábamos hace dos semanas, y aunque en algunos medios no apuntaban en la misma dirección, WineHQ lanzó ayer WINE 6.22, una nueva versión de desarrollo. Aunque nosotros no lo teníamos claro al cien por cien, sí creíamos que hoy tendríamos un nuevo lanzamiento bisemanal de esos en los que se introducen cientos de cambios y no la primera Release Candidate que ya se lanza cada semana sólo para mejorar lo existente.

Entre las novedades que han introducido este viernes día 19 de noviembre tenemos que el motor Mono se ha actualizado a la versión 7.0.0. En cuanto a número de novedades, introdujeron 29 correcciones y 427 cambios. Aunque esta vez no se han llegado a los 500, siguen siendo muchos, ya que hay semanas en los que se superan por poco los 200. Lo que han mencionado como destacado es lo siguiente.

Novedades más destacadas de WINE 6.22

Según WineHQ, lo más destacado de todos los cambios introducidos esta semana, además de que el Motor Mono se ha actualizado a la versión 7.0.0, son el desenlace de excepciones en ARM, más mejoras en el soporte de joystick HID, WoW64 thunks en un número de bibliotecas Unix, se ha comenzado el traslado de USER32 a Win32u y varias correcciones de errores.

WINE 6.22 ya se puede descargar desde este o este otro enlace. WineHQ también aporta información para descargar esta y futuras actualizaciones añadiendo el repositorio oficial para Linux aquí, pero también se puede instalar en macOS y Android. Si se añade el repositorio se puede elegir entre las versiones estable, Staging o Dev.

Teniendo en cuenta que el año pasado la última actualización de desarrollo/bisemanal fue WINE 5.22, es probable que lo que nos entreguen la próxima vez sea ya WINE 7.0 RC 1. Si se da el caso ya no introducirán tantos cambios, sino que empezarán a pulirlo todo de cara al lanzamiento de la versión estable que tendrá lugar a principios de 2022.

from Linux Adictos https://ift.tt/3kTRqDm
via IFTTT

Dependency Combobulator: toolkit open-source contra los ataques

Dependency Combobulator

Dependency Combobulator es un conjunto de herramientas de código abierto para combatir los ataques de confusión/sustitución de dependencias. Es decir, aquellos ataques que aprovechan un repositorio público o privado de proyectos de software para confundir al gestor de paquetes y colar paquetes que serían supuestas dependencias pero que van dirigidos a realizar algún tipo de ataque.

Apiiro lanzó Dependency Combobulator precisamente para poder luchar contra esto. Un kit de herramientas capaz de detectar y prevenir estos ataques. Estos ataques han sido descubiertos recientemente, y han aumentado como vector de ataque en la actualidad. Es decir, con este kit podrás evitar este tipo de engaños de dependencias que terminan siendo paquetes maliciosos (en vez de instalar la dependencia correcta que se debería instalar para el software que el gestor de paquetes está instalando).

En estos casos, los usuarios no son conscientes, se fían del gestor de paquetes que es el que automatiza el trabajo de las dependencias. Sin embargo, estarían autorizando código malicioso sin saberlo. Ahí es donde Dependency Combobulator se vuelve interesante, para evaluar diferentes fuentes como GitHub, JFrog Artifactory, etc.


Esta herramienta está desarrollada en lenguaje de programación Python, y usa un motor heurístico que funciona en un modelo de paquete abstracto, lo que proporciona fácil extensibilidad. Además de la flexibilidad, también puede llevar a los profesionales de la seguridad a tomar mejores decisiones. Puede integrarse fácilmente, y se lanza de forma automática.

“A raíz de la decisión del investigador de seguridad Alex Birsan de comprometer los ecosistemas mantenidos por Apple, Microsoft y PayPal a principios de este año, la industria experimentó un brote de ataques similares a la cadena de suministro”, dijo Moshe Zioni , vicepresidente de investigación de seguridad de Apiiro . “Estábamos ansiosos por responder creando un conjunto de herramientas que puede mitigar amenazas similares y ser lo suficientemente flexible y extensible para combatir las futuras oleadas de ataques de confusión de dependencia. Abordar este vector de ataque es esencial para que las organizaciones aseguren con éxito sus cadenas de suministro de software «.

from Linux Adictos https://ift.tt/2Z5njkH
via IFTTT