La adopción de la inteligencia artificial ha avanzado a un ritmo acelerado. Informes recientes señalan que una gran mayoría de organizaciones ya utiliza herramientas de IA en al menos una función del negocio, pero muy pocas han logrado escalar su uso a toda la organización y una fracción está aún en fases piloto. En el área de marketing, esa brecha se acentúa cuando un piloto de IA se enfrenta a la complejidad de un stack de datos existente. Un piloto puede demostrar la capacidad de un modelo cuando se le asigna una tarea definida y datos cuidadosamente seleccionados; trasladar esa capacidad a un entorno empresarial vivo, sin embargo, suele ser mucho más desafiante.
La raíz del problema a menudo no reside en el modelo en sí, sino en la forma en que se gestionan los datos de marketing. Los datos están dispersos entre plataformas, almacenes y sistemas internos, con estructuras y definiciones distintas que dificultan que la IA entienda qué significan realmente los números. Esto facilita que la salida de un modelo parezca creíble incluso cuando se basa en supuestos incorrectos.
Una solución clave es una capa de conocimiento que conecte las bases de datos con el razonamiento de la IA. Esta capa define conceptos canónicos, mapea definiciones entre plataformas y captura las reglas de negocio que deben aplicarse antes de considerar fiable un análisis. Al estar integrada sobre los almacenes de datos existentes, permite evitar inversiones costosas en sustitución de infraestructura.
La claridad de un punto de partida definido es crucial: en lugar de seguir la primera versión que el modelo encuentre de una métrica, la IA debe operar con una comprensión gobernada de lo que ese concepto significa en la organización y cómo interpretarlo correctamente.
Sin embargo, las definiciones estáticas no son suficientes. El rendimiento de marketing cambia con el negocio, por lo que la IA también necesita acceso al contexto que rodea una investigación. Una campaña puede mostrar un descenso en el rendimiento debido a un cambio presupuestario reciente, o a una promoción nueva o a una prueba de mercado en curso. Sin esa información contextual, la IA puede identificar un cambio con precisión, pero concluir de forma errónea la causa.
Esta distinción se refleja mejor al separar el conocimiento de marketing persistente del contexto que se resuelve para cada investigación. En este punto, la colaboración entre equipos de marketing y de datos es esencial: los primeros entienden los objetivos y cómo interpretar el rendimiento, mientras que los segundos conocen los sistemas y controles de gestión de datos. Juntas, estas perspectivas crean una base más útil para la IA: las definiciones pueden acordarse antes de integrarlas en flujos de trabajo automatizados, y los requisitos de gobernanza pueden seguir siendo parte del proceso analítico en lugar de añadirse después de generar un resultado.
La adopción de IA en producción exige confianza, no otro piloto. El siguiente salto requiere convertir estas bases en operación. La investigación de McKinsey indica que la mayoría de las organizaciones aún se sitúan entre la experimentación y la primera escala, a pesar del crecimiento de la adopción. Por ello, la prioridad para los responsables de marketing debe ser revisar lo que rodea al modelo, antes de incorporar uno más. ¿Las métricas relevantes están definidas de forma consistente? ¿Puede la IA entender cómo se relacionan esas métricas entre sistemas? ¿Sabe qué decisiones están modelando el rendimiento actualmente?
Una capa de conocimiento bien estructurada puede proporcionar la conexión faltante entre los datos empresariales y el razonamiento de la IA, dando a los modelos una comprensión gobernada del entorno operativo y reduciendo las suposiciones que deben hacer.
Así cambia la pregunta de producción: en lugar de preguntarse si un modelo nuevo es lo suficientemente capaz, las organizaciones pueden centrarse en si la IA ha recibido el conocimiento necesario para funcionar de forma confiable. Los modelos seguirán evolucionando, pero para las empresas que buscan convertir la inversión en IA en valor medible, la acción más inmediata es asegurar que esos modelos cuenten con una base de conocimiento estable para razonar.
En última instancia, los esfuerzos deben orientarse a convertir el impulso tecnológico en resultados tangibles, asegurando que la IA opere con una comprensión coherente del negocio y de sus reglas, para que las decisiones dependan menos de conjeturas y más de una interpretación compartida de los datos.
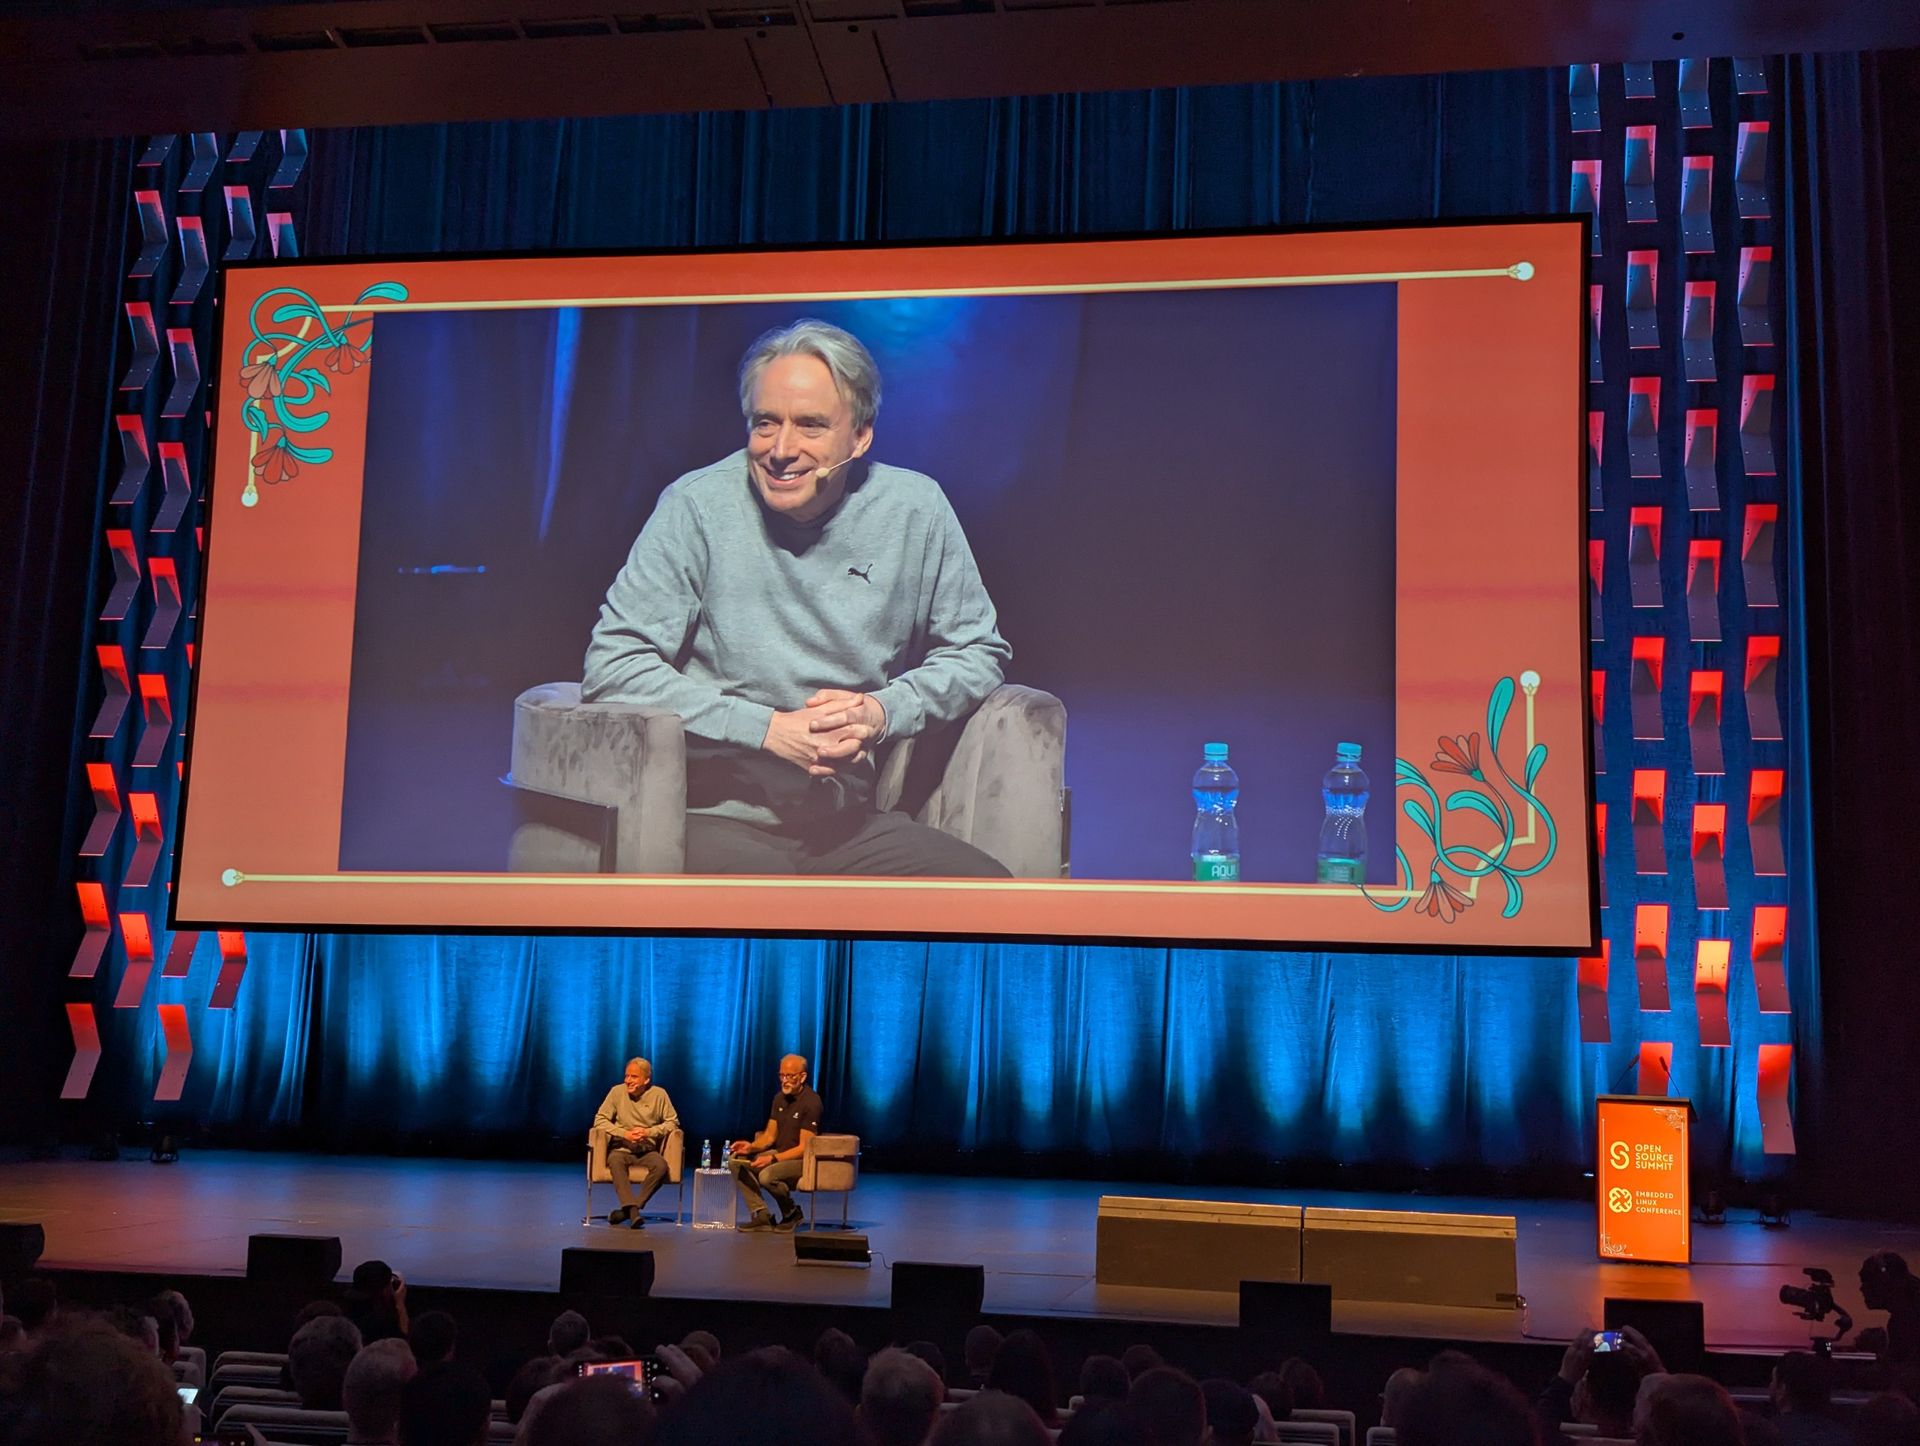
En medio de titulares sombríos sobre el impacto de la IA, una voz destacada ofrece una lectura fresca y pragmática: Linus Torvalds, fundador y principal mantenedor del kernel de Linux, compartió en Open Source Summit en Praga una visión que merece ser considerada con seriedad por desarrolladores y comunidades de código abierto. Este artículo explora sus ideas sobre cómo la IA está cambiando lo que significa ser programador hoy y por qué puede actuar como una puerta de entrada para jóvenes y principiantes.
Torvalds recordó los primeros días de Linux y el trayecto hacia la creación de Git, pero centró su reflexión en cómo la IA ha modificado el sentimiento y la experiencia de programar. Su tesis principal es que la IA puede reducir la intimidación inicial para quienes se acercan a la programación, especialmente para juniors y adolescentes que buscan orientarse en una industria que, a veces, parece intimidante y ultracompleja.
“La gente ama odiar a la IA. Creo que es una herramienta interesante, muy útil. Es una puerta de entrada y una vía para generar código realmente bueno”, declaró, con un tono que buscaba equilibrar humor y seriedad.
Sobre la idea de la IA y la noción de “fallar” o de hacer cosas que no están a la altura, Torvalds recordó sus inicios en programación, cuando desarrolló juegos de ordenador que, en su momento, “dejaban mucho que desear”, aunque todo lo demás también estaba lejos de ser perfecto. Este contexto ayuda a entender su argumento: lo importante no es la perfección desde el inicio, sino permitir que el proceso de aprendizaje comience y se mantenga agradable. En palabras del propio Torvalds, el objetivo es que el umbral para empezar sea lo suficientemente bajo como para que el aprendizaje tenga sentido y disfrute, sabiendo que llevará tiempo dominar las habilidades necesarias.
No obstante, advierte sobre el uso de la IA para trabajos serios, especialmente al inicio. Quien utilice la herramienta debe tener claro qué quiere lograr y cuál debe ser el resultado; de lo contrario, el riesgo de errores con consecuencias graves es alto. Así, recomienda comenzar con proyectos “de juguete” o proyectos personales antes de aplicar la IA a tareas de mayor envergadura. En su visión, la IA debe ser una puerta de entrada, no una sustitución del aprendizaje profundo.
Una parte importante de su discurso aborda el equilibrio entre entusiasmo y cautela: la IA puede facilitar el aprendizaje y la exploración, pero debe usarse con responsabilidad cuando el trabajo es real y relevante. Este enfoque sugiere que las comunidades técnicas deben educar a los usuarios sobre límites, objetivos y verificación de resultados para evitar malentendidos y errores costosos.
En cuanto a vulnerabilidades y parches generados por IA, Torvalds mencionó un fenómeno reciente: informes de vulnerabilidades y parches generados por IA que inundan listas de correo y comprometen la gestión de seguridad por la duplicación y la distribución de información no verificada. Aquel panorama llevó a que muchos mensajes fueran duplicados o poco útiles, obligando a los mantenedores a filtrar y redirigir esfuerzos. Esta experiencia subraya una verdad práctica: la tecnología, por poderosa que sea, requiere una gobernanza cuidadosa y un uso consciente para no desfavorecer la seguridad y la calidad del código.
Para enfrentar este desafío, Torvalds propone una estrategia paradójica: más IA, no menos. Al usar herramientas de IA para generar revisiones y parches, la comunidad puede racionalizar procesos y acelerar correcciones, siempre que exista control humano y una estructura de revisión sólida. La clave está en equilibrar el flujo de aportes automatizados con prácticas de mantenimiento y priorización que eviten la saturación y el ruido.
El mensaje central de Torvalds, entonces, es doble. Por un lado, la IA puede democratizar la programación al bajar las barreras de entrada y permitir que más personas participen y aprendan. Por otro lado, la comunidad técnica debe gestionar de forma consciente el uso de la IA para garantizar la calidad, la seguridad y la sostenibilidad de los proyectos. En resumen, la IA no es un fin en sí mismo, sino una herramienta que, bien utilizada, puede impulsar la creatividad, la colaboración y la formación de nuevas generaciones de programadores.
Este análisis propone pensar en la IA como un catalizador de aprendizaje y un acelerador de procesos, siempre dentro de una ética de uso responsable y una gobernanza que priorice la seguridad, la transparencia y la calidad del código. En un panorama tecnológico en constante cambio, la conversación de Torvalds nos invita a abrazar la IA como un aliado para aprender y construir, sin perder de vista la necesidad de aprender a fondo, con paciencia, curiosidad y rigor.
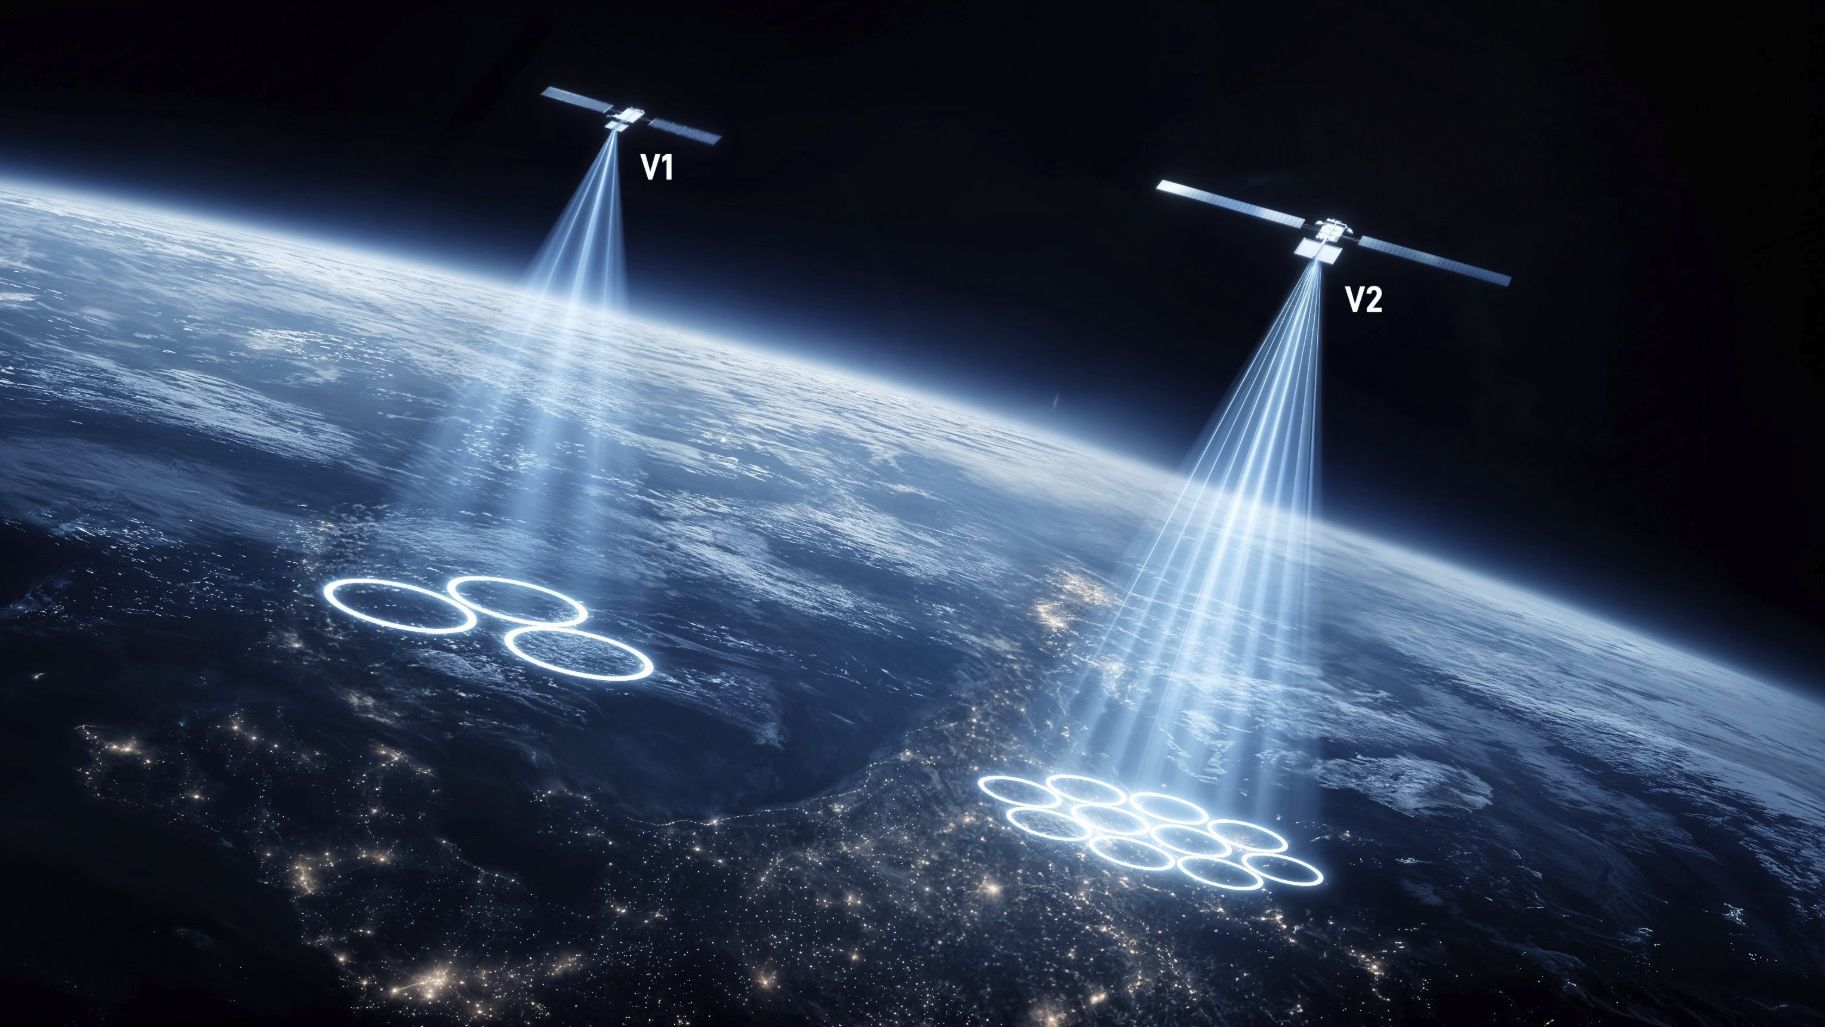
SpaceX ha anunciado la adquisición de un segmento de espectro de banda baja de 800 MHz para Starlink Mobile, una jugada que podría convertir al proyecto en un actor más relevante dentro del panorama de las telecomunicaciones. Este espectro es particularmente atractivo para lograr una mejor penetración de la señal dentro de edificios y interiores, gracias a sus propiedades de propagación frente a obstáculos como paredes. Junto a la llegada de nuevos satélites, la combinación de este espectro con capacidades adicionales podría allanar el camino para que Starlink Mobile se consolide como un posible operador móvil de gran tamaño en Estados Unidos.
No obstante, la apuesta no parece exenta de desafíos. Aunque la banda de 800 MHz aporta ventajas en penetración y cobertura, es probable que SpaceX necesite amplios bloques de espectro complementarios y una inversión sustancial en infraestructura terrestre para garantizar una cobertura fiable en zonas urbanas y rurales. En palabras de analistas y expertos de la industria, la cantidad de espectro adquirida representa una base prometedora, pero no suficiente por sí sola para sostener una red móvil de alcance masivo.
En el último año, la discusión pública sobre la viabilidad del proyecto ha sido intensa. El CEO de AT&T, por ejemplo, cuestionó la viabilidad de los planes de Starlink Mobile, solo para ver cómo SpaceX anunciaba la adquisición de 14 MHz de espectro en la banda de 800 MHz poco después. Según la propia SpaceX, este movimiento refuerza su capacidad para construir la «red móvil más avanzada del mundo» y posicionarse como un “gran operador móvil” mediante una estrategia híbrida que combina satélites y una infraestructura terrestre de vanguardia.
La Comisión Federal de Comunicaciones (FCC) también dio un impulso al proyecto al aprobar la solicitud de la constelación Gen2 de Starlink Mobile, que permite la salida al espacio de hasta 15.000 nuevos satélites. Con una flota ampliada, la capacidad de banda ancha de alta velocidad podría multiplicarse, prometiendo servicios móviles de alto rendimiento en prácticamente cualquier lugar del mundo. Sin embargo, incluso con estas aprobaciones, la implementación práctica de una red móvil de gran escala requerirá inversiones continuas y una economía de escalas que aún está por definirse.
El análisis de expertos, como Tim Farrar de TMF Associates, indica que, aunque la iniciativa añade combustible a la rivalidad entre SpaceX y los operadores móviles, la cantidad de espectro disponible sigue siendo limitada para garantizar penetración de señal en entornos urbanos sin la instalación de torres terrestres. En ese sentido, corresponde a SpaceX demostrar que puede desplegar la infraestructura necesaria para complementar su flota satelital y competir de forma sostenible con AT&T, T-Mobile y Verizon.
En resumen, este movimiento representa la primera etapa prometedora de un camino que podría redefinir la competencia en el mercado móvil. No obstante, para que Starlink Mobile se convierta en una fuerza dominante, será imprescindible asegurar más espectro y una inversión sustancial en infraestructura terrestre, así como una ejecución operativa que demuestre viabilidad a gran escala. En la medida en que SpaceX avanza, los grandes operadores podrían verse obligados a vigilar de cerca la evolución de la propuesta desde el espacio, ya que la convergencia entre satélites y redes terrestres podría redefinir el liderazgo en conectividad móvil a largo plazo.
En los últimos años, Samsung ha sabido combinar innovación con una herencia de sonido reconocida mundialmente. Los rumores señalan que la compañía podría estar preparando sus primeros auriculares over-ear en una década, con un nombre que ya genera expectativa: Galaxy Studio. Este posible lanzamiento, apoyado por filtraciones y un registro de marca reciente, sugiere un nuevo capítulo para la estrategia de audio de Samsung y la forma en que sus marcas asociadas podrían jugar un papel central.
La idea de un Galaxy Studio no es casualidad. El nombre podría aludir a un uso profesional, como mezcla musical y escucha crítica, pero en el ecosistema de Samsung podría tener también un enfoque más amplio para consumidores exigentes que buscan calidad y refinamiento, sin abandonar la amplitud de la oferta de la marca.
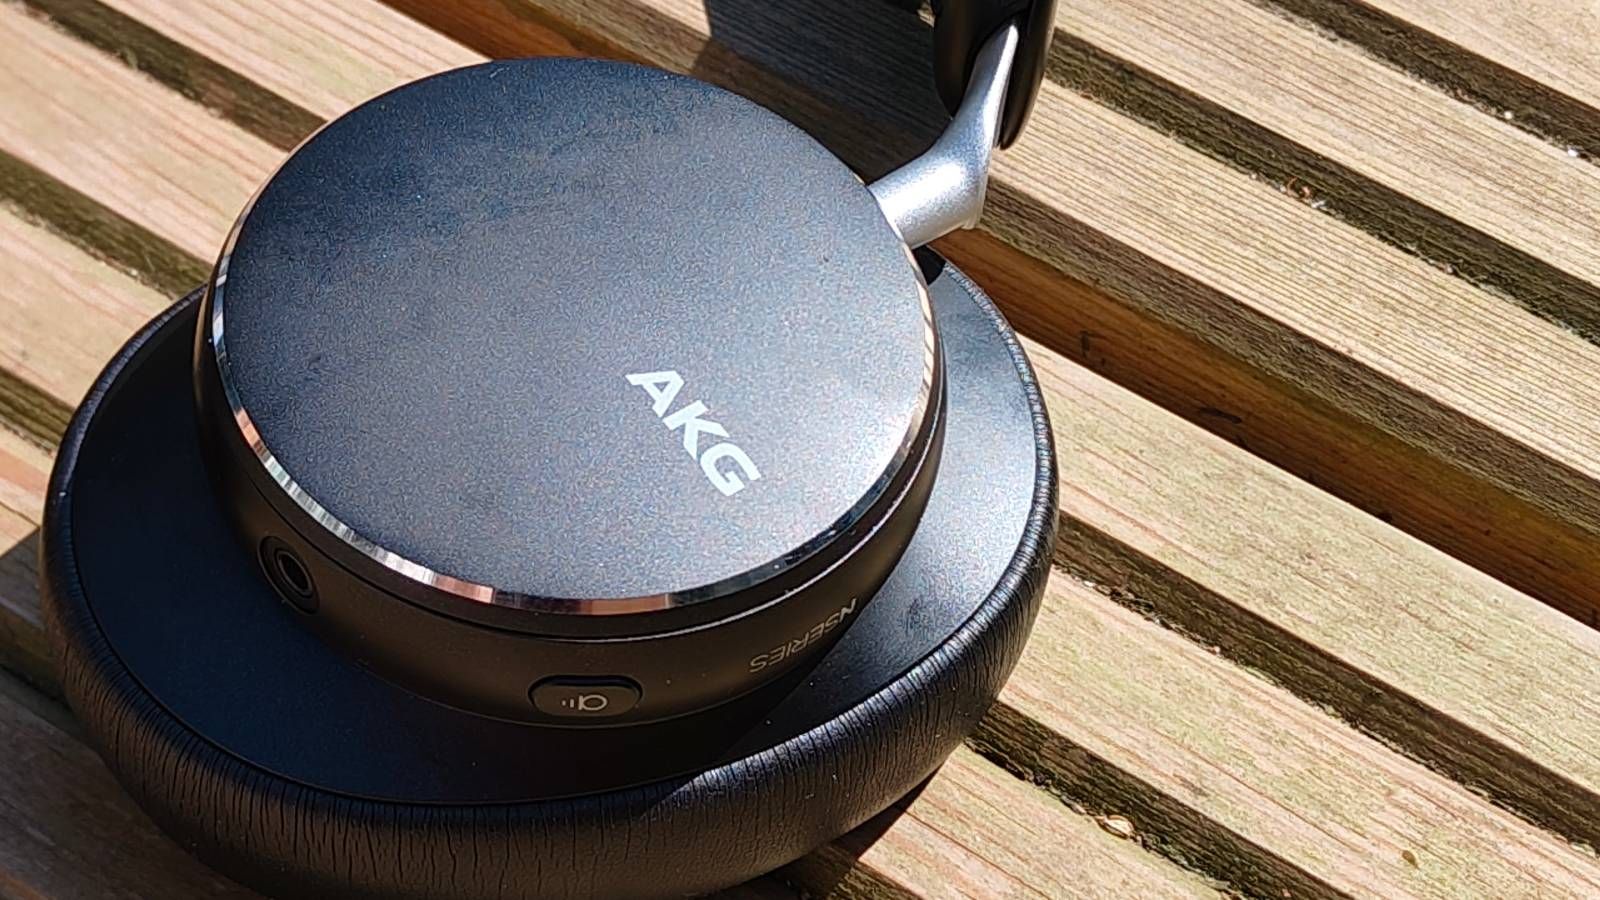
La posibilidad de que exista este modelo cobra más fuerza si se recuerda que Samsung adquirió Harman International en 2016, consolidando a Harman Kardon, JBL y AKG en su portafolio, y posteriormente Masimo añadió marcas como Bowers & Wilkins, Denon y Marantz a su repertorio. Con este conjunto de nombres en la sala de trofeos, un nuevo par de auriculares podría convertirse en un lienzo para aprovechar las fortalezas de cada marca, desde la precisión de AKG hasta el pulso de Bowers & Wilkins y la experiencia de JBL en itinerarios de sonido premium.
Hasta ahora, Samsung ha apostado por auriculares intrauditivos, como la serie Galaxy Buds 4 y Buds 4 Pro, manteniendo los over-ears fuera de escena desde generaciones anteriores. Este regreso podría responder a una demanda de mercado y a la necesidad de distinguirse en un segmento dominado por competidores con soluciones de referencia. El rumor de un Galaxy Studio llega acompañado de la expectativa de una experiencia de sonido cohesionada con el ecosistema Samsung, al tiempo que aprovecha el linaje de sus marcas de audio asociadas.
Sin información oficial sobre precio, especificaciones o fecha de lanzamiento, los aficionados contemplan escenarios posibles para 2027, que podrían ir acompañados de otros lanzamientos relevantes como nuevas generaciones de dispositivos Galaxy. Aunque, como sucede con las noticias de tecnología, lo definitivo solo se sabrá cuando Samsung comparta detalles directos.
En resumen, Galaxy Studio representa una promesa: una incursión de Samsung en el mundo de los auriculares over-ear que podría fusionar rendimiento y herencia de marca en una propuesta atractiva para audiófilos casuales y usuarios que buscan una experiencia sonora premium dentro de un ecosistema integrado. El camino está abierto, y la pregunta es cuánto impacto real tendrá este proyecto en el mercado y en la forma en que las marcas heredadas de Harman, AKG, JBL y Bowers & Wilkins se posicionarán dentro de la estrategia global de Samsung.
En la era de la inteligencia artificial empresarial, surge una visión clara: los agentes pueden operar de forma independiente para alcanzar objetivos, sin necesidad de instrucciones detalladas. Gemini Agent representa este salto, funcionando siempre activos en la nube para ejecutar tareas, gestionar proyectos y colaborar con plataformas de terceros, incluso con modelos rivales. Google ha presentado una estrategia en la que un único agente central puede responder preguntas, crear documentos, generar activos, organizar reuniones y mucho más, manteniendo a las organizaciones en constante movimiento sin depender de intervenciones continuas.
Este enfoque transforma el rol de los trabajadores, pasando de recibir asistencia puntual de IA a delegar cargas laborales completas que pueden desarrollarse de manera autónoma y a largo plazo. La propuesta no es solo tecnológica; es una reconfiguración de flujos de trabajo y de la relación entre humanos e inteligencia artificial en el entorno profesional.
Gemini Agent se distingue por su operación como agente siempre activo. Al ejecutarse en la infraestructura de Google Cloud, puede continuar trabajando en segundo plano incluso cuando los usuarios no están frente a sus pantallas. Además, Google no limita el uso a un entorno corporativo: Gemini Agents están diseñados para ser tan personales como profesionales. Pueden gestionarse con cuentas de correo, calendarios y almacenamiento en Drive dedicados, lo que facilita su integración en la vida diaria del usuario dentro y fuera de la oficina.
A pesar de ser un producto de Google que corre sobre Google Cloud, la plataforma abre la puerta a compatibilidad con otros modelos, incluyendo los de Anthropic, y promete sumar más opciones en el futuro. Thomas Kurian, CEO de Google Cloud, describe a Gemini como una plataforma que respalda la continuidad y la adaptabilidad: “una plataforma a prueba de futuro que funciona en cualquier lugar, ejecuta cualquier tarea, admite tu elección de modelos y aplica controles empresariales”.
La accesibilidad y la apertura se fortalecen mediante su operatividad transfronteriza: funcionará con plataformas de terceros como Microsoft 365 y Slack, y estará disponible en dispositivos variados, abarcando iOS, Android, macOS y Windows. Aunque Gemini Agents aún no están General Availability, algunos clientes ya acceden a una vista previa privada. Se espera ampliar casos de uso y detallar funcionalidades adicionales a medida que se acerca la disponibilidad general.
Este avance marca una consolidación de la idea de un empleado digital autónomo: una solución que no solo asiste, sino que puede gestionar tareas continuas, coordinar recursos y adaptarse a distintas infraestructuras y plataformas, siempre con controles y opciones de configuración para el entorno empresarial.
Para entender el impacto, basta mirar la evolución de herramientas como Muse de Meta y Dots de OpenAI, que apuntan a una experiencia de agentes que operan con menos instrucciones explícitas y mayor delegación de responsabilidades. Gemini Agent se posiciona como un actor central en esa tendencia, orientado a la productividad, la colaboración y la eficiencia operativa sin sacrificar la seguridad ni la gobernanza corporativa.
Los bancos destinan grandes recursos a convencer a los clientes de que son los custodios más cuidadosos de los datos personales y financieros. Sin embargo, una revisión de 14 sitios de servicios financieros en Europa y EE. UU. revela prácticas preocupantes: scripts de rastreo y personalización incrustados en procesos de apertura de cuentas, hipotecarios y de préstamos que envían datos de contacto, intención financiera y huellas de dispositivos a terceros, con 9 de 14 sitios operando sin una opción de consentimiento válida.
Las fallas se agrupan en tres patrones, y la distinción entre ellos tiene implicaciones legales. En primer lugar, las etiquetas se disparaban antes de que se respondiera el banner de cookies en sitios de gestión de patrimonio, banca de inversión y proveedores de pago; según la Directiva de ePrivacy de la UE, ese comportamiento no tenía base legal, ya que el consentimiento es obligatorio antes de almacenar o leer datos en un dispositivo.
En segundo lugar, el rastreo continuó tras que el usuario rechazara las cookies: en un sitio, Google Ads y DoubleClick recibían la dirección de correo electrónico hasheada en la URL de la solicitud junto con la señal de consentimiento denegada, lo que implica que el rechazo se registró y se ignoró.
En tercer lugar, se filtraron datos financieros independientemente del consentimiento: un importe de préstamo de 2.500 € en un plazo de 12 meses y una selección de seguro llegaron a Google Analytics durante una solicitud de crédito personal; en un banco portugués, el nombre, la edad y el NIF de un cliente se enviaron a Evergage como texto codificado en Base64 en la URL durante la apertura de la cuenta.
En un sitio bancario holandés, un script de primera parte combinaba fingerprinting del navegador con peticiones de imágenes a 127.0.0.1 en los puertos 7070 y 5938, asociados a AnyDesk y TeamViewer, verificando efectivamente si software de acceso remoto estaba funcionando en el dispositivo del visitante.
Dónde recae la responsabilidad
Meta y TikTok señalan al operador del sitio como la parte que controla lo que se recoge, en respuesta a investigaciones anteriores. Meta citó sus controles de privacidad y su política contra compartir datos sensibles; TikTok afirmó que los anunciantes deciden qué eventos y parámetros envían y que solo recibe lo que sus socios configuran intencionalmente.
Este marco coloca toda la responsabilidad en el operador, y solo se sostiene si la recopilación fue algo que el operador activó deliberadamente. A menudo no lo fue. La función de Coincidencia Avanzada Automática (Automatic Advanced Matching) de Meta Pixel está activada por defecto y, en ese estado, captura y aplica hash a datos de contacto sin necesidad de configuración adicional por parte del propietario del sitio. Un ingeniero bancario que añade un snippet de rastreo no está eligiendo enviar el correo electrónico y el teléfono hasheados de un solicitante de hipoteca a Meta; el píxel lo hace por defecto. Una política que prohíbe recolectar datos sensibles es difícil de reconciliar con una función que los recoge por defecto.
Eso no elimina la responsabilidad del banco. Las entidades deciden qué proveedores despliegan, colocan banners de consentimiento frente a los clientes y publican políticas de cookies que deben enumerar cada entidad receptora de datos. Ambos lados tienen responsabilidad: las plataformas envían defaults que maximizan la captación de datos y los bancos desplegan esos defaults en flujos sensibles sin validar su comportamiento en tiempo real.
Cerrando la brecha
Esto es una cuestión de cumplimiento tanto como de ética.
En la UE, scripts de terceros no gestionados en flujos orientados al cliente abarcan GDPR y requisitos de consentimiento de ePrivacy; para entidades financieras reguladas, también rigen las reglas de riesgo y resiliencia operativa de DORA; PSD2 añade obligaciones de seguridad para flujos de pago. En EE. UU., las instituciones tienen deberes bajo la regla de Salvaguardas de GLBA y, cada vez más, bajo leyes estatales como CCPA/CPRA. Aparte de la exposición reguladora, se trata de higiene operativa básica.
La corrección comienza verificando el comportamiento en tiempo real en lugar de asumir que coincide con la configuración. Esto significa validar lo que hacen los scripts en páginas reales de apertura de cuentas, hipotecas, préstamos y simulaciones, ya que son las que manejan los datos más valiosos, en lugar de detener las comprobaciones solo en la página de inicio. También implica vigilar por un script que empiece a recoger más de lo previsto, a veces llamado alcance incremental (scope creep).
La visibilidad debe conducir al control. Los equipos de seguridad deben poder impedir que scripts de terceros lean campos sensibles y bloquear transferencias de datos no autorizadas, incluyendo la práctica de ocultar identificadores y detalles financieros dentro de una URL de solicitud en lugar de en el cuerpo de la petición, tal como ocurrió en varias filtraciones de nuestra investigación.
El consentimiento debe traducirse en acción real, no solo en papel. Una denegación debe impedir que los datos salgan del navegador en lugar de registrarse como señal denegada mientras la llamada de rastreo se ejecuta. Ese consentimiento debe acompañar al cliente incluso al interactuar con iframes o subdominios que adopte el flujo, y no reiniciarse en cada frontera que cruce.
Caracteres como Automatic Advanced Matching, que hashea y envía datos de contacto por defecto, deben desactivarse a menos que dicha recopilación esté documentada, informada y sea legal. El código propio merece la misma escrutinio que las etiquetas de terceros: la huella digital y el sondeo de puertos para fraude pueden ser controles legítimos, pero implementarlo internamente no exime de divulgación y consentimiento.
Nada de esto exige abandonar la analítica o la personalización. Requiere tratar los scripts en páginas sensibles como parte del riesgo de la institución, revisados en el mismo ciclo que cualquier otro proveedor, y no configurados una vez y dejados sin revisión. Nueve de las catorce entidades analizadas enviaban datos a través de un canal cuyo propio banner de consentimiento indicaba que estaba cerrado.
Esa brecha entre lo que un script puede hacer y lo que realmente hace merece cerrarse antes de que un regulador o un cliente lo descubra primero.
Este artículo forma parte deTechRadar Pro Perspectives, nuestro canal para presentar las mentes más brillantes de la industria tecnológica. Las opiniones aquí expresadas corresponden al autor y no necesariamente a TechRadar Pro ni a Future plc. Si está interesado en contribuir, descubra más aquí: https://www.techradar.com/pro/perspectives-how-to-submit.
Nestled among the unusually snow-free Swiss Alps, Proton’s Geneva HQ shines in front of me on a glorious, sunny October day. I’m here alongside periodistas from varios países para explorar cómo una empresa centrada en la privacidad está diseñando una alternativa contundente a Google, su rival número uno.
Tras un breve recorrido por la oficina, hacemos una parada en la cocina para tomar un café antes de comenzar un día largo de presentaciones. Algunos empleados de Proton terminan el generoso desayuno diario que ofrece la compañía, mientras otros hojean el menú del almuerzo.
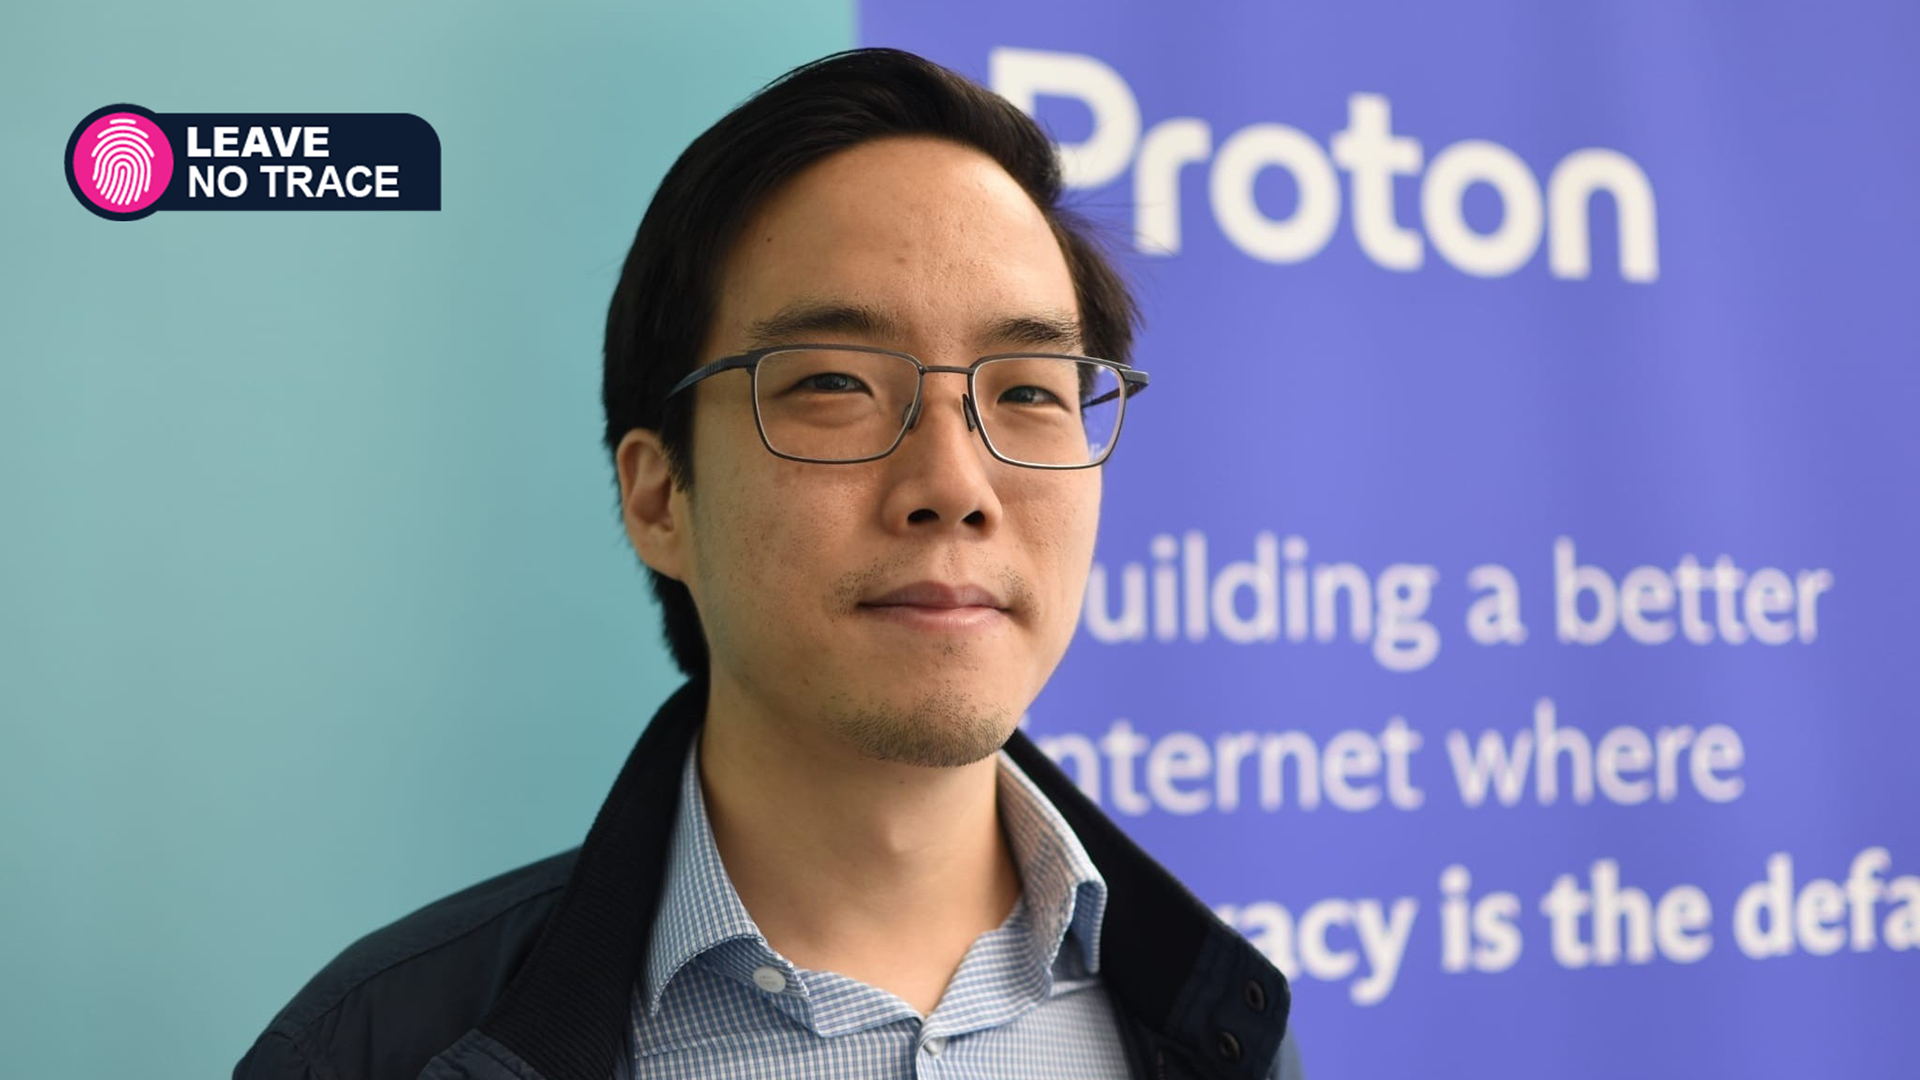
El fundador y CEO de Proton, Andy Yen, es el primero en tomar la palabra, explicando cómo todo empezó en mayo de 2014 con una idea simple: crear un servicio de correo electrónico encriptado. Luego vino Proton VPN. Y hoy, doce años después, la empresa ofrece 11 productos diferentes, incluido su chatbot de IA centrado en la privacidad, Lumo.
A medida que Yen habla, queda claro que Proton ya no se limita a herramientas aisladas: busca crear una alternativa completa a Google, OpenAI y el modelo de Capitalismo de Vigilancia de Silicon Valley. Pero, ¿puede una empresa enfocada en la privacidad competir con los Gigantes de la tecnología en IA, navegadores y vigilancia estatal sin agotarse?
Justo antes de que Yen salga hacia su próxima reunión, me siento con él para conversar sobre ética de la IA, verificación de edad, leyes suizas de interceptación de comunicaciones y el futuro de la libertad digital.
La siguiente entrevista ha sido editada para mayor claridad y extensión.
¿Cuándo te diste cuenta de que Proton Mail era necesario?
Creo que Snowden puso el foco en la vigilancia gubernamental, pero ya era evidente para mí en ese momento que había un problema más grande. En aquella época no quería crear cuentas; no quería porque sabía qué hacían con los datos. No existía una alternativa. Si miras atrás, no había alternativa.
De hecho, si querías un correo privado en línea sin abuso de datos, tenías que alojar tu propio servidor, lo que es extremadamente difícil y, aun así, no habría cifrado. Así que, al inicio, Proton se trataba de crear un servicio que yo mismo deseaba para una audiencia.
Al principio, Proton se trataba de construir un servicio que yo mismo quería para una audiencia
Andy Yen
Lo que notamos es que, tras abrirlo a las primeras mil usuarios, e incluso a empleados de CERN, la gente se fue dando cuenta: “Esto es interesante.” No era solo yo quien quería esto; había una demanda mayor.
El punto de inflexión probablemente fue mayo de 2014. En el primer día se unieron 10,000 personas. Lo mismo ocurrió el segundo día y, en el tercero, el servidor se cayó, lo cual no fue un gran arranque. Pero ese momento marcó el inicio de comprender que se trataba de un tema societal más amplio.
No eran solo unos pocos entusiastas de la privacidad; había un interés real en una alternativa.
Así nace Proton: proporcionar esa alternativa. Ofrecemos muchos de los mismos servicios que las grandes tecnológicas, pero con un modelo de negocio y valores completamente diferentes.
¿Qué tan difícil es construir aplicaciones independientes que compitan en varios mercados al mismo tiempo?
Es difícil porque enfrentamos competidores formidables en cada mercado. Algunos dicen: “Me parece loco entrar en tantos mercados con jugadores grandes ya establecidos.” Pero hacemos las cosas de forma distinta, y ese es el punto clave.
Por supuesto competimos con Google en el correo electrónico, pero nuestro producto es diferente, nuestros valores son diferentes y la seguridad y la privacidad también. Incluso dentro del espacio de VPN, es complicado saber en quién confiar.
Es difícil entender quién realmente mantendrá esos valores a largo plazo, en una industria donde las empresas se compran y venden con frecuencia. Tal vez te guste ExpressVPN, pero luego fue vendida. Es un espacio muy confuso.
La estabilidad de Proton, la adherencia a sus valores durante más de 10 años y la consistencia de lo que defendemos, es una diferenciación y, tal vez, una ventaja.
No temo a la presencia de grandes gigantes en los sectores en los que operamos porque hacemos las cosas de otra manera. Con el tiempo, los clientes valoran esa diferencia.
(Image credit: Proton)
Alentar a los usuarios a adoptar toda la suite de Proton, ¿no implica pedirles que comprometan la compartimentación de datos?
Es difícil encontrar 11 empresas auténticamente confiables; estadísticamente es improbable. Si alguien encuentra 11, probablemente serán compañías más pequeñas que pueden carecer de resiliencia. A veces, en ciertas industrias, es suficiente contar con una sola empresa confiable; encontrar 11 ya es un reto.
Al final, si un usuario considera que su modelo de amenazas requiere distribuir datos entre servicios, está bien que sea así. Espero ser una de las 11 que elija. Pero la gran mayoría de usuarios —probablemente más de la mitad— no quiere gestionar 11 suscripciones. Prefieren tener todo en un solo lugar y confiar en una empresa única, porque encontrar una ya es bastante difícil.
Kinda chic to give a damn about your online privacyAugust 19, 2026
Así que no será para todos, pero creo que para la mayoría es un enfoque correcto.
Hacemos nuestra parte: mantener todo de código abierto, ofrecer mayor seguridad, tener como accionista a una fundación como una capa adicional de seguridad y apoyarnos en nuestro historial.
Llevamos más de 10 años haciendo exactamente lo mismo, y eso es poco común en tecnología. Y, si miramos a los incentivos financieros, somos una organización sin fines de lucro, por lo que no es un negocio impulsado por ganancias. Aun así, incluso desde una perspectiva puramente financiera, no tiene sentido para nosotros hacer algo distinto de lo que sostenemos: la privacidad es lo que permite que la gente pague por nuestros servicios.
En cuanto se compromete ese valor, lo perdemos todo. Financiera y moralmente, nuestros incentivos están alineados con los usuarios, y eso es probablemente la mayor garantía de que Proton permanecerá fiel a su misión a largo plazo. Es una combinación de todos estos factores que no se encuentra en otros espacios del mundo empresarial.
¿Estás contratando expertos en navegadores web? ¿Están construyendo un navegador, y cómo responden al rechazo inicial de la comunidad?
Hacemos mucho trabajo con estándares web y con la web en general porque es necesario. Que Proton esté contratando a alguien con experiencia en navegadores no debe interpretarse como que necesariamente vamos a construir un navegador.
En cuanto a los comentarios, la mayor parte de la retroalimentación decía: “Concéntrate en los productos existentes; ya hay navegadores, no necesitamos más”. Entiendo ese sentimiento y quiero que los productos actuales también sean mejores.
Pero el competidor que queremos reemplazar es Google, y no ganaremos esa batalla mejorando solo uno o dos productos. La única forma de ser competitivos a largo plazo es con un ecosistema.
No construyo un ecosistema porque quiero hacerlo: es una tarea extremadamente difícil y compleja. Es más fácil vender un solo producto y hacerlo muy bien. Pero esa estrategia no cambiaría el statu quo. Por eso debemos avanzar con un enfoque de ecosistema, a pesar de que a la comunidad no siempre le guste.
(Image credit: Future)
NUEVO: Leave No Trace — Un boletín semanal sobre privacidad digital y vigilancia en línea.
Leave No Trace investiga las empresas y los gobiernos que ponen en riesgo nuestra libertad digital —y las personas que luchan por ello.
¿En qué momento te diste cuenta de que el mercado también necesitaba un asistente de IA centrado en la privacidad?
Fue lo mismo que con Proton Mail hace 12 años. Quería usar IA, pero no confiaba en Sam Altman ni en Anthropic. Tampoco iba a usar modelos chinos alojados en servidores chinos. Si no hubiéramos construido Lumo, no podría entrar en la era de la IA.
Creo que hay muchas personas en la misma situación: quieren usar IA y entienden su importancia para el futuro, pero desconfían de los actores actuales.
Lumo es el único chatbot de IA donde tus conversaciones son realmente privadas. No existía hasta que lo construimos.
La recopilación de datos impulsa muchos productos de IA. ¿Qué tan difícil es construir un chatbot de IA centrado en la privacidad?
Podrías decir lo mismo de Gmail: la recopilación de datos fue la razón principal por la que Google creó Gmail. OpenAI también impulsa la publicidad. Pero en realidad, no estamos limitados por su modelo de negocio; estamos limitados por lo que es posible y por lo que los usuarios realmente quieren.
Con Lumo demostramos que es posible crear servicios de IA privados sin capitalismo de vigilancia. Este tipo de capitalismo es una constraint artificial impuesta por Silicon Valley, y no es una limitación real.
En tecnología, la rendimiento a largo plazo suele ser mejor para productos de privacidad porque hay menos restricciones. Algunos muestran anuncios, mientras que un producto sin anuncios es, en definitiva, mejor.
El capitalismo de vigilancia es una constraint artificial impuesta por Silicon Valley
Andy Yen
En el futuro, otros chatbots podrían sugerir compras basadas en redes de anuncios, lo cual no sería la mejor recomendación para ti. Un chatbot que ofrezca resultados imparciales es intrínsecamente mejor.
En definitiva, a largo plazo no es que tengamos más limitaciones, sino más libertad para construir productos que sirvan mejor a lo que los clientes realmente quieren.
¿Por qué decidiste basar Lumo en Alemania en lugar de Suiza?
El año pasado, el gobierno suizo intentó introducir vigilancia masiva en Suiza. Nosotros y gran parte de la industria nos oponemos, lo que llevó a que el gobierno reconsiderara.
Como negocio, no puedes poner todos los huevos en una sola cesta; necesitas diversificación suficiente para que, si la política falla en un país, no estés en una mala situación.
Mudando Lumo fuera de Suiza fue una señal para el gobierno suizo de que la privacidad tiene valor económico real. Al invertir cientos de millones fuera del país, se demostró su importancia económica. La conversación cambió y el valor económico de la privacidad comenzó a considerarse.
Tras esa decisión, el gobierno se vio obligado a realizar una evaluación de impacto regulatorio, la cual mostró que mantener la vigilancia masiva habría costado entre CHF 30 y 40 mil millones en 10 años y habría significado la pérdida de 200,000 empleos. Esto demuestra que la privacidad y la confianza tienen un gran valor económico.
(Image credit: Lumo/Edited with Gemini)
Con las leyes de verificación de edad expandiéndose globalmente, ¿es posible verificar la edad de un usuario sin destruir la privacidad digital?
Antes de preguntar si se puede hacerlo, la pregunta es si debería hacerse. Y no creo que debamos hacerlo.
La razón es simple: no hay verificación de edad para niños sin saber quién es niño o adulto. La única forma de verificar edades de niños es verificar a todos, lo que implica mostrar identificación para usar internet. Si llevas esa lógica al extremo, te metes en un terreno muy peligroso.
Entonces, no deberíamos hacerlo. Pero si los políticos están decididos a hacerlo, ¿hay formas mejores o peores? Sí. El enfoque actual fuerza a todos a mostrar ID para redes sociales, lo que sería el sueño de Mark Zuckerberg.
Para hacerlo bien, debe ser basado en el dispositivo. Ningún dato debe abandonar el dispositivo hacia un servidor central, y cualquier información personal escaneada debe permanecer solo en el dispositivo y no guardarse después de la verificación. Esa es la forma correcta. Pero las empresas de redes sociales no tienen incentivos para hacerlo así.
Si nos sentáramos dentro de cinco años, ¿será Proton recordada como el ecosistema que desafió a Google, o como una lección de expansión demasiado rápida?
Creo que si no expansions no podemos cumplir nuestra misión; pero si expandes demasiado rápido, también puedes morir.
Sin embargo, Proton no recibe capital de venture capital. Tenemos un límite de velocidad financiero natural integrado en nuestra estructura. Por ello, el colapso financiero típico de expansión rápida es imposible en Proton gracias a esa estructura.
Adquirir a Google es difícil por su escala y prácticas anticompetitivas. Pero, creo que eventualmente ganaremos, y la razón se resume en lo que los ciudadanos desean. Nueve de cada diez personas prefieren la visión de Proton para Internet sobre la de Google. Puede tomar décadas, pero creo que la gente se está alejando de Big Tech.
La entrevista continúa destacando la visión de Proton para un internet más privado y descentralizado, su estrategia de múltiples productos y la ética que orienta cada decisión. Este enfoque no solo busca competir con los grandes, sino redefinir qué significa navegar, comunicarse y colaborar en la era digital.
En el mundo de los videojuegos, la música no es un adorno; es una parte estratégica del storytelling y la inmersión. Petri Alanko, compositor de Control Resonant, enfatiza que su participación anticipada en el proyecto, mientras aún trabajaba en Alan Wake 2, contribuyó a un resultado sonoro más cohesionado y expresivo. Este enfoque tempranero permitió que la música se integrara de forma orgánica con la narrativa y el diseño del juego, en lugar de ser un complemento añadido al final del proceso.
Alanko sostiene que cuando los estudios valoran su IP, su historia y su experiencia, deben dedicar tiempo y cuidado a la partitura musical. En sus palabras, “si valoras y respetas tu IP y tu juego… dale mucho amor y tiempo a la música”. Defiende además evitar la “música de IA” y, en su lugar, apostar por una creación musical única y tangible que responda a las necesidades específicas del proyecto.
La entrevista citada destaca que la composición temprana y la colaboración continua entre desarrolladores y músicos puede reducir la necesidad de revisiones extensas y múltiples reuniones, aumentando la coherencia y la calidad del material sonoro. Alanko comenta que ha trabajado con Remedy desde 2004 y que esa relación estable facilita entender las necesidades narrativas y esperar ciertas respuestas creativas, acortando el ciclo de desarrollo de la banda sonora.
Entre sus reflexiones, Alanko apunta que la coherencia de los temas musicales se fortalece cuando el compositor está presente desde fases iniciales. Además, subraya la importancia de un enfoque laboral sostenible: conocer las herramientas, equilibrar la vida personal y profesional, y mantener un alto valor emocional y creativo en cada pieza.
El resultado, sostiene, es una experiencia auditiva que no sólo acompaña la acción, sino que la potencia, sin depender de soluciones genéricas o automatizadas. Alanko también comparte su técnica de capturar sonidos cotidianos para transformarlos en armonías, demostrando que la experimentación y la creatividad pueden generar paletas sonoras únicas y memorables.
Este enfoque factual y humano hacia la composición musical en videojuegos invita a estudios y productores a mirar la música con la seriedad que merece: como un pilar de la experiencia del jugador y del éxito artístico y comercial del proyecto.
La South Africa vs Australia 1st Test de 2026 llega envuelta en una mezcla de historia, táctica y expectativas mediáticas. Ocho años después de aquel escándalo de ball-tampering que sacudió a Australia, este enfrentamiento entre las dos selecciones que lideran el ránking de Test cricket promete no solo batidas y wickets, sino también lecturas sobre resiliencia, liderazgo y forma física de las principales estrellas. A continuación, un repaso profesional para entender cómo seguir la serie, dónde verla y qué historias deben acompañar cada jornada.
Contexto y proyección
– Con Mitchell Starc, Nathan Lyon y Marnus Labuschagne como pilares, Australia intentará mantener la consistencia mostrada en fases previas, a la vez que cruza miradas con una Sudáfrica que llega con una mezcla de talento emergente y experiencia en su propio terreno. El regreso de Anrich Nortje y la presencia de Kagiso Rabada, si logra estar en forma, elevan el voltaje del ataque sudafricano. En el equipo local, Temba Bavuma lidera un grupo que busca demostrar que el dominio de casa sigue siendo una variable decisiva.
– La serie, a tres Test, ofrece un campo de pruebas para jóvenes como Marques Ackerman y para veteranos que aún quieren dejar huella. La forma de Marnus Labuschagne, tras su century reciente en el warm-up, será observada de cerca para confirmar su lugar en el orden de la casa australiana.
Cómo ver la serie: opciones y consideraciones
– Sudáfrica: Supersport cubre la acción localmente, con DStv como la vía principal para quienes están dentro del país. Para los que están fuera de Sudáfrica, las opciones de VPN para mantener el acceso a servicios regionales son una ruta común, aunque siempre deben respetar términos y condiciones de cada plataforma.
– Australia: Fox Cricket facilita la transmisión en cadena abierta para el público australiano, con Kayo Sports como la plataforma de streaming clave, respaldada por una oferta de prueba gratuita que puede facilitar el acceso inicial.
– Reino Unido: Sky Sports lidera la cobertura, con Sky Sports Cricket y Sky Sports Main Event como canales de referencia. También hay alternativas mediante Now Sports con planes Desi y otras opciones de suscripción.
– Estados Unidos: Willow TV continúa como opción principal para la audiencia estadounidense, con alternativas a través de Sling TV (Desi Binge Plus / Dakshin Flex) para quienes buscan paquetes de streaming accesibles.
– India y Asia: FanCode mantiene la vía de visualización en India, complementando con VPN para quienes estén en el extranjero y deseen ver la cobertura habitual.
– Nueva Zelanda: Sky Sport NZ ofrece la transmisión local, con opciones de streaming a través de Sky Sport Now.
Recomendaciones para ver de forma flexible y segura
– Si te encuentras fuera de tu país y necesitas acceder a una cobertura específica, considera el uso de una VPN de confianza para mantener tu acceso a las plataformas a las que estás suscrito. Asegúrate de cumplir con las condiciones del servicio y de las leyes locales.
– Evalúa las pruebas gratuitas disponibles (por ejemplo, Kayo Sports en Australia) para disfrutar de la serie sin costo inicial, siempre que tengas claro el costo tras el periodo de prueba.
– Mantente atento a las actualizaciones de formaciones y lesiones de los jugadores clave, ya que una baja de última hora puede cambiar el equilibrio táctico de cada encuentro.
Análisis táctico y posibles implicaciones entre las filas
– Australia buscará un plan de ataque equilibrado, con un eje de batters que soporte la presión del ataque sudafricano. La gestión de los tiempos de Labuschagne y la respuesta de los flegados se verán a prueba frente a un trío de lanzadores que puede generar complicaciones en los primeros minutos de cada innings.
– Sudáfrica intentará presionar desde el inicio con Rabada y Nortje, apalancando las combinaciones de Maharaj y Harmer para forzar errores y convertir momentos de control en tramos de alto rendimiento.
Preguntas frecuentes (FAQ) y notas finales
– ¿Cuáles son las alineaciones previstas para cada bando? Se pueden consultar los listados oficiales próximos a cada jornada, ya que las formaciones pueden ajustarse por condiciones del pitch y decisiones tácticas.
– ¿Existe alguna opción gratuita para ver la serie? En general, no hay transmisiones completamente gratuitas a nivel internacional; algunos mercados ofrecen periodos de prueba o paquetes promocionales, y para ver el contenido fuera de tu región puede requerirse una VPN, respetando las condiciones de uso de cada servicio.
– ¿Qué impacto puede tener la serie en el ranking mundial? Este tramo de la temporada podría influir significativamente en posiciones de Test cricket, consolidando a Australia y Sudáfrica como contendientes de primer nivel y afectando dinámicas de grupos de clasificación.
En resumen, South Africa vs Australia 2026 1st Test no solo entrega cricket de alto nivel, sino también una vitrina de narrativa acerca de cómo los veteranos lidian con el peso de la historia reciente y cómo los jóvenes intentan escribir un nuevo capítulo. Mantente atento a la cobertura oficial y a las herramientas de acceso para seguir cada pasada de la pelota, cada strike y cada wicket con la claridad y el contexto que exige un duelo entre dos potencias del cricket mundial.
En la superficie, la nueva familia Pixel 11 de Google trae principalmente actualizaciones iterativas sobre la excelente alineación Pixel 10, abarcando todos los modelos. Cada teléfono recibió un nuevo procesador, una pantalla más brillante y mejoras en cámara y software. Estas mejoras son habituales en estos tiempos.
El Pixel 11 estándar es, probablemente, el menos emocionante del grupo, con cambios relativamente menores respecto a su predecesor. Sin embargo, tras pasar un mes con él como teléfono diario, he llegado a la conclusión de que es el modelo que la mayoría de las personas debería comprar.
Y si bien el Pixel 11 tiene mucho a su favor, lo que realmente destaca es lo poco valor adicional que encontré en el más caro Pixel 11 Pro.
El mejor Pixel para la mayoría de las personas
(Image credit: Future | Nico Arboleda)
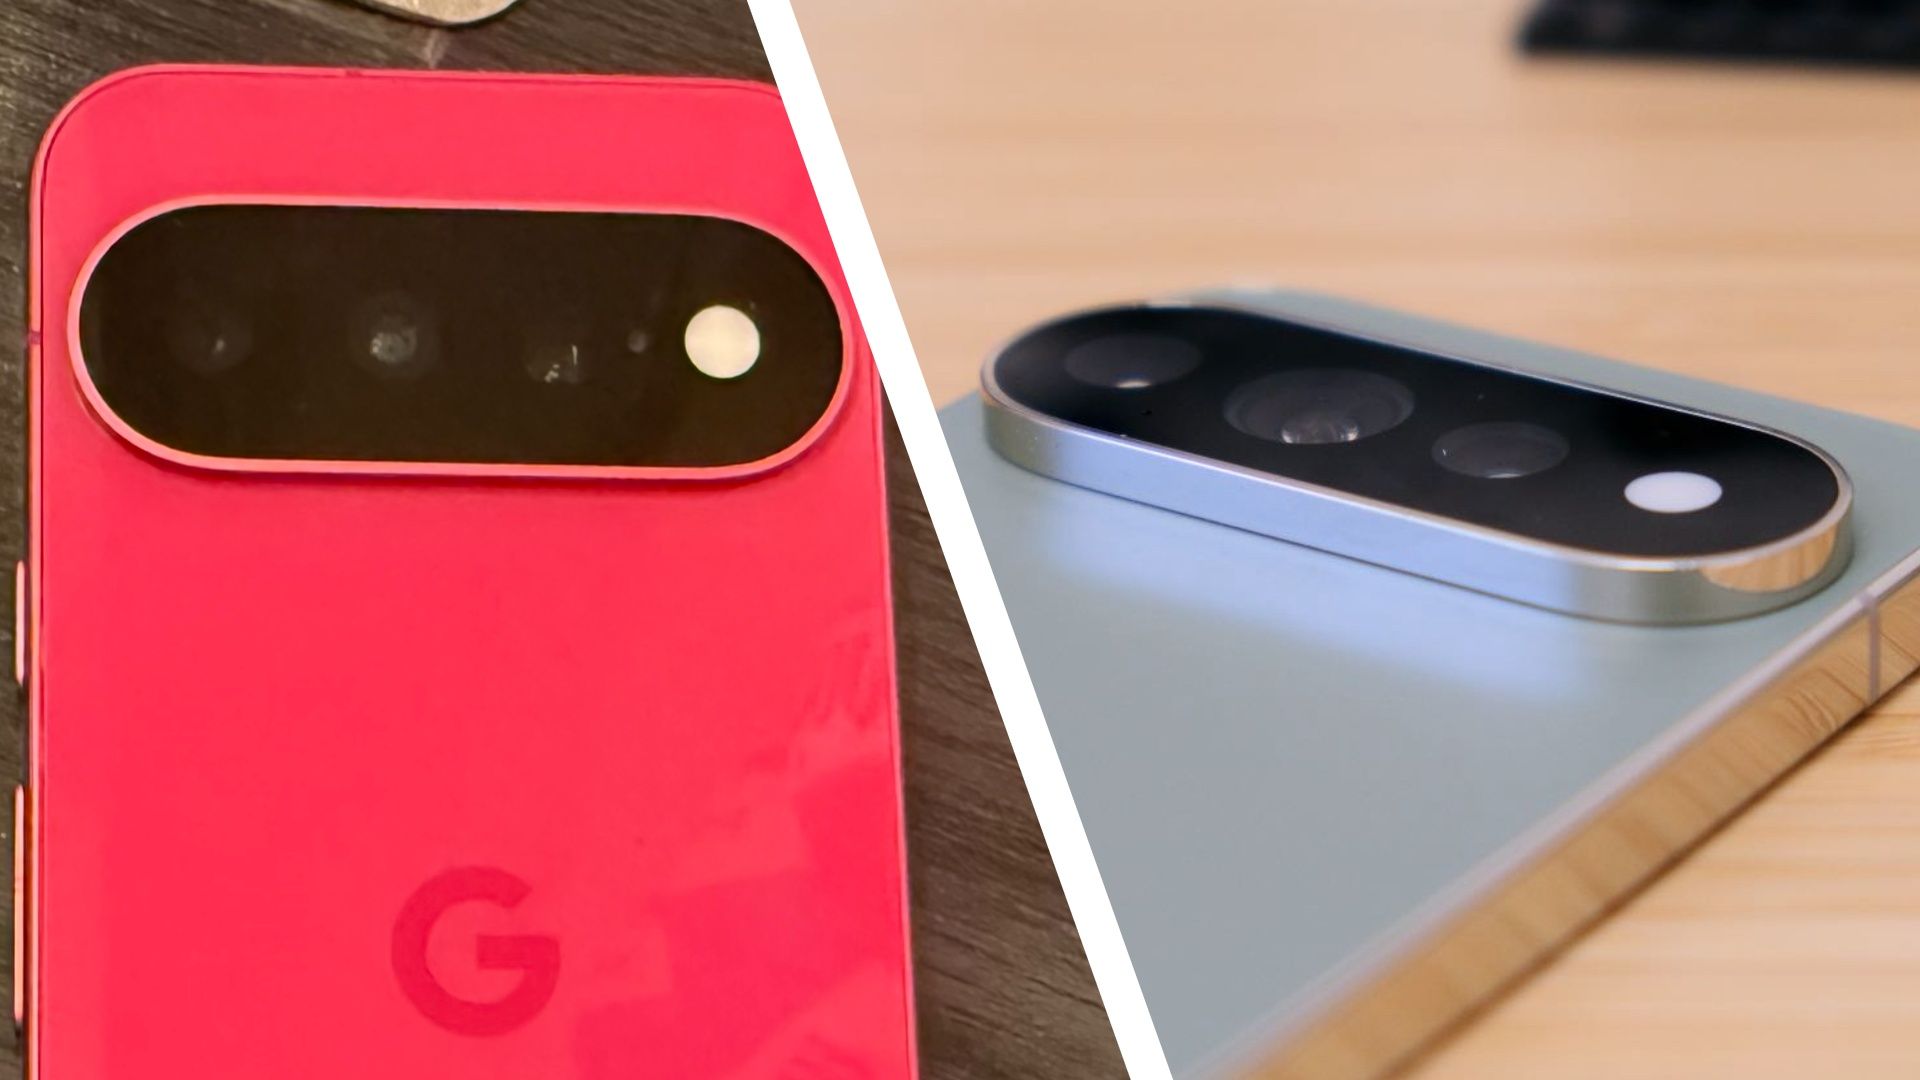
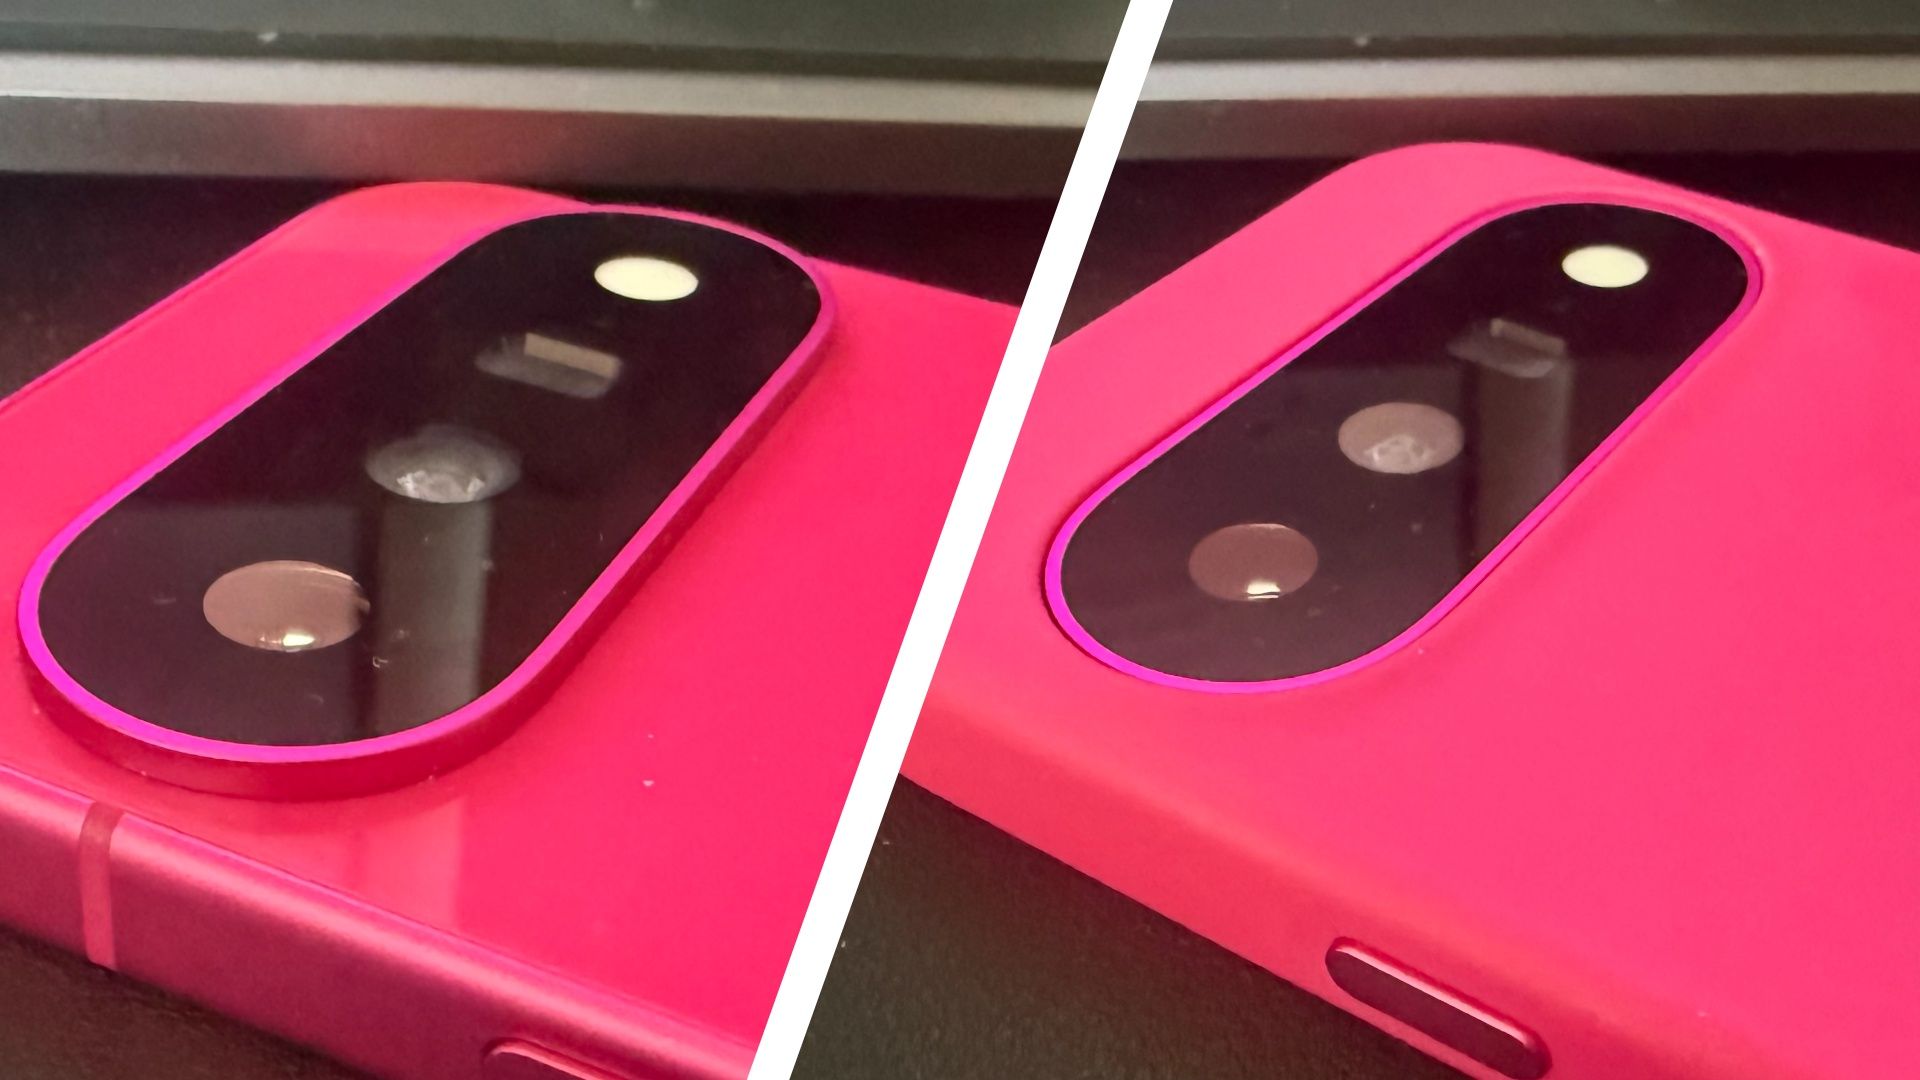
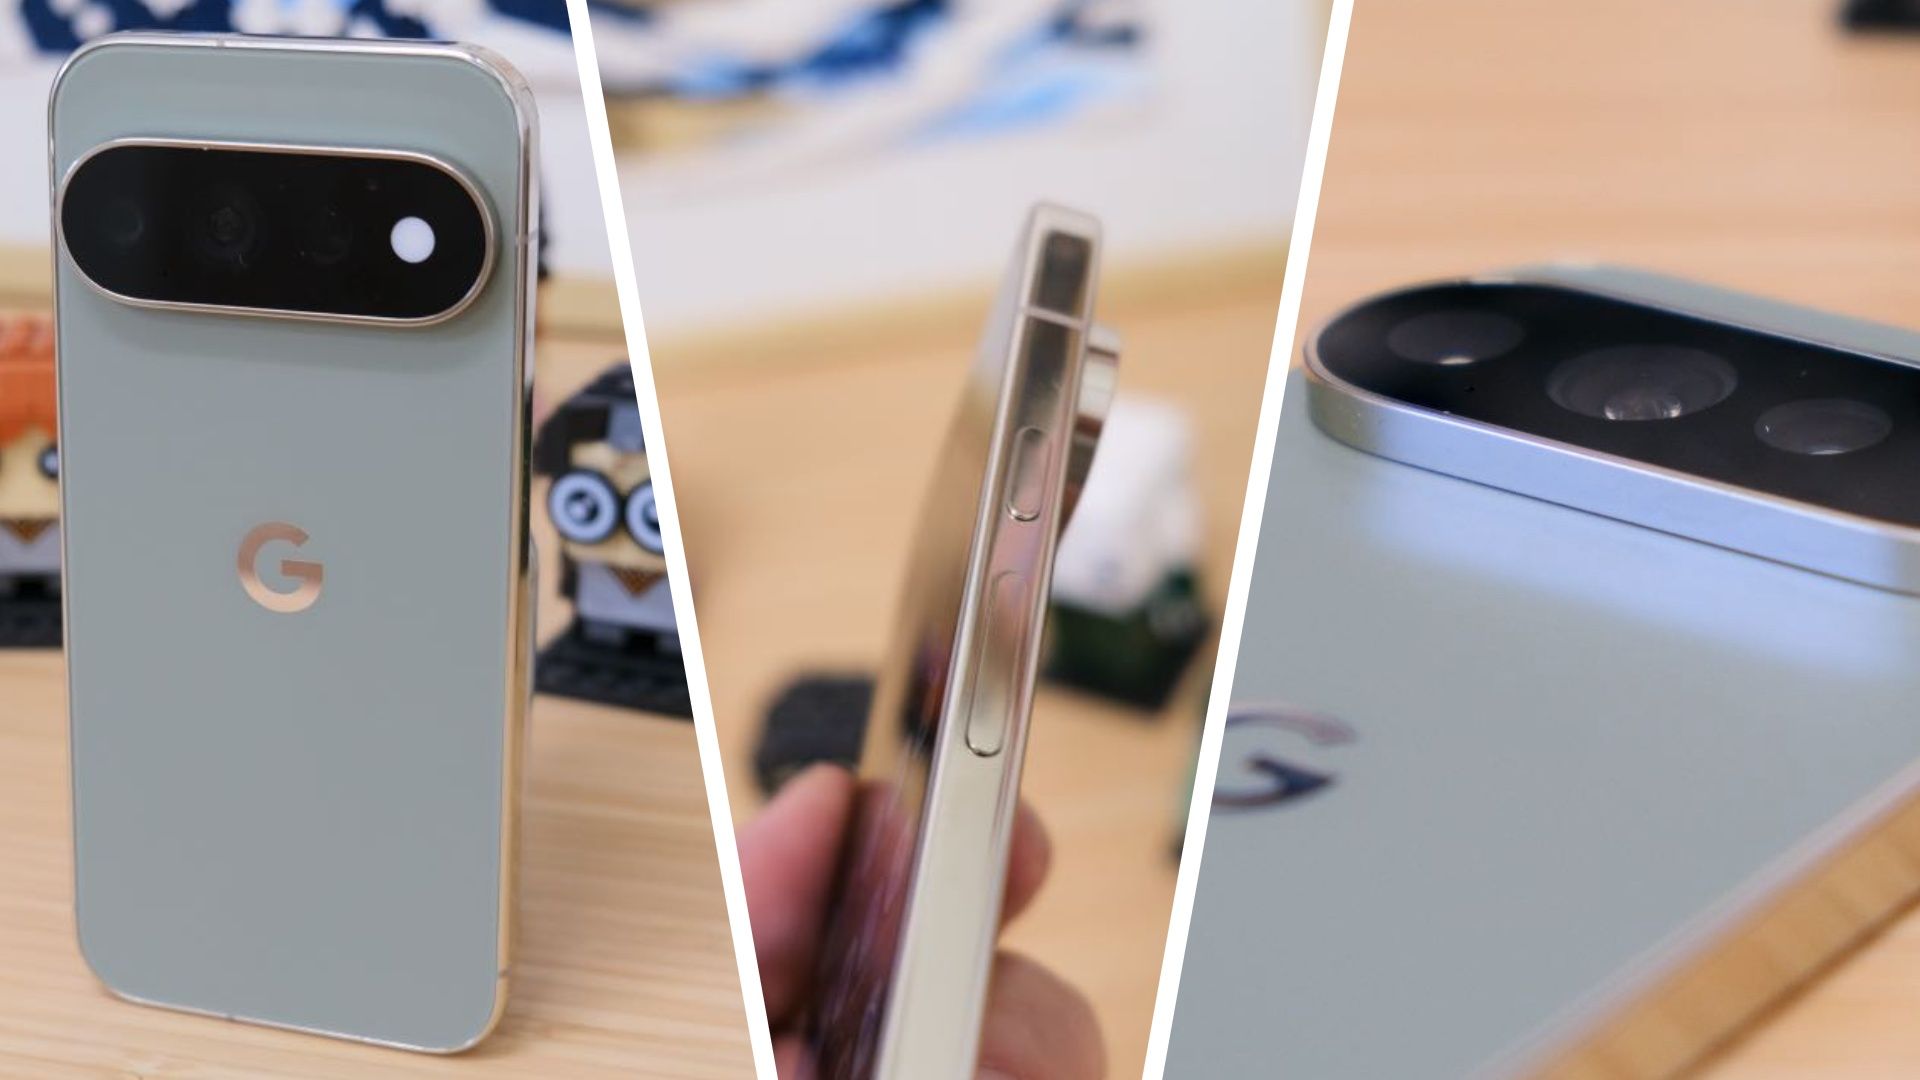
El Pixel 11 se apoya principalmente en la base del Pixel 10, que ya había supuesto un paso importante sobre el Pixel 9, con una cámara teleobjetivo y carga magnética PixelSnap junto a las actualizaciones habituales de chipset y software. A pesar del nuevo chipset Google Tensor G6, el Pixel 11 cuenta con una cámara principal mejorada y una bump de cámara 40% más delgada.
Durante mi prueba, la pantalla compacta de 6.3 pulgadas, el chasis ligero de 197 g y la delgada protuberancia de la cámara hicieron del teléfono un compañero agradable para el día a día. Es un cambio refrescante respecto a los tamaños de pantalla de 6.7 a 6.9 pulgadas que he estado evaluando durante el año.
Mi unidad de prueba llegó en el nuevo color Hibiscus—al que algunos colegas llaman “rosa intenso”—y recibió muchos cumplidos como: “¡Ojalá los iPhone vinieran en ese color!”.
Sus cámaras producen fotos ricas y vibrantes, y disponer de una lente teleobjetivo adecuada es una gran ventaja para un teléfono en este rango de precio. Por supuesto, no dispone de los controles y funciones de cámara más avanzados del Pro, pero el Pixel 11 tiene suficiente tecnología de cámara para la mayoría de usuarios. Este conjunto fotográfico más sencillo también permitió a Google reducir la protuberancia de la cámara, que desaparece cuando se pone una funda.
Quizá la mayor razón para recomendar el Pixel 11 es que, en el uso diario, encontré muy poco que lo distinga del Pro más caro. Ya sea para tareas multitarea, juegos, apps exigentes o funciones de IA, no pude discernir una diferencia de rendimiento significativa entre ambos teléfonos, y dudo que la mayoría de personas lo hagan.
Ambos teléfonos comparten las mismas velocidades de carga por cable de 30 W y carga inalámbrica Qi2 de 25 W (a través de PixelSnap), certificaciones IP68 de resistencia, sensores de huellas ultrasónicos e incluso las mismas siete años de actualizaciones de Android y parches de seguridad.
No eché de menos características como el nuevo LED de notificaciones HiLight, el recubrimiento antiarañazos para el cristal frontal y el soporte de Wi‑Fi 7, y también prefiero los bordes de metal mate del Pixel 11 frente a los brillantes del Pro.
(Image credit: Future | Nico Arboleda)
¿Por qué pagar más por el Pro?
Con un precio inicial de 899 USD / 879 GBP / AU$1,499, el Pixel 11 tiene un punto de entrada más alto que el Pixel 10 del año anterior, que se lanzó a 799 USD / 799 GBP / AU$1,349. Sin embargo, la versión base ahora incluye 256 GB de almacenamiento en lugar de 128 GB, lo que ayuda a suavizar el golpe. El Pixel 10 de 256 GB se lanzó a 899 USD / 899 GBP / AU$1,499, por lo que técnicamente no hay aumento de precio para la misma capacidad, y los compradores del Reino Unido incluso obtuvieron una reducción de £20.
El Pixel 11 Pro, mientras tanto, parte de 1,099 USD / 1,079 GBP / AU$1,849, aproximadamente el mismo precio que el Pixel 10 Pro de 256 GB (el Reino Unido lo tuvo a 999 GBP). Sin embargo, hay un cambio cuestionable: la versión base del Pixel 11 Pro ahora viene con 12 GB de RAM, frente a los 16 GB del año pasado. Esa es la misma cantidad de RAM que se encuentra en el Pixel 11.
No es que 12 GB de RAM no sean suficientes; mi experiencia con ambos teléfonos sugiere que lo son. El problema es que Google ha eliminado una de las especificaciones que antes justificaban un precio más alto del Pro, sin reducir ese precio para compensarlo. Cuando el Pixel 11 más barato ofrece el mismo rendimiento cotidiano, se vuelve cada vez más difícil ver a dónde va ese extra de 200 USD / 200 GBP / 350 AU$.
(Image credit: Future)
Eso no quiere decir que el Pixel 11 Pro no tenga ventajas. Su sistema de cámaras más sofisticado seguramente atraerá a entusiastas de la fotografía, mientras que funciones como Wi‑Fi 7 y HiLight le ofrecen algunos trucos adicionales. Si esas funciones son importantes para ti, el Pro sigue siendo una opción sólida. Pero después de un mes con el Pixel 11 estándar, no puedo decir que me haya visto deseando gastar más dinero.
Al menos las variantes de 512 GB y 1 TB del Pro conservan las 16 GB de RAM que tenía el modelo del año pasado, lo que podría resultar atractivo para quienes exigen mayor margen de rendimiento. Sin embargo, también cuestan 1,219 USD / 1,199 GBP / AU$2,049 y 1,449 USD / 1,429 GBP / AU$2,399, respectivamente, por lo que requieren una mayor inversión.
Para la mayoría de las personas, sin embargo, el Pixel 11 más barato es la compra más inteligente. Ofrece el mismo rendimiento cotidiano y muchas de las mismas características que el Pixel 11 Pro de 256 GB, a la vez que ahorra 200 USD / 200 GBP / 350 AU$.
Pudiera verse como una actualización relativamente aburrida respecto al Pixel 10, pero eso no evita que sea el Pixel más convincente de la nueva gama de Google.