ssh-keysign-pwn: un nuevo episodio en la seguridad del kernel Linux y las lecciones para la administración


La reciente cadena de fallos de seguridad en Linux ha sumado un nuevo capítulo con la aparición de ssh-keysign-pwn, una vulnerabilidad que se añade a otras como Dirty Frag, Copy Fail o Fragnesia. Este problema reaviva la atención sobre la seguridad del kernel y la necesidad de mantener los sistemas al día, especialmente en entornos profesionales y de administración pública. En los últimos días se observa un aumento notable de investigaciones centradas en el kernel Linux, las cuales están destapando errores que permiten desde escaladas locales de privilegios hasta el acceso indebido a información crítica. ssh-keysign-pwn destaca porque, aunque el atacante no obtenga directamente permisos de superusuario, consigue un resultado igualmente preocupante: la lectura de archivos propiedad de root desde cuentas sin privilegios.

Qué es ssh-keysign-pwn y por qué es tan preocupante
El fallo conocido como ssh-keysign-pwn es una vulnerabilidad en el kernel Linux que posibilita a un usuario sin privilegios leer archivos que pertenecen a la cuenta root. A diferencia de otros exploits más complejos que requieren condiciones muy específicas o carreras de concurrencia difíciles de reproducir, este problema se considera especialmente delicado porque abre la puerta a la exposición silenciosa de información sensible.
Según los primeros análisis técnicos, la vulnerabilidad se enmarca dentro de la misma oleada de problemas que han salido a la luz recientemente en el ecosistema Linux, como Dirty Frag, Copy Fail o Fragnesia. En estos casos, se explotan errores lógicos en componentes internos del kernel para lograr efectos no previstos por los desarrolladores, como escrituras arbitrarias sobre páginas de memoria marcadas como de solo lectura o la lectura de datos que deberían estar completamente protegidos.

Alcance de la vulnerabilidad en el kernel Linux
Una de las características más alarmantes de ssh-keysign-pwn es su amplia difusión. Los reportes publicados indican que todas las versiones del kernel Linux se ven afectadas por el fallo, incluido el estado más reciente del código en Git en el momento de su descubrimiento. Esto implica que no se trata de un problema aislado de una rama antigua o de una configuración muy específica, sino de una debilidad que ha acompañado al kernel durante varias versiones.
El impacto potencial es significativo, ya que la vulnerabilidad permite el acceso no autorizado a archivos propiedad de root. En la práctica, esto puede traducirse en la lectura de ficheros con secretos de configuración, claves privadas, credenciales o información sensible del sistema que, combinada con otros vectores de ataque, podría facilitar movimientos laterales, escaladas de privilegios o la preparación de ataques dirigidos contra servicios concretos.
Para las organizaciones que dependen de Linux en entornos críticos, como centros de datos, instituciones públicas o empresas que operan infraestructuras en la nube, este tipo de fallo puede afectar tanto a la integridad como a la confidencialidad de los datos alojados en sus servidores. Aunque la explotación requiere acceso local, en entornos multiusuario o con servicios expuestos puede convertirse en un punto de apoyo para intrusiones más graves.

Descubrimiento de ssh-keysign-pwn y respuesta de la comunidad de seguridad
La vulnerabilidad ssh-keysign-pwn ha sido reportada por investigadores de la firma de seguridad Qualys, una compañía conocida por su trabajo en auditoría y análisis de vulnerabilidades a gran escala. Su investigación ha permitido identificar cómo un usuario sin privilegios podría aprovecharse de un comportamiento concreto del kernel para leer archivos que deberían estar reservados exclusivamente a root.
Tras la notificación responsable, los desarrolladores del kernel Linux han trabajado en un parche que ya ha sido integrado en la rama principal (mainline) del proyecto. La corrección pasa por ajustar de manera precisa el comportamiento de determinadas llamadas y rutas internas del kernel, en particular con relación a cómo se maneja el acceso y la inspección de procesos, de forma que se bloquee el escenario que hacía posible el exploit.
Como parte de la respuesta coordinada, se ha puesto a disposición de la comunidad documentación técnica y análisis detallados tanto del exploit como del fix. Esta información se ha publicado en un repositorio público de GitHub, lo que permite a administradores de sistemas, equipos de seguridad y desarrolladores revisar con calma cómo funciona el ataque y qué cambios introduce el parche, facilitando su validación e integración en distintas distribuciones.

Detalles técnicos de ssh-keysign-pwn: cambios en el comportamiento de ptrace
Uno de los elementos clave de la corrección desarrollada por los mantenedores del kernel es la modificación del comportamiento de ptrace, la interfaz que se utiliza habitualmente para depurar procesos o monitorizar su ejecución. Según los datos disponibles, el exploit se apoyaba en una combinación específica de operaciones que permitían sortear las comprobaciones habituales y terminar accediendo a contenidos de archivos propiedad de root.
El nuevo parche introduce restricciones adicionales y ajustes en la lógica interna del kernel para impedir que se materialice ese escenario. Aunque los detalles de bajo nivel son complejos y van dirigidos principalmente a desarrolladores y expertos en seguridad, la idea de fondo es que se cierran las vías que permitían el uso indebido de mecanismos de depuración y observación de procesos para romper el aislamiento entre usuarios sin privilegios y recursos propiedad de root.
Este tipo de correcciones suele ir acompañado de una revisión más amplia de las rutas de código relacionadas, para reducir el riesgo de que existan variantes del mismo problema. No obstante, como se ha visto con Dirty Frag, Copy Fail o Fragnesia, la superficie de ataque del kernel Linux es enorme, por lo que resulta razonable esperar que en los próximos meses sigan apareciendo nuevas investigaciones y parches asociados.

Recomendaciones prácticas para administradores de sistemas
Para administradores de sistemas y responsables de seguridad, los pasos a seguir ante ssh-keysign-pwn pasan por una combinación de acciones inmediatas y medidas a medio plazo. En el corto plazo, la prioridad es asegurarse de que todos los sistemas afectados reciban el kernel corregido tan pronto como los repositorios de la distribución lo ofrezcan.
Mientras tanto, conviene revisar qué usuarios tienen acceso local a los servidores y equipos Linux, ya que el exploit requiere partir de una cuenta sin privilegios en el sistema. Reducir al mínimo las cuentas innecesarias, aplicar el principio de privilegio mínimo y monitorizar los accesos puede ayudar a limitar el impacto de un posible intento de explotación.
Adicionalmente, es buena práctica mantener un seguimiento activo de las listas de correo y canales oficiales de seguridad de las distribuciones Linux utilizadas, así como de etiquetas o secciones específicas dedicadas a vulnerabilidades en medios especializados. Esta vigilancia facilita reaccionar con rapidez cuando aparecen nuevos fallos como ssh-keysign-pwn o Fragnesia.

Transparencia, investigación continua y papel de la comunidad
El caso de ssh-keysign-pwn vuelve a poner de relieve el papel clave que juega la comunidad de desarrolladores e investigadores en el ecosistema Linux. La combinación de empresas de seguridad, mantenedores del kernel y distribuidores permite que vulnerabilidades graves se identifiquen, documenten y corrijan en plazos relativamente ajustados.
La publicación de análisis técnicos en repositorios públicos ayuda, además, a que otros expertos puedan revisar los hallazgos, reproducir los entornos de prueba y evaluar el alcance real de los exploits. Esta transparencia, aunque en ocasiones pueda parecer que expone en exceso los detalles de los fallos, contribuye a mejorar la robustez general del sistema, ya que anima a una revisión constante del código y a la búsqueda proactiva de errores similares.
En un momento en el que Linux se ha consolidado como pilar de buena parte de la infraestructura digital, este tipo de incidentes también sirve como recordatorio de que ningún sistema es infalible. Las organizaciones que dependen de Linux deben asumir que la gestión de vulnerabilidades es un proceso continuo, no una tarea puntual que se resuelve con un único parche.
La aparición de ssh-keysign-pwn, junto con vulnerabilidades emparentadas como Dirty Frag, Copy Fail y Fragnesia, dibuja un panorama en el que la seguridad del kernel Linux está bajo escrutinio constante. Mantener los sistemas actualizados, reforzar los controles de acceso, seguir de cerca las publicaciones de parches y apoyarse en la información técnica disponible se ha convertido en una rutina imprescindible para minimizar riesgos y conservar la confidencialidad e integridad de los datos en servidores y equipos que ejecutan Linux.

from Linux Adictos https://ift.tt/eAymVxD
via IFTTT

Picturing Earth in a New Light: Nuevas Perspectivas sobre la Luz Nocturna y su Significado Global

Maps can show more than just where things are—they can also show how things change. New maps of artificial light reveal a planet that has been reshaping its nights through patterns of brightening and dimming.

Este análisis se apoya en el conjunto de datos Black Marble de NASA, que muestra que la iluminación artificial nocturna no aumenta de forma uniforme a nivel mundial. En lugar de una subida constante durante casi una década, las dinámicas nocturnas son complejas: zonas de crecimiento rápido, contracciones de iluminación en otras áreas y cambios impulsados por políticas públicas, migraciones urbanas y mejoras en eficiencia energética.

La tecnología de observación VIIRS (Visible Infrared Imaging Radiometer Suite) a bordo de los satélites Suomi-NPP, NOAA-20 y NOAA-21 permite generar registros de luces nocturnas a escalas diarias, mensuales y anuales. El canal diurno-nocturno detecta la luz en un rango de longitudes de onda que abarca desde verde hasta cercano al infrarrojo cercano, aplicando filtros para distinguir señales como luces de ciudad, luz de la luna y auroras.

El mapa principal muestra cambios de brillo en la mayor parte del mundo habitado (de 60° S a 70° N). Las zonas en amarillo y oro indican mayor iluminación en el periodo 2014–2022, mientras que las áreas en púrpura señalan dimisiones de brillo. Una visualización adicional aplica la misma base de datos al Hemisferio Oriental, e incorpora toques artísticos como simulaciones de luz solar y sombras. Este enfoque combina rigor científico con una narrativa visual que facilita la comprensión de tendencias complejas a gran escala.

Los hallazgos clave revelan que, a nivel global, la radiancia aumentó un 34% durante el periodo estudiado, pero este incremento masivo oculta extensas zonas de disminución. Este fenómeno de “cambios bidireccionales” ocurre a la vez en distintas regiones: por ejemplo, algunas ciudades de la Costa Oeste de Estados Unidos se volvieron más brillantes por crecimiento poblacional, mientras que partes de la Costa Este mostraron atenuación, atribuible a una mayor adopción de LEDs eficientes y a reestructuraciones económicas regionales.

En términos internacionales, el estudio identifica aumentos de iluminación en China y el norte de India asociados al desarrollo urbano, mientras que países como Francia, el Reino Unido y los Países Bajos experimentaron reducciones significativas de iluminación nocturna, en parte gracias a políticas de eficiencia energética y cambios estructurales. Durante la crisis energética europea de 2022, la iluminación nocturna en Europa también mostró una caída notable.

Versiones ampliadas de los mapas están disponibles para descarga, y animaciones que muestran cambios anuales pueden obtenerse desde el Scientific Visualization Studio de NASA. El estudio y sus visualizaciones han sido destacados en publicaciones científicas, reforzando la capacidad de las imágenes nocturnas para ilustrar la dinámica humana sobre la faz de la Tierra.

En síntesis, las imágenes nocturnas no solo nos dicen dónde estamos, sino cómo estamos cambiando. La capacidad de observar la luz de la noche a lo largo de casi una década revela una Tierra que evoluciona con ritmos variables, impulsados tanto por el progreso económico como por respuestas políticas y tecnológicas a los retos energéticos y ambientales.

Referencias y recursos incluyen publicaciones en Nature, informes de NASA y materiales de Visualización Científica de NASA. Estas fuentes respaldan una lectura informada de la relación entre iluminación nocturna y desarrollo humano, ofreciendo una ventana única para entender la transición energética global.

from Technology – NASA https://ift.tt/OSC9Bn7
via IFTTT

Una postura clara ante la expansión de Mercedes en la F1: ¿cambiará el juego?


¡Qué noticia más interesante para el universo de la Fórmula 1! El CEO de McLaren Racing ha dejado una declaración contundente sobre la posibilidad de que Mercedes adquiera una participación en un segundo equipo de F1. En un deporte donde las dinámicas entre fabricantes pueden redefinir la competencia, este posicionamiento aparece como un acto estratégico y transparente que podría marcar el ritmo de las próximas temporadas.

Por un lado, la tolerancia actual hacia el modelo Racing Bulls ha permitido que exista una estructura que, para muchos, funciona a la perfección desde hace dos décadas. Pero la pregunta clave es: ¿esa tolerancia es sostenible a medio y largo plazo? Aquí es donde surgen las sospechas y, sobre todo, las preocupaciones sobre equidad competitiva y el equilibrio entre equipos.

Las fuentes confirman que Zak Brown habría enviado una carta de seis páginas, una maniobra que llega para encender el debate y reforzar la posición de McLaren frente a posibles movimientos de los grandes fabricantes. Aunque los detalles completos se han mantenido entre bastidores, el tono y la intensidad de la comunicación solicitada dejan claro que no se trata de una discusión menor: se busca claridad, reglas claras y una visión compartida sobre el futuro del campeonato.

Este tema no solo captará la atención de los fans, sino también de inversores, equipos y reguladores. En una temporada donde cada decisión puede influir en la paridad, la sostenibilidad y la identidad de la F1, la postura de McLaren podría actuar como un punto de inflexión. ¿Qué significa esto para la estructura competitiva que ha definido a la F1 durante años? ¿Cómo responderán otros equipos y la Federación Internacional de Automóviles ante un posible cambio en el status quo?

Para quienes siguen de cerca el pulso de la competición, este podría ser el inicio de un ciclo de diálogo intenso y negociaciones estratégicas. Mantente atento, porque el deporte que amamos está en un cruce de caminos y cada decisión podría escribir un nuevo capítulo en la historia de la Fórmula 1. Sigue leyendo para no perderte los próximos movimientos y declaraciones que seguramente darán forma a la conversación global sobre la gobernanza, la competencia y el futuro de la categoría.
from Motorsport.com – Formula 1 – Stories https://ift.tt/6U81LpG
via IFTTT IA

La sorprendente historia detrás del robo del Cadillac de Valtteri Bottas durante el fin de semana de Miami


¡Qué historia tan increíble y llena de giros! Valtteri Bottas, el piloto finlandés de Cadillac en la Fórmula 1, reveló un episodio que suena como sacado de una película: su coche fue sustraído durante el fin de semana del Gran Premio de Miami. La situación dejó al ladrón con un pase de paddock y un pase de estacionamiento VIP, y hasta participaron investigadores del FBI.

Según Bottas, el Cadillac Escalade proporcionado por el equipo desapareció de la entrada de su Airbnb mientras él celebraba la llegada con la gente de la comunidad y, a la vez, grababa para el podcast What’s Next con Paul Ripke de Cadillac. Es una historia que mezcla glamour, adrenalina y un poco de caos logístico, recordándonos que incluso en el mundo de las altas velocidades, los imprevistos pueden golpear en cualquier momento.

Lo que sigue a este increíble episodio es una mezcla de misterio y responsabilidad. El equipo y las autoridades gestionaron la situación con seriedad, asegurando que se tomaran las medidas necesarias para localizar el vehículo y evaluar los daños, y por supuesto, entender exactamente qué pasó para que un coche de lujo apareciera en tal revuelo.

La participación del FBI añade un toque de intriga a la historia: ¿qué investigaciones están en juego cuando un coche de un equipo de Fórmula 1 termina en manos equivocadas durante un evento internacional tan visto? Este detalle subraya la magnitud del incidente y el nivel de escrutinio que acompaña a la escena de la F1 hoy en día.

En resumen, este episodio no solo nos habla de un robo más, sino de cómo el mundo del motorsport opera bajo una luz mediática intensa, con podcasts, endorsements, y una cobertura que no tiene tregua. Si te interesa conocer todos los detalles, te invito a seguir leyendo sobre cómo se desarrolló la historia, qué pasos dio el equipo para asegurar la recuperación del vehículo y qué consecuencias podría tener este incidente para futuras operaciones logísticas durante grandes eventos.

Keep reading: La historia completa continúa revelando el alcance de la investigación y las medidas que se están tomando para prevenir que algo similar vuelva a ocurrir durante los próximos fines de semana de carrera.
from Motorsport.com – Formula 1 – Stories https://ift.tt/ed3MiGR
via IFTTT IA

Red Bull: Desafío en las primeras carreras y la chispa del avance en el motor


¡La temporada empezó con una montaña rusa para Red Bull! Las primeras jornadas de carrera exigieron a fondo a la estructura en chasis, marcando un inicio desafiante que puso a prueba la paciencia y la ingeniería del equipo. Sin embargo, la pausa de abril llegó como un respiro estratégico: un momento clave para evaluar, ajustar y afinar. Y vaya que hicieron los deberes. El progreso no tardó en hacerse visible, dejando a rivales y aficionados asomados a sus pantallas, sorprendidos por la capacidad de evolución del equipo en el eje del rendimiento dinámico.

Pero la historia no terminó ahí. En el frente de la unidad de potencia, Red Bull encontró un terreno fértil para sorprender. Aunque las palabras de Toto Wolff en Baréin —que describieron a Red Bull como el “estándar absoluto”— tenían un dejo político, lo cierto es que subrayaron una realidad: el equipo no solo trabajó en el chasis, sino que afinó la máquina que impulsa sus vueltas. Esa doble vía de mejoras dejó claro que la rapidez no depende de una sola pieza; es la sinergia entre aerodinámica, chasis y potencia la que puede marcar la diferencia en la pelea por las posiciones delanteras.

Con cada kilómetro ganado, la confianza se solidifica y las expectativas se elevan. Este año, Red Bull demostrará que la innovación continua y la capacidad de adaptarse a las exigentes condiciones de cada pista pueden convertir un inicio complicado en una historia de resiliencia y triunfo. Keep reading para seguir el pulso de un equipo que está decidido a convertir cada desafío en una oportunidad, y que continúa empujando los límites de lo posible en la Fórmula 1. Keep reading
from Motorsport.com – Formula 1 – Stories https://ift.tt/zKVjbcJ
via IFTTT IA

Williams confía en una remontada: puntos constantes tras el parón estival


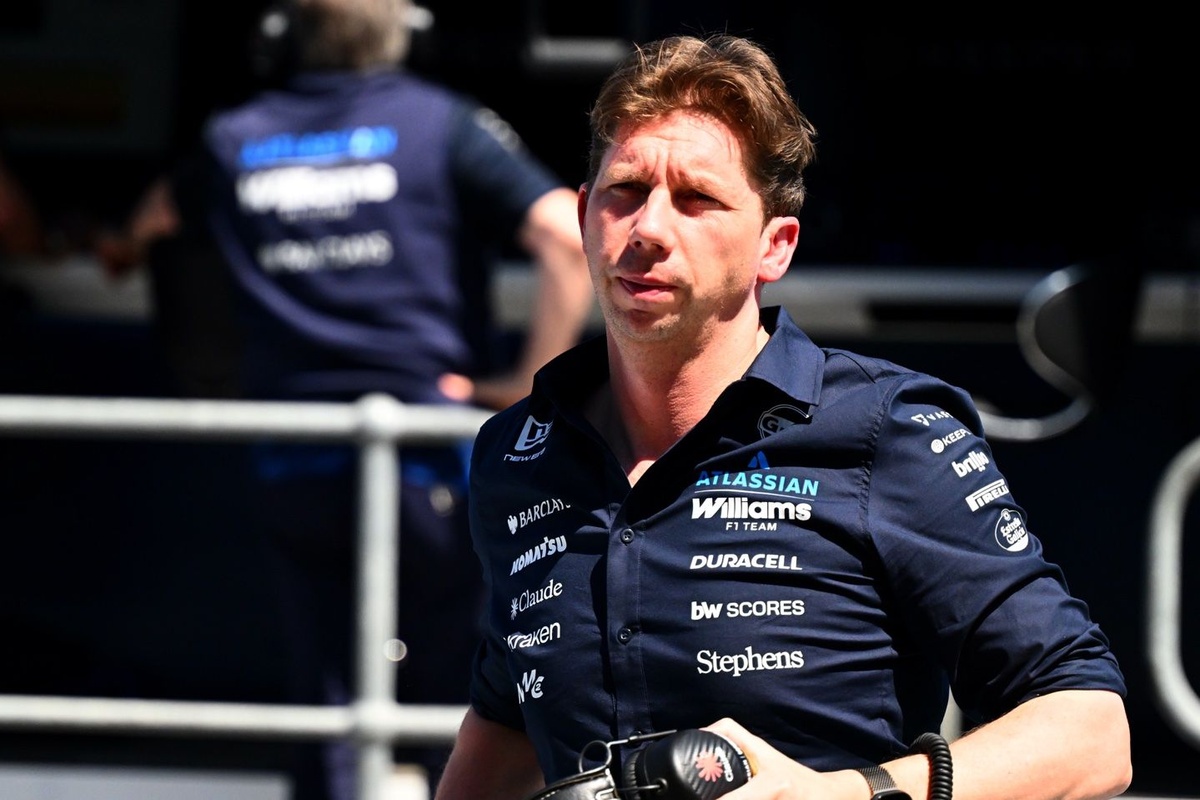
¡Gran noticia para Williams! James Vowles, el principal del equipo, está convencido de que la escudería Grove puede lograr puntuaciones consistentes a partir de la segunda mitad de la temporada tras el parón del verano en agosto. Después de un inicio turbulento en la temporada 2026 debido a retrasos en el FW48, Vowles confía en que el equipo dará la vuelta a la situación y subirá el rendimiento para lo que queda de año. La pausa de cinco semanas entre el Gran Premio de Japón y el de Miami fue un periodo crucial para reajustar estrategias y preparar el coche para los próximos circuitos. Este respiro, combinado con mejoras técnicas y una optimización de la gestión de carrera, podría marcar el inicio de una racha de puntos constante para Williams. Mantente atento a las actualizaciones y a las mejoras que irán llegando, porque el equipo está decidido a demostrar su capacidad de competir al más alto nivel y a fortalecer su posición en el campeonato. Más detalles en la lectura completa.
from Motorsport.com – Formula 1 – Stories https://ift.tt/kSQ1xhe
via IFTTT IA

Winpodx: ventanas de Windows en Linux con integración nativa y contenedores

WinPodX

Si usas Linux a diario pero sigues dependiendo de aplicaciones de Windows para trabajar, es muy probable que te hayas peleado con máquinas virtuales lentas, configuraciones raras de Wine o soluciones que prometen mucho y luego se rompen a la mínima. En ese contexto aparece Winpodx, un proyecto open source que está llamando bastante la atención porque ofrece justo lo que muchos llevaban años pidiendo: abrir programas de Windows en Linux como si fueran ventanas nativas, sin historias raras.

Winpodx se presenta como una pieza clave para quienes viven entre Linux y Windows: desarrolladores, equipos técnicos, administradores de sistemas o simplemente usuarios avanzados que quieren tener lo mejor de los dos mundos sin cambiar de sistema operativo. En lugar de ser “otra máquina virtual más”, apuesta por contenedores y una integración profunda con el escritorio Linux, hasta el punto de que los iconos de las apps de Windows aparecen en tu menú de aplicaciones y se asocian a tipos de archivo como si fueran nativas.

¿Qué es Winpodx y por qué todo el mundo habla de ello?

Winpodx es un proyecto de código abierto (licencia MIT) creado por kernalix7 y publicado en GitHub, cuyo objetivo es ejecutar aplicaciones de Windows en Linux con la máxima integración posible y la mínima fricción. A diferencia de Wine o CrossOver, no intenta traducir llamadas de la API de Windows al entorno Linux, sino que levanta un Windows real dentro de un contenedor y solo te enseña las ventanas de las aplicaciones en tu escritorio.

La diferencia clave es que Winpodx usa contenedores Docker/Podman en lugar de VMs completas. Por debajo, parte de la imagen dockur/windows para levantar un entorno Windows optimizado, y utiliza FreeRDP RemoteApp (RAIL) para mostrar cada app como una ventana separada, con su icono, su entrada en el menú y su propia asociación de archivos. Eso significa que puedes hacer clic en el icono de Word en tu menú de aplicaciones de GNOME, KDE, Sway o Hyprland, y se abrirá una ventana “normal” de Word como si fuera una app de Linux más.

Esta aproximación lo coloca en una especie de punto medio: más compatible que Wine y más ligero e integrado que una máquina virtual clásica. No tienes que descargar manualmente ISOs, pelearte con configuraciones de RDP o lidiar con escritorios remotos a pantalla completa. El proyecto busca que el usuario solo vea “haz clic en el icono y arranca la app de Windows”, y todo el follón técnico se quede escondido en la trastienda.

Arquitectura técnica de Winpodx: cómo funciona por dentro

La arquitectura de Winpodx se apoya en tres bloques principales que trabajan en conjunto para crear la ilusión de que las apps de Windows son nativas en Linux: el contenedor de Windows, el uso de FreeRDP RemoteApp y la capa de control (CLI + GUI Qt6) en el host.

Contenedor de Windows con dockur/windows

El corazón del sistema es un entorno Windows ejecutándose dentro de un contenedor basado en la imagen dockur/windows. Esta imagen sirve como base para desplegar una instalación de Windows que se somete a un proceso automatizado: descarga de ISO oficial de Microsoft, ejecución de Sysprep, aplicación de ajustes OEM y una fase de “debloat” donde se recortan servicios y componentes innecesarios (telemetría, anuncios, Cortana, indexación de búsqueda, etc.) para ganar rendimiento.

Ese contenedor se integra con motores como Podman (por defecto), Docker o incluso libvirt/KVM según la configuración, y se trata como otro servicio más en tu infraestructura de contenedores. La idea es que puedas orquestarlo, monitorizarlo y hacer logging con las mismas herramientas que ya usas en tu stack.

FreeRDP RemoteApp: ventanas de Windows como si fueran nativas

Para proyectar las aplicaciones de Windows al escritorio Linux, Winpodx recurre a FreeRDP con soporte RemoteApp (RAIL). En lugar de mostrar un escritorio completo remoto, RAIL se encarga de que cada aplicación sea una ventana independiente, con sus bordes, botones de cerrar/minimizar y gestión normal en el gestor de ventanas de Linux.

Winpodx configura automáticamente los parámetros de FreeRDP, incluyendo audio vía ALSA, portapapeles bidireccional, impresoras compartidas y acceso a carpetas (por ejemplo, el directorio personal se expone como \\tsclient\home). Además, las unidades USB conectadas en el host se montan dentro del Windows invitado con letras de unidad (E:, F:, etc.), utilizando un FileSystemWatcher del lado Windows que reacciona incluso a unidades conectadas después de arrancar la sesión.

CLI y GUI Qt6 para controlarlo todo

En el lado de Linux, Winpodx ofrece tanto una línea de comandos bastante completa como una interfaz gráfica basada en Qt6. La CLI incluye subcomandos para crear y gestionar el contenedor, lanzar aplicaciones, refrescar el catálogo de software instalado, realizar comprobaciones de salud (RDP, disco, agente interno, edad de la contraseña, etc.) o controlar el modo de instalación (online y offline).

La GUI Qt6 agrupa todo esto en varias secciones: Apps, Configuración, Herramientas, Terminal integrada e Información, además de un icono de bandeja del sistema más ligero para tener el servicio siempre a mano. Esto permite tanto a usuarios avanzados como a perfiles menos técnicos gestionar Winpodx sin necesidad de memorizar comandos.

Funciones avanzadas: multi-sesión, automatización y seguridad

Más allá de la idea básica de “abre apps de Windows en Linux”, Winpodx incorpora un buen número de detalles técnicos pensados para que la experiencia sea robusta y segura, algo especialmente importante en entornos de trabajo serios.

rdprrap y soporte RDP multi-sesión

Uno de los puntos más delicados de usar Windows Desktop como servidor de RemoteApp es el límite tradicional de una única sesión RDP simultánea. Para resolverlo, el autor de Winpodx desarrolló rdprrap, una reimplementación en Rust de RDPWrap (proyecto original ya sin mantenimiento y distribuido como binarios C++ difíciles de auditar) que levanta ese límite y permite hasta 10 sesiones independientes.

Este componente se instala de manera desatendida durante la preparación del Windows, con verificación de integridad mediante SHA256 fijado, y está licenciado también bajo MIT. Gracias a él, puedes abrir varias aplicaciones de Windows en paralelo sin que una te robe la sesión de la otra, algo crucial si diferentes procesos o usuarios necesitan conectarse al mismo entorno.

Rotación de contraseñas, suspensión automática y salud del sistema

Para no dejar el sistema abandonado desde el punto de vista de la seguridad, Winpodx implementa rotación automática de contraseñas cada 7 días. Genera contraseñas de 20 caracteres de forma criptográficamente segura y aplica un mecanismo de reversión atómica por si algo sale mal durante el cambio, evitando quedarse bloqueado sin acceso.

En cuanto al consumo de recursos, el contenedor se suspende automáticamente cuando no se está utilizando, reduciendo el uso de CPU y memoria, y vuelve a arrancar en el siguiente lanzamiento de una app. La herramienta también fuerza la resincronización del reloj de Windows tras suspensiones del host para evitar problemas de tiempo.

Además, el comando winpodx check permite lanzar un conjunto de health checks para verificar el estado general: contenedor, servicio RDP, agente interno HTTP, espacio en disco y otras métricas útiles para equipos de operaciones o administradores.

Gestión de DPI, audio, portapapeles y periféricos

Para encajar bien en escritorios modernos, Winpodx detecta automáticamente la escala de HiDPI leyendo información de GNOME, KDE, Sway, Hyprland, Cinnamon e incluso xrdb, y ajusta la configuración de RDP para que las aplicaciones de Windows no se vean ni diminutas ni gigantes.

El soporte de audio y portapapeles bidireccional está activado por defecto, lo que significa que puedes oír el sonido de las apps de Windows y copiar/pegar texto e imágenes entre ambos entornos. Las impresoras configuradas en Linux se comparten de forma automática y las unidades USB se mapean en el invitado mediante el mecanismo de FileSystemWatcher, como ya se ha mencionado.

Reverse-open: apps de Linux visibles desde Windows

A partir de la versión 0.5.0, Winpodx introduce una característica muy llamativa: reverse-open, que expone las aplicaciones de Linux dentro del menú “Abrir con…” del Windows invitado. De esta forma, la integración deja de ser unidireccional y se convierte en un auténtico ida y vuelta.

Con reverse-open activo, cuando haces doble clic sobre un archivo dentro de Windows (por ejemplo, un .txt o un .md) y eliges una app de Linux como Kate, se abre el editor en el host Linux, trabajando sobre la ruta real del fichero sin duplicados raros. Los iconos de las apps se muestran correctamente tanto en el menú corto como en el diálogo completo de “Elegir otra aplicación”, lo que hace que la experiencia sea muy natural para el usuario.

Técnicamente, esto funciona gracias a un agente HTTP autenticado con bearer token que corre dentro del Windows invitado en 127.0.0.1:8765 para el canal host→guest, combinado con un listener en el host que procesa peticiones JSON escritas por pequeños shims en Rust dentro del invitado para la dirección contraria. El pipeline host→guest es el mismo que en versiones anteriores (0.3.x), y se ha extendido para soportar esta nueva funcionalidad.

Instalación y configuración de Winpodx en Linux

Una de las grandes bazas del proyecto es que la instalación es prácticamente “de un comando”. Para la mayoría de distribuciones soportadas, basta con abrir una terminal y lanzar:

curl -fsSL https://ift.tt/5vjn7kB | bash

Ese script se encarga de detectar la distribución, instalar las dependencias necesarias (como Podman u otros runtimes de contenedores), preparar el entorno Windows, configurar FreeRDP RemoteApp y registrar las aplicaciones en el menú del escritorio. El primer despliegue suele tardar entre 5 y 10 minutos porque incluye la descarga de la ISO de Windows, el proceso de Sysprep y la aplicación de la configuración automática.

Durante este tiempo, se puede monitorizar el progreso con el comando winpodx pod wait-ready –logs, que muestra el log en directo. Una vez listo, al hacer clic por primera vez en un icono de app de Windows en tu menú, Winpodx termina de provisionar lo que falte, genera entradas de escritorio y lanza la aplicación sin que tengas que tocar ficheros de configuración a mano.

Distribuciones soportadas y paquetes

Además del instalador vía curl, Winpodx publica paquetes específicos para varias distribuciones cuando se hace un push de una nueva etiqueta (v*.*.*). A día de hoy, la compatibilidad incluye:

  • openSUSE Tumbleweed, Leap 15.6, Leap 16.0 y Slowroll, usando zypper, con estado “Tested”.
  • Fedora 42 y 43, con soporte vía dnf.
  • Debian 12/13 y Ubuntu 24.04/25.04/25.10, integrados en apt.
  • AlmaLinux, Rocky y RHEL 9/10, también mediante dnf.
  • Arch Linux y Manjaro, con paquetes en pacman/AUR.
  • NixOS (y Nix en cualquier distro), a través de flakes de Nix.

La documentación oficial detalla todas las rutas de instalación en ficheros como INSTALL.md (incluyendo modos offline/air‑gapped, instalación desde código fuente, fijado de versiones y desinstalación), así como la referencia de CLI y GUI (USAGE.md), el listado de características (FEATURES.md), arquitectura (ARCHITECTURE.md), comparativas (COMPARISON.md), historial de cambios (CHANGELOG.md), guías de contribución (CONTRIBUTING.md) y el proceso de seguridad (SECURITY.md).

Problemas frecuentes durante la instalación

En entornos reales ya se han detectado algunos errores típicos y sus soluciones. Por ejemplo, si aparece un mensaje del tipo “Podman no está instalado”, toca instalarlo manualmente usando el gestor de paquetes de tu distro (en Ubuntu, por ejemplo, sudo apt install podman). Otro problema habitual es que el entorno Windows no termine de arrancar; en estos casos suele deberse a falta de recursos, y conviene asegurarse de disponer al menos de 4 GB de RAM y unos 20 GB de espacio libre en disco.

Si notas que no hay audio en las aplicaciones de Windows, Winpodx ofrece comandos de ayuda (por ejemplo, habilitar o revisar los ajustes de sonido desde su CLI o la GUI), y en casos más rebeldes puede ser necesario revisar la configuración de ALSA o PipeWire en el host. Gran parte de estos escenarios están cubiertos en la documentación y en la sección de issues del repositorio GitHub.

Descubrimiento automático y asociación de aplicaciones

Uno de los grandes puntos fuertes de Winpodx es que no se limita a exponer un escritorio remoto: se preocupa por descubrir y registrar todas las aplicaciones de Windows instaladas para que aparezcan en el menú de aplicaciones de Linux con sus iconos reales.

En el primer arranque del invitado, Winpodx escanea rutas típicas como Registry App Paths, accesos del menú Inicio, aplicaciones UWP/MSIX y gestores como Chocolatey o Scoop, y genera entradas de escritorio (.desktop) con la configuración adecuada de WM_CLASS y StartupWMClass. Esto permite que las ventanas se agrupen correctamente en el dock o barra de tareas y que las asociaciones de archivo funcionen de forma natural: si haces doble clic en un .docx desde tu gestor de archivos de Linux, se abrirá Word dentro de Winpodx.

Si más adelante instalas nuevas aplicaciones dentro del Windows contenerizado, basta con ejecutar winpodx app refresh (o pulsar el botón de “Refresh” en la GUI) para que vuelva a escanear el sistema y registre las nuevas entradas. Así, cualquier cambio en el software de Windows se refleja de manera bastante transparente en tu entorno de escritorio.

Comparativa con Wine, CrossOver, VMs y WSL

Para valorar si Winpodx tiene sentido en tu caso, es importante entender en qué se diferencia de Wine, CrossOver, máquinas virtuales tradicionales y WSL, que son las opciones más habituales para mezclar entornos Windows y Linux.

Wine y CrossOver: capa de compatibilidad ligera pero irregular

Tanto Wine como CrossOver funcionan como una capa de compatibilidad que traduce llamadas del sistema de Windows a Linux. Su gran ventaja es que consumen relativamente pocos recursos, porque no hay un Windows real ejecutándose detrás. Pero esta aproximación tiene un coste en compatibilidad: ciertas aplicaciones empresariales modernas, software que usa APIs recientes de Windows o dependencias muy concretas pueden funcionar mal o directamente no arrancar.

En cambio, Winpodx lanza un Windows completo (aunque optimizado) dentro de un contenedor, lo que le permite alcanzar una compatibilidad mucho más cercana al 100 %, ya que el software cree estar corriendo en un entorno genuino de Microsoft. Eso reduce mucho las sorpresas a la hora de usar suites corporativas pesadas o herramientas muy específicas.

Máquinas virtuales clásicas: compatibilidad total, integración pobre

Soluciones como VirtualBox, VMware o Parallels ofrecen compatibilidad casi absoluta, pero lo hacen a costa de un overhead grande: la VM consume memoria de forma constante, se siente como “otro equipo dentro de tu equipo” y la integración con el escritorio host suele limitarse a compartir carpetas, portapapeles y poco más.

Winpodx toma muchas de las ventajas de la VM (compatibilidad, aislamiento, facilidad para cumplir requisitos de licencia) y las combina con una integración visual muy superior: cada app es una ventana del host, las asociaciones de archivo funcionan en ambos sentidos y el contenedor se suspende automáticamente cuando no se usa, reduciendo el impacto en rendimiento cuando estás trabajando solo con apps de Linux.

WSL vs Winpodx: dos caras de la misma moneda

WSL (Windows Subsystem for Linux) resolvió el problema inverso: correr apps de Linux dentro de Windows con un híbrido entre máquina virtual ligera (en WSL2) y subsistema de compatibilidad. Permite ejecutar tanto herramientas de consola como aplicaciones gráficas (vía WSLg), con una integración bastante razonable y soporte de GPU en muchos casos.

Winpodx, por su parte, es como la pieza que faltaba en el lado Linux: hace el camino contrario, trayendo aplicaciones de Windows al escritorio Linux. Mientras WSL2 se apoya en una VM completa muy afinada, Winpodx apuesta por contenedores (especialmente Podman), lo que se traduce en un consumo de recursos menor y en una gestión más alineada con el mundo cloud-native. La contrapartida es que, a día de hoy, Winpodx no ofrece un soporte de passthrough de GPU “plug and play” equivalente al de WSL2.

Limitaciones, rendimiento y consideraciones de licenciamiento

Pese a todas sus virtudes, Winpodx no es una bala de plata que sirva para absolutamente todo. Conviene tener claras sus limitaciones antes de adoptarlo como pieza central en un flujo de trabajo crítico.

Rendimiento gráfico y GPU passthrough

El principal punto débil ahora mismo es el soporte limitado para aceleración gráfica nativa. Winpodx puede ejecutar sin problema suites de productividad (Microsoft Office), editores de texto avanzados (Notepad++), navegadores, herramientas de desarrollo como Visual Studio o SQL Server Management Studio, e incluso Photoshop en uso básico, pero no está pensado para edición de vídeo 4K pesada ni para gaming moderno.

Si necesitas sacar partido de la GPU dentro del contenedor de Windows, toca configurar a mano passthrough de GPU con VFIO o recurrir a máquinas virtuales basadas en KVM, que están más maduras para ese tipo de escenarios. También se pueden considerar alternativas como VirtualBox con extensiones de invitado para usuarios que no quieren lidiar con detalles de bajo nivel.

Licenciamiento de Windows y soporte

Aunque Winpodx sea open source y gratuito, no elimina la necesidad de disponer de licencias válidas de Windows. El contenedor ejecuta una copia real del sistema operativo de Microsoft, así que debes cumplir con los términos de licenciamiento correspondientes, igual que si montaras una VM tradicional.

Además, al tratarse de un proyecto relativamente joven con comunidad emergente, no hay SLA empresarial ni soporte comercial garantizado salvo que algún tercero lo ofrezca de forma independiente. Para equipos que dependen de un soporte 24/7 o que trabajan en entornos extremadamente regulados, esto es algo a valorar con calma.

Curva de aprendizaje y madurez del proyecto

Aunque la promesa de Winpodx es “casi sin configuración”, requiere cierta familiaridad con contenedores (Docker/Podman) y conceptos como RDP, especialmente si quieres salirte del camino feliz y empezar a hacer ajustes finos. Los usuarios que ya mueven servicios en contenedores no deberían tener grandes problemas, pero alguien procedente solo de entornos de escritorio puede necesitar algo de tiempo para sentirse cómodo.

El proyecto está en desarrollo activo, con versiones recientes como la 0.5.0 que introducen funciones potentes como reverse-open. Esto significa que aún hay bordes ásperos y cambios frecuentes, aunque la base ya es lo bastante madura como para que las pruebas de usuarios reales sean el feedback más valioso para el autor.

Casos de uso: para quién tiene sentido Winpodx

Winpodx encaja de manera especialmente buena en startups, equipos técnicos y profesionales que han apostado por Linux pero siguen atados a software de Windows sin alternativa real. Algunos escenarios claros donde brilla:

  • Desarrolladores que trabajan en Linux pero necesitan puntualmente herramientas como Visual Studio, SSMS, Office o software propietario de clientes solo para Windows.
  • Startups con infraestructura mayoritariamente Linux que han heredado procesos o aplicaciones Windows críticas (ERP, aplicaciones contables, herramientas internas).
  • Equipos de QA y testing multiplataforma que tienen que comprobar el comportamiento de sus productos tanto en Linux como en Windows sin cambiar de máquina.
  • Entornos con fuertes restricciones de red o sin conexión (air-gapped), ya que Winpodx contempla rutas de instalación offline con parámetros como –source y –image-tar.

En todos estos casos, la capacidad de tratar el contenedor como un servicio más (monitorizado, con logs, con health checks) y la integración fina con el escritorio reducen mucha fricción operativa frente a mantener máquinas Windows físicas o VMs aisladas que solo se usan para “esa app rara”.

Para plantearte seriamente su adopción conviene, eso sí, seguir algunos pasos: revisar tu stack de aplicaciones para ver qué software Windows no tiene sustituto nativo, montar una instancia de prueba con un conjunto concreto de apps críticas, y por último calcular el coste total de propiedad frente a seguir manteniendo hardware o VMs dedicadas. En equipos pequeños la diferencia puede ser considerable.

En conjunto, Winpodx se ha consolidado como una de las propuestas más interesantes para unir los mundos Linux y Windows sin renunciar a la comodidad del escritorio. Ofrece un equilibrio muy atractivo entre compatibilidad, rendimiento razonable y automatización, con extras como el reverse-open y la auto-descarga de iconos que lo acercan a la experiencia que muchos valoran en WSL, pero esta vez desde el lado del pingüino. Si tu día a día mezcla herramientas de ambos ecosistemas y te cansa vivir entre arranques dobles o máquinas virtuales pesadas, darle una oportunidad a Winpodx puede ahorrarte bastante tiempo y algún que otro quebradero de cabeza.

from Linux Adictos https://ift.tt/ajqAD5z
via IFTTT

Fragnesia: análisis y mitigaciones ante una nueva vulnerabilidad de escalada de privilegios en Linux

Fragnesia

En las últimas semanas el mundo Linux se ha visto sacudido por una nueva vulnerabilidad que, para muchos administradores, ha sido la gota que colma el vaso en una racha de fallos críticos en el kernel. Hablamos de Fragnesia, un exploit de escalada local de privilegios que se suma a la familia de fallos conocidos como Copy Fail y Dirty Frag, y que permite a cualquier usuario sin privilegios conseguir root con un único comando en sistemas vulnerables.

Tras Copy Fail y Dirty Frag, Fragnesia llega en un contexto de auténtica “fatiga de parches”: actualizaciones urgentes, reinicios encadenados y mitigaciones de emergencia. Sin embargo, dejarlo pasar no es una opción. El fallo afecta a múltiples distribuciones Linux y versiones de kernel, y ya existe una prueba de concepto pública totalmente funcional. En este artículo vamos a desgranar qué es Fragnesia, cómo funciona el ataque, qué distribuciones están afectadas, qué parches y mitigaciones existen y cómo comprobar si tu sistema está protegido.

Qué es Fragnesia y por qué se relaciona con Dirty Frag y Copy Fail

Fragnesia es un nuevo exploit de escalada local de privilegios (LPE) en el kernel de Linux que se encuadra en la misma familia de vulnerabilidades que Copy Fail (CVE-2026-31431) y Dirty Frag (también conocido como Copy Fail 2, CVE-2026-43284). Comparte con ellas la idea base: abusar de fallos lógicos en la pila de red y el manejo de memoria del kernel para obtener una primitiva de escritura en memoria que permita modificar archivos teóricamente de solo lectura y acabar ejecutando código como root.

El fallo ha sido bautizado como Fragnesia y rastreado como CVE-2026-46300, con una puntuación CVSS de 7,8. La vulnerabilidad fue descubierta por William Bowling, del equipo de seguridad V12. Poco después, Sam James anunció el problema en la lista de correo de OSS Security, aclarando que no se trataba de un simple reanálisis de Dirty Frag, sino de un bug distinto en la misma superficie funcional del kernel.

En términos prácticos, Fragnesia es el tercer fallo crítico de este tipo en apenas dos semanas: Copy Fail, Dirty Frag y ahora Fragnesia. Los tres se aprovechan de problemas en el manejo de datos en el kernel para corromper la caché de páginas (page cache) de archivos críticos como /usr/bin/su, pero Fragnesia lo logra a través de otra ruta: el subsistema ESP-in-TCP de XFRM.

Detalles técnicos: el subsistema XFRM ESP-in-TCP y el fallo de lógica

El núcleo de Fragnesia reside en un fallo de lógica en el subsistema Linux XFRM ESP-in-TCP, concretamente en la ruta del ULP (Upper Layer Protocol) denominada espintcp. XFRM es el marco del kernel encargado, entre otras cosas, de procesar tráfico IPsec, y ESP (Encapsulating Security Payload) es el protocolo que proporciona confidencialidad y autenticidad mediante cifrado (por ejemplo, AES-GCM), como ocurrió con una vulnerabilidad en el protocolo de red CAN BCM.

El ataque se basa en una situación muy concreta del kernel: cuando un socket TCP pasa a modo ESP-in-TCP después de que se hayan introducido en su cola de recepción páginas de fichero mediante llamadas como splice(2) o sendfile(2). En lugar de tratar esos datos como simples páginas provenientes de un archivo, el kernel los interpreta como si fueran texto cifrado ESP y aplica la “desencriptación” sobre ellas, modificando así las páginas de la caché de forma in situ.

Como consecuencia de este error, el kernel inyecta el flujo de claves de AES-GCM sobre páginas de la caché correspondientes a archivos de solo lectura, lo que se traduce en escrituras de bytes arbitrarias en la page cache. Controlando el IV (nonce) y otros parámetros, un usuario sin privilegios puede dirigir estas escrituras con mucha precisión. El resultado es una primitiva de escritura determinista que permite alterar una cantidad controlada de bytes de cualquier archivo legible, pese a que el sistema de ficheros lo marque como inmutable o de solo lectura.

La prueba de concepto pública se centra en modificar el binario /usr/bin/su en la caché de páginas. Inyecta un stub ELF de 192 bytes (posicionalmente independiente) en la copia en memoria de ese binario. A partir de ese momento, la siguiente vez que se ejecute su, se ejecutará el stub con privilegios de root, proporcionando una escalada instantánea sin necesidad de carreras de condiciones ni de otros trucos adicionales.

Mitigaciones temporales: cómo protegerte si no puedes reiniciar

Aunque lo recomendable es instalar un kernel parcheado y reiniciar lo antes posible, se han descrito mitigaciones temporales efectivas para quienes no puedan permitirse un reinicio inmediato. La buena noticia es que, dado que Fragnesia explota los mismos módulos base (esp4, esp6 y opcionalmente rxrpc) que Dirty Frag, la mitigación propuesta para este último sirve igualmente para Fragnesia.

La técnica consiste en bloquear la carga de los módulos vulnerables mediante la configuración de modprobe y, si estuvieran ya cargados, descargarlos de memoria. Se hace escribiendo una regla en /etc/modprobe.d/ que sustituye la carga de esos módulos por comandos inofensivos (como /bin/false). Después se invoca a rmmod sobre ellos, ignorando silenciosamente los errores si no están presentes.

En distribuciones como CloudLinux, el comando propuesto para Dirty Frag (que vale igual para Fragnesia) genera un archivo dirtyfrag.conf con reglas para esp4, esp6 y rxrpc, y a la vez intenta descargar los módulos activos. Si ya aplicaste esta mitigación por Dirty Frag, no tienes que hacer nada más para Fragnesia hasta que instales el kernel corregido, porque la superficie de ataque queda igualmente neutralizada.

Es importante tener en cuenta la compatibilidad: esp4 y esp6 son los transform del kernel para IPsec. Deshabilitarlos rompe los túneles IPsec que dependan de la ruta de datos del kernel (por ejemplo, strongSwan o Libreswan). La recomendación es no usar esta mitigación en hosts que terminen o enruten tráfico IPsec crítico. El módulo rxrpc es el transporte AF_RXRPC, usado casi exclusivamente por clientes AFS, y rara vez está presente en servidores web u otros escenarios generalistas.

Restaurar la caché de páginas tras aplicar la mitigación

Otro punto a menudo pasado por alto es que el exploit, al funcionar, puede dejar en memoria copias modificadas de binarios legítimos en la page cache. El ejemplo más típico es /usr/bin/su, pero podrían verse afectados otros binarios privilegiados si el atacante decide cambiar de objetivo.

Por ello, algunos avisos recomiendan que, tras aplicar la mitigación de blacklist de módulos, se proceda a vaciar la caché de páginas del sistema para forzar una recarga limpia desde disco. Esto se puede lograr escribiendo en /proc/sys/vm/drop_caches un valor que indique al kernel que libere cache page y dentries/inodes. Esta operación solo elimina páginas limpias, por lo que es segura en sistemas en producción, aunque puede generar un aumento puntual de E/S al disco cuando los binarios y datos se vuelvan a leer.

La idea es sencilla: si una instancia de Fragnesia ya hubiera sido ejecutada antes de mitigar, las páginas corrompidas se descartan y se volverá a usar la versión en disco sin alterar. Combinado con la blacklist de módulos, este paso reduce el riesgo de que una posible modificación residual en la cache siga siendo explotable o provoque comportamientos erráticos en el sistema.

Estado de los parches y recomendaciones de los proveedores

La mayoría de los grandes actores del ecosistema Linux han respondido de forma rápida al descubrimiento de Fragnesia. Distribuciones como AlmaLinux y CloudLinux han publicado o están finalizando kernels parcheados, mientras que Red Hat ha indicado que está evaluando hasta qué punto las mitigaciones existentes para vulnerabilidades previas cubren también CVE-2026-46300.

Varios proveedores de seguridad, como empresas asociadas a Google y Microsoft, han publicado análisis explicando que la vulnerabilidad permite a atacantes locales sin privilegios modificar contenidos de archivos de solo lectura en la caché de páginas y escalar a root mediante corrupción determinista de memoria. Wiz, por ejemplo, destaca que AppArmor y las restricciones sobre user namespaces sin privilegios pueden mitigar parcialmente el impacto al requerir técnicas adicionales para explotar con éxito el bug en algunos entornos.

Microsoft, por su parte, señala que no se ha observado explotación activa en la naturaleza en el momento de su comunicado, pero aun así insta a aplicar el parche tan pronto como esté disponible, utilizando las herramientas de actualización habituales. Cuando no sea posible parchear de inmediato, recomiendan aplicar las mismas mitigaciones propuestas para Dirty Frag: desactivar esp4, esp6 y funcionalidad relacionada con IPsec/XFRM no imprescindible, endurecer el acceso local interactivo y reforzar el monitoreo de actividades inusuales de escalada de privilegios.

Contexto de amenazas: mercado de exploits y fatiga de parches

El descubrimiento de Fragnesia se produce en un contexto en el que la explotación de fallos de escalada local en Linux gana valor en el mercado negro. Informes recientes describen a un actor, bajo el alias “berz0k”, ofreciendo un zero-day de escalada local en Linux por 170.000 dólares, supuestamente funcional en múltiples distribuciones. Según ThreatMon, el vendedor afirma que la vulnerabilidad es de tipo TOCTOU (Time-of-Check Time-of-Use), permite una escalada estable sin provocar cuelgues y utiliza un payload en forma de biblioteca compartida (.so) desplegada en /tmp.

Todo esto alimenta la sensación de saturación y cansancio que muchos administradores expresan: “otra vulnerabilidad de la misma categoría que Dirty Frag”, “ocho más como esta y ya desconecto”, comentan algunos de forma medio en broma, medio en serio. La realidad es que la sucesión de Copy Fail, Dirty Frag y Fragnesia está obligando a los equipos de sistemas a replantearse su estrategia de actualización del kernel, especialmente en entornos donde los reinicios frecuentes son muy costosos.

En este paisaje, soluciones de livepatching como KernelCare o mecanismos similares cobran protagonismo como alternativa para aplicar correcciones críticas sin interrumpir servicios, mientras que las distribuciones se ven presionadas para acortar al máximo los tiempos entre el descubrimiento, la publicación del fix upstream y la disponibilidad del paquete parcheado en repositorios estables.

En última instancia, Fragnesia se ha convertido en un caso de estudio de cómo una pequeña pieza de lógica en un subsistema especializado como XFRM ESP-in-TCP puede tener consecuencias devastadoras cuando se combina con mecanismos de caché de páginas y binarios privilegiados. Mantenerse al tanto de avisos de seguridad, listas de correo, blogs de distribuciones y canales de comunicación como Mattermost o X (antes Twitter) es clave para reaccionar con rapidez y minimizar la ventana de exposición.

La amenaza que representa Fragnesia no radica solo en su capacidad de dar root con un comando, sino en que demuestra hasta qué punto los entornos Linux modernos dependen de una cadena de confianza compleja que va desde el código del kernel hasta las herramientas de actualización y las políticas de endurecimiento. Estar protegido pasa por combinar parches oficiales, mitigaciones bien entendidas, soluciones de livepatch donde tenga sentido y una política clara de control de acceso local y monitorización, de forma que un fallo de este tipo no se convierta en el punto único de fallo para toda la infraestructura.

from Linux Adictos https://ift.tt/bkU2aul
via IFTTT

OpenZFS 2.4.2: estabilidad y compatibilidad como norte estratégico para almacenamiento en Linux y FreeBSD

OpenZFS 2.4.2

OpenZFS 2.4.2 ya está disponible como rama estable y se presenta como una actualización más de infraestructura que de grandes titulares, pero con un impacto importante para quienes gestionan sistemas de almacenamiento serios. Aunque sobre el papel pueda parecer un lanzamiento discreto, las novedades en compatibilidad de kernel y en estabilidad interna lo convierten en un paso relevante para administradores de sistemas que trabajen con Linux o FreeBSD.

Este lanzamiento se centra en cerrar brechas de compatibilidad y pulir errores que se manifestaban en escenarios complejos: cambios de kernel, reconstrucciones de pools, uso de dRAID o sustitución de discos. No hay funciones espectaculares pensadas para titulares comerciales, pero sí muchas correcciones que reducen riesgos de corrupción de datos y mejoran la convivencia entre OpenZFS y las versiones más recientes del kernel de Linux.

Compatibilidad de OpenZFS 2.4.2 con kernels Linux y FreeBSD

El punto más visible de OpenZFS 2.4.2 es la compatibilidad oficial con el kernel Linux 7.0, algo especialmente relevante para quienes ya están probando o desplegando distribuciones que integran esta rama. Hasta ahora, la versión estable anterior solo llegaba formalmente hasta Linux 6.19, lo que generaba fricciones en instalaciones que se movían más rápido a nivel de kernel que de stack de almacenamiento.

Con esta actualización, el proyecto mantiene un amplio rango de soporte, que abarca desde Linux 4.18 hasta 7.0. Esta horquilla resulta muy útil en entornos mixtos europeos donde coexisten servidores con distribuciones antiguas de soporte prolongado, máquinas de pruebas con kernels recientes y sistemas de producción más conservadores. Disponer de una única rama de OpenZFS que cubra todo ese abanico reduce excepciones, despliegues especiales y dolores de cabeza en la planificación de actualizaciones.

En la parte de FreeBSD, OpenZFS 2.4.2 sigue funcionando correctamente con FreeBSD 13.3 y versiones posteriores, incluido el salto a las ramas más nuevas como la serie 14.x. Esto mantiene alineado el ecosistema BSD con la evolución del sistema de archivos, algo relevante para centros de datos europeos que combinan infraestructuras Linux y FreeBSD en servicios de almacenamiento, copias de seguridad o plataformas de virtualización.

Cierre de la brecha con Linux 7.0

El soporte formal de Linux 7.0 no es solo un detalle de documentación: ataja un problema real que ya se estaba viviendo en distribuciones de nueva generación. Había casos, como instalaciones basadas en Ubuntu en versiones de desarrollo con kernel 7.0.0-15 y OpenZFS 2.4.1, donde los registros del sistema advertían de un uso experimental y posible riesgo de pérdida de datos al combinar ese kernel con la versión previa del módulo.

En un escritorio doméstico esos avisos pueden parecer anecdóticos, pero en un servidor de almacenamiento en producción no son algo que se pueda ignorar solo porque todo parezca funcionar a simple vista. Con 2.4.2, OpenZFS declara explícitamente compatible el kernel 7.0, lo que aporta un marco más claro para administradores que deben cuadrar políticas de actualización de kernel y estabilidad de pools ZFS en centros de datos o nubes privadas.

Además, el proyecto ha introducido ajustes iniciales orientados a Linux 7.1, anticipando cambios internos del kernel que pueden afectar a módulos externos como OpenZFS. No se trata aún de un soporte cerrado para 7.1, pero sí de un trabajo preparatorio que reduce la probabilidad de sorpresas incómodas cuando estas versiones empiecen a llegar a distribuciones de referencia en Europa.

Correcciones en rutas de datos y fiabilidad

Más allá del soporte de kernel, buena parte de las novedades de OpenZFS 2.4.2 se centra en rutas de datos críticas donde un fallo puede traducirse en corrupción o comportamientos inesperados. Aunque estos problemas suelen aparecer en escenarios poco frecuentes, son precisamente los que marcan la diferencia entre un sistema de ficheros robusto y uno que genera dudas a largo plazo.

Entre las correcciones destacadas se encuentran arreglos para errores de checksum en casos muy raros tras procesos de reconstrucción, una cuestión especialmente sensible cuando se trabaja con grandes pools o con discos que se han degradado. También se han solucionado problemas en configuraciones dRAID después de reconstrucciones con unidades deterioradas, lo que mejora la confianza en despliegues que usan esta tecnología para grandes volúmenes de datos.

La versión incorpora además correcciones en los procesos de importación de pools después de sustituciones de discos, un posible race condition asociado a los árboles de rangos (range trees) y un fallo de uso después de liberación (UAF) en la función dmu_write_direct_done. A ello se suma la solución de un problema de corrupción de lectura tras operaciones de clonación de bloques y truncado, un tipo de bug especialmente delicado porque puede pasar desapercibido hasta que los datos se necesitan de verdad.

Todo este conjunto de parches no se traduce en nuevas funciones llamativas, pero sí en un comportamiento más previsible durante operaciones de mantenimiento habituales: reconstrucción de vdevs, gestión de discos sustituidos, uso intensivo de snapshots y clones, dRAID y pruebas de rendimiento. Para organizaciones europeas que usan OpenZFS en almacenamiento crítico, estos son los detalles que ayudan a dormir un poco más tranquilos antes de un fin de semana.

Ajustes en initramfs, montaje y sistema

OpenZFS 2.4.2 también introduce mejoras en componentes de arranque y montaje que, aunque menos visibles, resultan importantes para que el sistema se comporte de forma consistente en distintas distribuciones. Entre ellas se incluyen correcciones en los scripts de initramfs, que intervienen en las fases iniciales de arranque cuando el sistema necesita acceder a pools ZFS muy pronto.

La nueva versión incorpora soporte para POSIX_FADV_DONTNEED, una sugerencia al sistema de ficheros y al kernel sobre el tratamiento de datos en caché, lo que ayuda a optimizar determinados patrones de acceso en servidores. Además, se han realizado ajustes en las rutas de montaje específicas para Linux y en la lógica de análisis de los nuevos parámetros de montaje, reduciendo casos límite en los que la configuración podía comportarse de forma diferente a lo esperado.

En paralelo, el proyecto ha aprovechado esta versión para actualizar la infraestructura de integración continua (CI), reforzar el uso de identificadores de licencia SPDX y aplicar cambios específicos del código para Linux que alinean mejor el módulo con las evoluciones del kernel. Estas mejoras internas no se perciben directamente en el día a día, pero son la base para que futuras versiones puedan desarrollarse y probarse de forma más fiable.

Recomendaciones de actualización para entornos europeos

Aunque el contenido de OpenZFS 2.4.2 invita a considerarlo una actualización recomendable, no es prudente tratarla como un simple parche trivial. El propio enfoque del proyecto y la naturaleza del sistema de ficheros aconsejan un proceso de despliegue controlado, especialmente en organizaciones con pools grandes o servicios críticos.

Para entornos empresariales y administraciones públicas en España y otros países de la UE, la práctica razonable pasa por revisar primero el estado de los paquetes proporcionados por la distribución, comprobar la configuración de DKMS o módulos, validar las características activas de los pools (pool features) y preparar un entorno de pruebas que reproduzca el escenario de producción lo mejor posible.

Un paso sensato consiste en introducir OpenZFS 2.4.2 inicialmente en sistemas de staging o laboratorios, aplicando allí los mismos patrones de uso que en producción: importación y exportación de pools, simulación de fallos de discos, uso intensivo de snapshots, clones, dRAID y pruebas de rendimiento. Una vez verificado el comportamiento, la actualización en producción debería planificarse en ventanas de mantenimiento con copia de seguridad reciente y estrategias claras de reversión.

En definitiva, OpenZFS 2.4.2 se presenta como una versión sobria pero muy relevante para la estabilidad de sistemas Linux y FreeBSD, especialmente allí donde conviven kernels antiguos y muy recientes. El soporte oficial para Linux 7.0, las numerosas correcciones en rutas de datos, los ajustes en initramfs y montaje, y la disponibilidad paralela de 2.3.7 conforman un paquete pensado para reducir riesgos más que para lucirse en presentaciones. Para quienes gestionan datos con cierta responsabilidad, este tipo de lanzamientos, discretos pero sólidos, son los que marcan la diferencia entre un susto mayúsculo y una operación de mantenimiento rutinaria.

from Linux Adictos https://ift.tt/zjJUGtZ
via IFTTT

Haas en Ascenso y En Peligro: Un Giro de Freno tras la Fiebre de Miami


¡La Fórmula 1 no perdona y cada fin de semana escribe su propia novela! Tras el Gran Premio de Japón, Haas disfrutaba de la euforia de situarse en cuarto lugar en el campeonato de constructores, dos puntos por delante de Alpine. Un logro que parecía abrir la puerta a una temporada de sueños, con la casa estadounidense dejando claro que su progreso no era casualidad. Pero el tango de Miami, su carrera ‘local’ entre comillas, cambió el tono de la historia. Un fin de semana templado en su propio patio ha terminado por empañar la increíble racha y colocar a Haas cinco puntos por detrás del equipo anglo-francés. ¿La razón? Pierre Gasly sumó un punto en la sprint y Franco Colapinto remató la carrera hasta la séptima posición, resultados que pesan cuando el polvo de la batalla se asienta. Mucho de ese vaivén puede atribuirse a la eficacia de su desempeño en pista, a la gestión de elecciones estratégicas y a la capacidad de convertir la velocidad en puntos consistentes. Este vaivén subraya una verdad simple: en la mitad alta del pelotón, cada detalle cuenta. Si Haas quiere sostener su ambición de consolidarse en esa lucha de medio y alto rendimiento, deberá afinar el auto, optimizar cada parada y, sobre todo, mantener la presión cuando la presión aprieta. La ventana para consolidar posición está abierta, pero el margen es estrecho; Alpine, con su constancia, no cederá terreno sin luchar. El próximo capítulo ya está escrito en el calendario, y la historia podría inclinarse de nuevo a favor de Haas si logran convertir cada punto en avance real. Para entender mejor el contexto de estas dinámicas y por qué Haas teme perder terreno frente a Alpine, puedes leer el análisis completo en el enlace adjunto. Keep reading
from Motorsport.com – Formula 1 – Stories https://ift.tt/81DNER9
via IFTTT IA