Diseño responsable de agentes IA: hacia operaciones de producción seguras y confiables


Evaluar agentes IA en producción tiende a centrarse solo en resultados positivos. ¿El agente completó la tarea? ¿La salida fue precisa? ¿La demostración fue convincente?

Las respuestas a estas preguntas importan, pero omiten el aspecto decisivo para que una empresa pueda confiar realmente en los agentes con trabajo real: ¿qué sucede en el 30% de las veces cuando algo sale mal?

En servicios financieros, por ejemplo, un agente autónomo que maneja mal un flujo de movimiento de dinero no se convierte en un ticket de soporte inocuo. Genera responsabilidad legal que puede abarcar toda la organización.

En la atención sanitaria, accesos no controlados a datos pueden comprometer la seguridad del paciente y provocar violaciones de HIPAA. Las industrias altamente reguladas no pueden tratar el fallo como un simple contratiempo. Y cuando las apuestas son mucho mayores que en la mayoría de los demás sectores, cambia el significado de lo que significa “listo para producción”.

El problema es que la mayoría de los marcos de agentes más populares fueron diseñados por equipos enfocados en conectar grandes modelos de lenguaje con bucles de razonamiento y evaluación. Si bien son valiosos, no son la misma disciplina que la ingeniería de sistemas distribuidos.

Pocos de estos marcos fueron construidos por profesionales que han pasado su carrera pensando en recuperación, consistencia y aislamiento de fallos. Muchas soluciones apenas contemplan qué sucede cuando un agente falla a mitad de camino, y esa brecha puede ser muy costosa cuando los agentes manejan transacciones del mundo real.

Reiniciar desde cero no funciona

Cuando un agente de ventas avanza a través de un flujo de 10 pasos y falla en el paso nueve, la recuperación ingenua es reiniciar todo desde el paso uno. Suena inocuo hasta que se consideran los costos de cada paso. Cada reinicio implica volver a ejecutar cada llamada de LLM que ya tuvo éxito, consumiendo tokens para trabajo ya realizado correctamente. A escala, esa ineficiencia convierte un solo fallo en un problema financiero real.

También genera una peor experiencia para las personas y los sistemas aguas abajo. En un flujo regulado, es un trabajo descuidado que se convierte en un problema de cumplimiento y auditoría que espera su momento.

La solución es la ejecución duradera: puntos de control (checkpointing) que capturan el progreso en cada paso significativo, para que la recuperación reanude desde el paso nueve, no desde el inicio. Esto se ha convertido en una práctica estándar en sistemas distribuidos, y la orquestación de agentes debe seguir el mismo camino.

Al evaluar marcos de agentes, la pregunta clave es: si un agente falla a mitad de una tarea de larga duración, ¿el sistema reanuda desde donde se quedó o vuelve a empezar? La respuesta indicará la diferencia entre marcos creados para producción y los creados para demostraciones.

Existe un problema de acceso del que nadie habla

La seguridad en sistemas agentizados presenta su propia variante de este desafío, y comienza con una pregunta que suena básica pero que la mayoría de las organizaciones no puede responder: ¿puedes demostrar exactamente quién o qué hizo qué y cuándo?

Esa pregunta es más compleja cuando los agentes actúan en nombre de otros agentes, que a su vez actúan en nombre de las personas. Cada capa de delegación añade ambigüedad sobre la responsabilidad. Y cuando se suman los servidores MCP, la exposición se multiplica. MCP otorga a los modelos de lenguaje acceso a registros de la empresa, datos de pacientes y sistemas internos. La gran mayoría de los servidores MCP en producción hoy se conectan a alguna base de datos, y el error común es conceder acceso amplio a toda la reserva de datos en lugar de restringir lo que cada servidor puede ver.

Esa distinción importa cuando algo sale mal. Si un sistema con acceso amplio sufre una brecha o una compromisión en la cadena de suministro, el atacante obtiene acceso a todo el entorno. El acceso limitado, donde un servidor MCP o un agente solo puede acceder a los datos necesarios para la tarea, es una de las decisiones de diseño más pasadas por alto en la arquitectura de agentes hoy y, a la vez, uno de los problemas más costosos de resolver después de una brecha.

La identidad añade otra capa. Muchas organizaciones siguen utilizando protocolos de autenticación tradicionales pensados para usuarios humanos, no para sistemas autónomos que actúan a velocidad y escala de máquina. Sin identidades verificables para cada agente y cada componente, código malicioso puede hacerse pasar por una parte legítima del sistema y operar sin ser detectado.

Lo que se necesita aquí es lo que se conoce como atestación criptográfica: un registro a prueba de manipulaciones de todo lo que ocurrió en el sistema vinculado a la identidad específica que lo realizó. Ese registro permite reproducir el estado del sistema después de los hechos y determinar con certeza que un fragmento de código accedió a un sistema específico en un momento concreto. ¿Por qué? Porque esa identidad fue gestionada y aplicada en tiempo real. Es la diferencia entre una política que dice que un componente debe ser confiable y un sistema que puede demostrar lo que realmente hizo.

Diseño para limitar la radiación de la brecha, no solo parchear el daño

Existe también un problema en la forma en que la mayoría de las organizaciones piensan sobre las vulnerabilidades. El enfoque de la industria está casi exclusivamente en parchear CVEs conocidos, y eso es necesario. Pero al mismo tiempo, se pasa por alto algo importante: una vulnerabilidad solo se convierte en CVE conocido después de una brecha. La gestión de parches es intrínsecamente reactiva y no hace nada mientras un sistema está comprometido, momento en el que el código malicioso ya intenta moverse lateralmente por la red.

Por eso la ejecución en tiempo de dominio (runtime enforcement) merece mucho más atención. El objetivo no es solo la prevención; es la contención. Si un sistema se ve comprometido, ¿puedes detectar que un componente se comporta de forma anómala y restringir inmediatamente su acceso, incluso antes de haber identificado o parcheado la falla subyacente? Limitar la radiación en tiempo real, en lugar de depender solo de la detección post-facto, es lo que separa un incidente contenido de una brecha a gran escala.

Los principios de confianza cero deben aplicarse específicamente a las cargas de IA, no solo heredados de protocolos de seguridad en la nube tradicionales. Eso significa autenticación y autorización estrictas para cada agente y cada servidor MCP, políticas claras sobre lo que cada componente puede acceder, y controles que detengan a los componentes comprometidos de enviar datos fuera de la organización.

Necesitas demostrar seguridad, no solo funcionalidad

No se trata de pesimismo hacia los agentes IA; se trata de madurez en la ingeniería. Cada sistema distribuido que ha madurado hasta convertirse en una infraestructura en la que las empresas confían para cargas críticas pasó por la misma evolución. Pasan de optimizar casos comunes a diseñar explícitamente para fallas raras y costosas.

La IA basada en agentes ha llegado a ese punto. Las organizaciones que lo hagan bien podrán sentarse con auditores o reguladores y demostrar, con evidencia, exactamente cómo se comporta sus sistemas cuando algo falla:

– Recuperación duradera que no desperdicia un solo paso completado.

– Acceso limitado a la tarea, no a toda la base de datos.

– Identidad que puede verificarse criptográficamente, no solo presumirse.

– Contención que se activa en tiempo real, no después de los hechos.

Estos son los criterios que las empresas serias deben cumplir para desplegar IA con agentes a escala.

Listamos las mejores soluciones de almacenamiento en la nube para empresas.

Este artículo fue producido como parte de TechRadar Pro Perspectives, nuestro canal para presentar a las mentes más brillantes de la industria tecnológica hoy en día.

Las opiniones expresadas aquí son de la autoría y no necesariamente las de TechRadarPro o Future plc. Si estás interesado en contribuir, aprende más aquí: https://www.techradar.com/pro/perspectives-how-to-submit

from Latest from TechRadar https://ift.tt/AfdtWHa
via IFTTT IA
Lioness Temporada 3: Un giro inminente y la experiencia de ver la próxima entrega


En un momento en el que la tensión no muestra signos de aflojar, Lioness temporada 3 ya nos ha sorprendido con un giro casi fatal que nadie esperaba tan pronto. La semana pasada, dos agentes rusos no identificados, haciéndose pasar por agentes de policía, golpearon a la puerta de Joe y exigieron entrar a su casa, solo para encontrarse con un desenlace letal. Este incidente marca un punto de inflexión claro: el equipo entero se moviliza para investigar, pero la presencia de vigilantes en un tejado cercano sugiere que podría tratarse de una trampa. Si están aquí, parece que no están mirando en otro lugar.

Por ahora, la respuesta permanece suspendida en el aire. En este contexto, la pregunta clave para los fans es: ¿cuándo llega el episodio 3 de Lioness temporada 3 a Paramount+? Los detalles de estreno se han difundido para varias regiones, dejando claro que seguimos ante una temporada con múltiples capas de intriga y acción.

A continuación, el plan de lanzamiento según las últimas estimaciones globales:

– Estados Unidos – 12:00 a.m. PT / 3:00 a.m. ET el domingo 16 de agosto
– Canadá – 12:00 a.m. PT / 3:00 a.m. ET el domingo 16 de agosto
– Reino Unido – 8:00 a.m. BST el domingo 16 de agosto
– India – 12:30 p.m. IST el domingo 16 de agosto
– Singapur – 3:00 p.m. SGT el domingo 16 de agosto
– Australia – 5:00 p.m. AEST el domingo 16 de agosto
– Nueva Zelanda – 7:00 p.m. NZST el domingo 16 de agosto

En cuanto a la entrega de episodios, Lioness temporada 3 está conformada por ocho episodios, que se emitirán semanalmente. El calendario confirmado hasta ahora es el siguiente:

– Episodio 1: ya disponible
– Episodio 2: ya disponible
– Episodio 3: 16 de agosto
– Episodio 4: 23 de agosto
– Episodio 5: 30 de agosto
– Episodio 6: 6 de septiembre
– Episodio 7: 13 de septiembre
– Episodio 8: 20 de septiembre

Este ciclo promete mantener la tensión entre decisiones arriesgadas y revelaciones que podrían redefinir la misión de las Lionesses y el alcance de su red de vigilancia. A medida que avancemos, estaremos atentos a los giros y a cómo cada episodio conecta las piezas para formar un relato cohesivo y contundente.

Para quien se pregunte por la experiencia visual, las imágenes y el material promocional continúan fortaleciendo la atmósfera de suspense: la imagen destacada muestra a Joe en un momento crítico, mientras la narrativa sugiere que la seguridad y la lealtad serán probadas de nuevo en los próximos capítulos. Este es un estreno que, sin duda, merece seguimiento constante para entender el impacto de cada decisión en el desenlace de la temporada.

from Latest from TechRadar https://ift.tt/FBg8oKd
via IFTTT IA

La velocidad frente a la novedad: cómo la inteligencia artificial redefine la ciberseguridad sin reinventar las reglas


La integración de la inteligencia artificial (IA) en el trabajo y la vida diaria ha llevado a empresas y reguladores a actuar con mayor diligencia. La IA representa una fuerza que introduce categorías de amenaza completamente nuevas, haciendo imprescindible una mayor resiliencia cibernética. Sin embargo, en medio del impulso por adelantarse, conviene reconocer que no todo el bombo es totalmente preciso.

Las vulnerabilidades subyacentes que enfrentan las organizaciones hoy siguen siendo, en gran medida, las mismas que hace cinco o diez años: sistemas sin parches, controles de identidad deficientes, privilegios excesivos e integraciones de terceros inseguras.

En algunos casos, estas debilidades existen desde hace tiempo y es probable que sigan existiendo porque la primera limitación fundamental de la ciencia de la computación es que la eliminación de todas las vulnerabilidades es imposible. Por ello, ninguna cantidad de herramientas o presupuesto podrá hacer que una empresa sea 100% segura. Sin embargo, eso no significa que haya que desestimar las mejoras, especialmente en la era de la IA.

Velocidad, no novedad

Aunque la IA no introduce nada intrínsecamente nuevo, sí existen razones para preocuparse. La naturaleza de las debilidades existentes permanece igual, pero la IA altera significativamente la velocidad y la escala con las que pueden identificarse y explotarse. Tareas que antes requerían tiempo, habilidad y persistencia ahora pueden automatizarse, acelerarse y, en algunos casos, ser delegadas.

El umbral de entrada se ha reducido para que actores menos sofisticados operen con mayor eficiencia y éxito.

Ya observamos indicios de este cambio: ciertas fases del ciclo de ataque pueden automatizarse, ya sea en reconocimiento o movimiento lateral. Actores de alto nivel han comenzado a experimentar con el uso de estos sistemas para coordinar operaciones en múltiples etapas, y recientemente hemos visto un ataque completamente autónomo sin supervisión humana.

Al mismo tiempo, las técnicas más familiares se están potenciando en lugar de reemplazarse. El malware puede generarse o iterarse más rápidamente para evadir la detección. El engaño social se ha vuelto más convincente mediante deepfakes, y las campañas de phishing se vuelven más escalables.

Nada de esto representa un nuevo plan de ataque fundamental; es simplemente la aceleración de uno existente.

El problema de la distracción

La distinción entre novedad y velocidad es crucial porque determina cómo responden las organizaciones. Si se trata la IA como una amenaza novedosa y excepcional, se favorece una mentalidad reactiva. Los equipos de seguridad se empujan a buscar soluciones “específicas para IA”, a menudo a expensas de abordar lagunas históricas en su entorno. En la práctica, esas brechas siguen siendo los puntos de entrada más fiables para los atacantes.

El riesgo que genera el actual nivel de atención sobre la IA es una forma de distracción estratégica. Los consejos de administración y ejecutivos plantean preguntas sobre el riesgo de la IA, pero esas conversaciones pueden desvincularse de lo básico. Los programas de gestión de parches siguen siendo inconsistentes. Los inventarios de activos están incompletos. La exposición de terceros es poco entendida. La gestión de identidades y accesos permanece fragmentada entre sistemas.

Estos son los mismos problemas que los profesionales de seguridad abordaban antes de la IA y la tecnología no los elimina. Al contrario, pueden volverse más decisivos a medida que aumenta la velocidad de explotación.

La respuesta adecuada

Es relevante dejar claro los límites del control. Ninguna organización será 100% segura. Siempre existirán vulnerabilidades desconocidas, muchas de las cuales los modelos avanzados podrán descubrir.

Sin embargo, la idea de que la IA introduce un riesgo que pueda ser “solucionado” por completo es engañosa. Incluso si los modelos avanzados identifican debilidades previamente desconocidas, la respuesta sigue siendo la misma que siempre: priorizar, remediar y reducir la exposición con el tiempo.

Para los defensores, igualar este mayor tempo requiere una combinación de disciplina y adaptación. Prácticas establecidas como pruebas de red y ejercicios de mesa deben evolucionar para incorporar escenarios habilitados por IA. Los equipos de respuesta a incidentes deben estar preparados para manejar nuevas formas de evidencia, incluidas aquellas generadas o manipuladas por sistemas de IA.

Además, los programas de capacitación deben reflejar la creciente sofisticación del engaño social, especialmente en lo relacionado con deepfakes y clonación de voz.

Las capacidades de detección y respuesta impulsadas por IA pueden desempeñar un papel importante, especialmente para identificar patrones a escala. Pero no sustituyen a principios de diseño seguro, controles de acceso robustos ni a una comprensión clara de dónde residen los datos críticos. Por tanto, las organizaciones deben evitar una inclinación excesiva hacia nuevas herramientas sin abordar debilidades fundamentales.

La expansión de la superficie de ataque a través de la adopción empresarial de IA añade otra capa de complejidad. Los atacantes ya atacan flujos de trabajo de IA directamente, explotan vulnerabilidades en entornos de desarrollo de software y utilizan técnicas como la inyección de prompts para manipular el comportamiento del sistema.

En algunos casos, las instrucciones maliciosas pueden integrarse en contenido aparentemente benigno, provocando acciones no deseadas cuando se procesan por un sistema de IA.

Una vez más, estos desarrollos deben entenderse como extensiones de conceptos ya conocidos. La validación de entradas, el riesgo de la cadena de suministro y la integridad de los datos siempre han sido centrales para la seguridad. La IA introduce nuevos contextos en los que estos temas se manifiestan, pero no categorías de riesgo completamente nuevas.

Desde la perspectiva de gobernanza, esto refuerza la necesidad de claridad más que de novedad. Las juntas deben centrarse en definir la tolerancia al riesgo, garantizar la rendición de cuentas y mantener la visibilidad de cómo se utiliza la IA en la organización.

Esto incluye integrar consideraciones de IA en los marcos de gestión de riesgos existentes en lugar de tratarla como un dominio separado. Los equipos legales, técnicos y de comunicaciones deben alinearse, especialmente en escenarios que involucren desinformación o medios sintéticos, donde la velocidad de la respuesta es crítica.

Qué importa ahora

Existe valor en el foco actual en el riesgo cibernético. Una mayor atención a nivel directivo puede impulsar la inversión y la responsabilidad de maneras difíciles de lograr antes. Pero esa atención debe dirigirse a los problemas correctos. Tratar la IA como una amenaza completamente nueva podría llevar a una asignación ineficiente de recursos y a pasar por alto las vulnerabilidades ya existentes.

La IA seguirá evolucionando y también las formas en que la utilizan tanto atacantes como defensores. En ciberseguridad, el progreso suele consistir menos en encontrar respuestas nuevas y más en aplicar las existentes con mayor consistencia y velocidad.

Las organizaciones que gestionen mejor este cambio serán aquellas que permanezcan firmes en comprender qué ha cambiado y qué no.

Hemos reunido el mejor software de protección de endpoints.

Este artículo se produjo como parte de TechRadar Pro Perspectives, nuestro canal para presentar a las mentes más destacadas de la industria tecnológica actual.

Las opiniones aquí expresadas pertenecen al autor y no necesariamente a TechRadarPro o Future plc. Si estás interesado en contribuir, obtén más información aquí: https://www.techradar.com/pro/perspectives-how-to-submit

from Latest from TechRadar https://ift.tt/Gret259
via IFTTT IA

El crecimiento de los centros de datos en Londres: retos para la energía y el agua


El anuncio de aprobación de varios centros de datos en Londres plantea una serie de interrogantes sobre la sostenibilidad de su suministro energético y de agua, así como sobre la planificación de recursos a nivel nacional. Este borrador explora el contexto, las preocupaciones y las implicaciones para el sector, las autoridades locales y los proveedores de servicios públicos.

Resumen de los hechos clave
– Se han aprobado múltiples centros de datos en Londres, incluyendo uno en una parcela de 12,2 acres en Haslemere Heathrow Estate, Hounslow, que recibió luz verde en julio de 2026 a pesar de las preocupaciones sobre el consumo de agua y electricidad.
– El proyecto de Hounslow prevé una conexión eléctrica de 80 MVA, capacidad equivalente al consumo de miles de hogares. En cuanto al agua, aún no se han difundido cifras oficiales; sin embargo, otros centros de la capital han solicitado alrededor de tres millones de litros al día.
– En paralelo, Ealing autorizó un centro de datos de 52.000 metros cuadrados en Bridge Road, Southall, en el antiguo Honey Monster Food Factory. Además, se aprobaron otros cuatro centros en la Southall Industrial Estate en noviembre de 2025.
– Según un informe de la Greater London Authority (GLA) de noviembre de 2025, Londres ya cuenta con 99 centros de datos operativos y hay 26 sitios más en plan o pendientes de aprobación, lo que sitúa al 80% de la capacidad de centros de datos del Reino Unido en la capital.
– Esta concentración ejerce una presión considerable sobre los proveedores de energía y las utilities de agua. La GLA señala que hay aproximadamente 10 veces la capacidad eléctrica actual de centros de datos a la espera de aprobación en la cola de conexión a la red.
– En el caso del centro de Hounslow, la conexión eléctrica se gestionará a través del National Energy System Operator (NOSO) y el punto de suministro de la red de Laleham. Se aclara que no se utilizará capacidad eléctrica ya reservada para otros desarrollos, como vivienda.
– En un contexto de sequía extrema en gran parte de Inglaterra, se han impuesto prohibiciones sobre el uso de agua no esencial, como las mangueras. Sin embargo, los centros de datos han sido designados como infraestructura crítica, con lo que no quedan sujetos a las restricciones de agua. Este estatus ha generado debate sobre la necesidad de incorporar de forma explícita la demanda de agua de los centros de datos en las predicciones de recursos hídricos.
– Water UK ha advertido que las previsiones de recursos hídricos no contemplan la demanda de los centros de datos, y que, si la capacidad prevista para 2030 se triplicara, sería necesaria una mayor inversión en fuentes de agua y gestión de recursos.

Análisis de implicaciones para la planificación y la sostenibilidad
1) Infraestructura energética: la demanda de 80 MVA para un único centro de datos representa una carga importante para la red local. La coordinación entre operadores, reguladores y proveedores es clave para evitar cuellos de botella y garantizar suministro estable sin afectar a otros sectores.
2) Consumo de agua: la industria de centros de datos ha centrado su atención en la refrigeración y el consumo hídrico. A falta de cifras oficiales, es razonable anticipar un consumo significativo que debe ser gestionado mediante acuerdos con proveedores y estrategias de consumo eficiente, reutilización de agua y tecnologías de refrigeración alternativas.
3) Planificación integrada de recursos: la evidencia de que la demanda de agua de centros de datos no se incorporó en proyecciones oficiales subraya la necesidad de integrar estas instalaciones en los modelos de previsión de recursos hídricos. Esto permitirá planificar inversiones en infraestructuras de agua y en medidas de mitigación de riesgos.
4) Equilibrio entre crecimiento económico y resiliencia: Londres continúa consolidándose como un polo de infraestructura digital, pero ello implica equilibrar el crecimiento con la resiliencia de servicios públicos esenciales y el uso responsable de recursos.

Consideraciones para actores clave
– Autoridades locales (municipios como Hounslow y Ealing): mejorar la evaluación de impactos hídricos y energéticos de los proyectos, establecer cláusulas en permisos que garanticen la transparencia de consumos y el cumplimiento de objetivos de eficiencia. Implementar monitoreo continuo y auditorías periódicas.
– Gestores de la red y reguladores (NOSO, Ofgem, ENA): asegurar la capacidad de suministro y coordinar la asignación de recursos sin afectar servicios críticos. Explorar opciones de almacenamiento de energía y demanda flexible para gestionar picos de consumo.
– Proveedores de agua y agencias de recursos hídricos: incluir explícitamente la demanda prevista de los centros de datos en las predicciones y proyecciones, favorecer inversiones en infraestructuras de agua y promover prácticas de refrigeración eficientes.
– Sector de tecnología y desarrollo: priorizar tecnologías de enfriamiento eficientes, reutilización de agua y diseño de centros de datos con eficiencia energética desde la fase de planificación.

Conclusión
El crecimiento de centros de datos en Londres subraya la necesidad de una planificación de recursos más integrada y transparente. Los proyectos que ya cuentan con aprobación deben ir acompañados de compromisos claros sobre consumo energético y hídrico, además de estrategias para garantizar un suministro estable a la población y a otros usos críticos. La coordinación entre autoridades, reguladores y la industria será determinante para sostener el impulso digital sin comprometer la sostenibilidad ambiental y la seguridad del suministro.

from Latest from TechRadar https://ift.tt/rQSLIAK
via IFTTT IA

Samsung introduces hearing health features in Galaxy Buds: test de audición y modo audífono llegan a Buds 3 Pro y 4 Pro


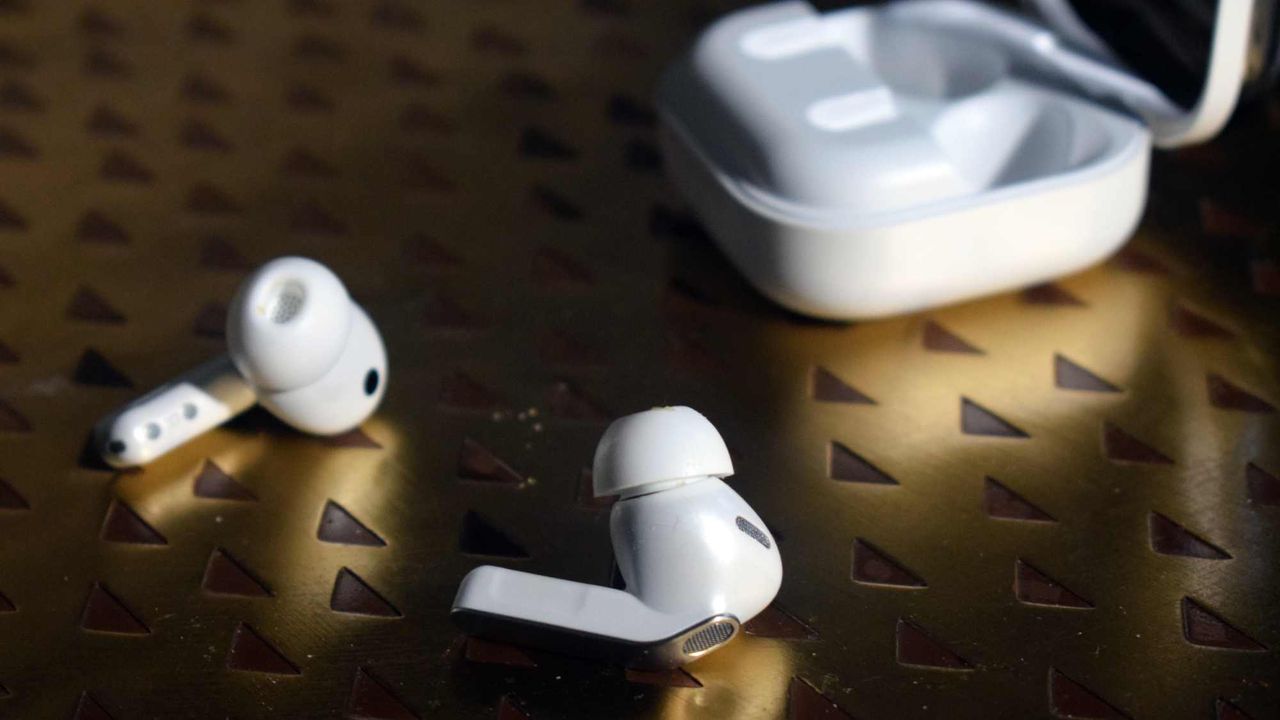
La salud auditiva se está posicionando como una tendencia cada vez más relevante en el mundo de los auriculares. Recientemente observé cómo surgen soluciones diseñadas para proteger la audición, y ahora Samsung se suma a la conversación con una propuesta que busca convertir los auriculares en una herramienta de salud auditiva. Samsung ha anunciado que su nueva función Hearing Aid, parte de un conjunto holístico de salud auditiva, ha recibido la aprobación de la Administración de Alimentos y Medicamentos de los Estados Unidos (FDA).

Según la propia Samsung, el paquete se compone de dos partes. En primer lugar, un modo de prueba auditiva de cinco minutos que evalúa la audición y clasifica si existe pérdida auditiva, etiquetando cada oído de forma independiente como leve, moderada, severa o profunda (o, por supuesto, ‘normal’ si no hay pérdida). En una segunda parte, el modo Hearing Aid utiliza los datos de la prueba para amplificar los sonidos que podrían resultar difíciles de oír. También es posible reducir ciertos ruidos, como el murmullo de fondo o voces de baja intensidad en entornos ruidosos, gracias al sistema de cancelación de ruido activo (ANC) de los auriculares.

El objetivo es que los Galaxy Buds funcionen como audífonos médicos sin necesidad de receta médica ni de visitar un centro de salud; la FDA ha aprobado que los resultados de la prueba auditiva tengan categoría médica. En términos de disponibilidad, Samsung confirmó que dos de sus modelos insignia recibirán la función: los Galaxy Buds 3 Pro y los Galaxy Buds 4 Pro. Para usarla, será necesario un teléfono Samsung que ejecute One UI 8 (o una versión posterior).

La compañía indicó que la función llegará a Estados Unidos y a mercados seleccionados hacia el final del año, concretamente en el cuarto trimestre (aproximadamente entre octubre y diciembre). Aunque ya hay otras soluciones en el mercado, como las ofrecidas por Apple, este movimiento refuerza la tendencia de integrar la salud auditiva en dispositivos de consumo sin necesidad de equipamiento médico adicional.

Si ya formas parte del ecosistema Samsung, esta funcionalidad podría ampliar significativamente tu experiencia diaria: no solo podrás escuchar mejor, sino que también podrás gestionar la experiencia auditiva en función de tu salud y preferencias. En comparación, Apple ha permitido funciones similares durante casi dos años en sus AirPods Pro, con integración entre dispositivos como Apple Watch, MacBook o iPad para ajustar la experiencia auditiva y el sonido de tus contenidos.

En definitiva, Samsung no está presentando una revolución, pero sí una mejora práctica que puede marcar la diferencia para usuarios que buscan una gestión más proactiva de su salud auditiva dentro de un ecosistema Samsung. Será interesante observar la adopción y la recepción en mercados autorizados a finales de año, así como el rendimiento real de la calibración entre prueba y ajuste de audífono en entornos cotidianos.

from Latest from TechRadar https://ift.tt/hydilDO
via IFTTT IA

Desafíos y riesgos de la revisión del contenido en dispositivo: una mirada a la seguridad empresarial ante la propuesta de escaneo del lado del cliente


En junio, Keir Starmer anunció en la London Tech Week que las empresas tecnológicas tienen hasta septiembre para implementar controles en los dispositivos que eviten que los menores envíen o reciban imágenes sexualmente explícitas. El plan requiere un escaneo en el propio dispositivo o en el cliente y ha sido presentado como una medida de seguridad infantil. Para los equipos de seguridad empresarial, plantea un conjunto diferente de cuestiones.

Para las empresas, la propuesta desafía una de las suposiciones centrales de la ciberseguridad moderna: que los dispositivos pueden procesar información sensible sin inspección externa.

Si se requiere que el software escanee el contenido antes de que esté cifrado o transmitido, se abren nuevas superficies de ataque y se debilita la privacidad e integridad de las que las empresas dependen para proteger la propiedad intelectual y la información confidencial.

Es una preocupación que se siente de forma generalizada en la industria, con organizaciones como Signal y la British Computer Society emitiendo declaraciones que advierten que el escaneo del lado del cliente puede crear vulnerabilidades sistémicas que podrían ser explotadas por ciberdelincuentes y otros actores maliciosos, reconfigurando fundamentalmente la confianza digital.

A medida que las organizaciones se preparan para la fecha límite de septiembre, deben dotar a sus equipos de las habilidades necesarias para evaluar los riesgos potenciales que podría generar el escaneo en el cliente, adaptando las estrategias de seguridad cuando sea necesario.

Por qué la propuesta ha generado conversaciones sobre seguridad

El mayor riesgo de un escaneo obligatorio en el dispositivo es la interrupción de la arquitectura de confianza sobre la que se sustenta la seguridad empresarial. Los marcos de seguridad móvil modernos, que incluyen la gestión de dispositivos móviles (MDM), la protección de endpoints y los controles de acceso de confianza cero, se basan en la suposición de que el sistema operativo funciona como una capa controlada y confiable.

Las empresas utilizan esa base de confianza para hacer cumplir políticas de seguridad y verificar la integridad de los dispositivos gestionados.

Introducir un agente de escaneo mandatado por el gobierno, debajo o junto a esa capa confiable, cambia fundamentalmente el modelo de seguridad. Si puede inspeccionar contenido del dispositivo, la integridad del sistema operativo ya no puede asumirse, haciendo que los controles de seguridad que se apoyan en él sean menos fiables.

Este cambio estructural en el límite de confianza que sustenta la seguridad móvil empresarial crea nuevas oportunidades de explotación si la capacidad llega a estar comprometida o reutilizada.

Los problemas operativos para los equipos de seguridad

Las consecuencias van más allá de la arquitectura de seguridad e impactan las operaciones diarias de la empresa. El problema subyacente no es la privacidad, que es lo que persigue el plan gubernamental, sino la arquitectura. Un agente de escaneo a nivel del sistema operativo se sitúa fuera de los límites que los equipos de seguridad empresarial pueden gobernar, interrumpiendo procesos de seguridad que las organizaciones dependen para verificar que los endpoints permanezcan en un estado de confianza.

Los agentes de escaneo gestionados por el gobierno también crean la posibilidad de incumplimientos, especialmente en sectores altamente regulados donde las organizaciones deben demostrar control sobre cómo se procesa y se monitoriza la información sensible. Si la función de escaneo opera fuera del perfil de trabajo gestionado utilizado por las plataformas MDM, queda efectivamente invisible para los administradores de TI.

Como resultado, los equipos de seguridad carecen de mecanismos prácticos para auditar su comportamiento o controlar cómo actúa con datos seguros. Esto también interrumpe la attestation de dispositivos —el proceso mediante el cual las plataformas MDM verifican que un dispositivo se encuentra en un estado conocido y confiable—, lo que podría hacer que dispositivos gestionados sean marcados como no conformes y bloqueados para acceder a recursos corporativos.

En un entorno donde la visibilidad y la certeza son principios fundamentales de la defensa cibernética, introducir un componente privilegiado que quede fuera de la supervisión empresarial crea un punto ciego que debilita, en lugar de fortalecer, la seguridad organizacional.

A pesar de que se busca mejorar la seguridad en línea, el escaneo del lado del cliente genera preocupaciones significativas para las organizaciones. Requiere acceso privilegiado al contenido del dispositivo y se considera ampliamente incompatible con el cifrado de extremo a extremo real, lo que podría debilitar la seguridad, aumentar el riesgo de exposición de datos sensibles y obligar a las organizaciones a navegar entre compromisos difíciles entre cumplimiento y protección de sistemas críticos.

La falta de exenciones claras para datos legalmente privilegiados, sanitarios y financieros también deja a sectores regulados con incertidumbre sobre cómo cumplir con obligaciones legales competentes.

Qué pueden hacer las organizaciones para prepararse

Las organizaciones no pueden permitirse tratar esta propuesta solo como un tema de política. Los responsables de seguridad deberían ya involucrarse con las cuestiones de cumplimiento y gobernanza que plantea, evaluando cómo cualquier cambio obligatorio en los sistemas operativos móviles podría afectar la confianza de los dispositivos, las obligaciones regulatorias y los controles de seguridad existentes.

Esto también implica invertir en las habilidades necesarias para evaluar riesgos de seguridad a nivel arquitectónico, y no simplemente responder a amenazas una vez que surgen.

Los equipos de seguridad necesitarán una comprensión más profunda de los modelos de seguridad del sistema operativo, entornos de ejecución confiables, cifrado, arquitectura de endpoints y gestión de dispositivos móviles, para poder evaluar cómo los cambios en el diseño del núcleo de la plataforma podrían afectar la postura general de seguridad de la organización.

Desarrollar estas capacidades ayudará a las organizaciones a tomar decisiones informadas sobre la adopción de nuevas tecnologías, entender las implicaciones de cambios regulatorios e identificar posibles debilidades antes de que sean explotables.

A medida que la confianza se integrará cada vez más en la propia arquitectura, será tan importante contar con equipos con la experiencia para evaluar y desafiar estas bases como las herramientas de seguridad que se utilizan para defenderlas.

La seguridad no puede erosionar la confianza

A medida que continúa el debate sobre la propuesta de escaneo en el dispositivo del Reino Unido, la conversación debe ir más allá de la dicotomía privacidad versus seguridad y considerar las consecuencias arquitectónicas más amplias para los entornos empresariales.

Debilitar el modelo de confianza computacional en el que se sustenta la seguridad móvil moderna corre el riesgo de introducir nuevas vulnerabilidades, reducir la visibilidad para los equipos de seguridad y minar la confianza en las plataformas de las que dependen las organizaciones.

Hacer que Internet sea más seguro para los niños es crucial, pero lograr ese objetivo no debe ser a expensas de las bases de seguridad sobre las que se apoya el ecosistema digital más amplio. El reto para los responsables de políticas y los proveedores de tecnología no es solo implementar nuevas salvaguardas, sino hacerlo sin erosionar la confianza que sustenta el ecosistema digital.

Hemos destacado las mejores soluciones para transferencia de archivos seguras.

Este artículo se produce como parte de TechRadar Pro Perspectives, nuestro canal para presentar a las mentes más brillantes de la industria tecnológica actual.

Las opiniones expresadas aquí son del autor y no necesariamente las de TechRadarPro o Future plc. Si está interesado en contribuir, descubra más aquí: https://www.techradar.com/pro/perspectives-how-to-submit

from Latest from TechRadar https://ift.tt/rQFmRIH
via IFTTT IA

Agents of Autonomy: Desarrollando Monitorización y Gobernanza para Identidades no Humanas en el Entorno Empresarial


Las empresas modernas han construido una base de confianza a partir de la interacción entre usuarios humanos y sistemas, apoyándose en herramientas de analítica conductual para distinguir la actividad legítima de posibles indicios de compromiso. La analítica conductual ha avanzado significativamente, y su principio fundamental es que el comportamiento puede ser un indicador más sólido de seguridad que las credenciales por sí solas. Con el tiempo, se ha establecido una línea base robusta para cada usuario, abarcando sistemas accedidos, patrones de inicio de sesión, uso de datos, acciones administrativas, actividad en APIs y otros comportamientos. Cualquier desviación relevante puede activar una investigación.

Sin embargo, el panorama está cambiando rápidamente. La adopción acelerada de asistentes impulsados por IA y, más recientemente, de agentes de IA autónomos introduce una nueva clase de actores empresariales: identidades no humanas con autonomía, toma de decisiones dinámicas y la capacidad de ejecutar acciones multiplatarea. Los modelos de seguridad existentes no fueron diseñados para este conjunto de características, lo que genera desafíos claros para la gobernanza y la monitorización.

La preocupación es palpable: los agentes de IA pueden ejecutar tareas de forma autónoma, acceder a múltiples aplicaciones, tomar decisiones dentro de parámetros definidos y completar flujos de trabajo complejos. Es razonable prever que la adopción de estos agentes en el ámbito empresarial será drástica. Gartner estima que para finales de 2026, el 40% de las aplicaciones empresariales incorporarán agentes de IA específicos para tareas, frente a menos del 5% en 2025. Muchos de estos agentes recibirán identidades, permisos y credenciales para acceder a sistemas sensibles. Por tanto, es natural esperar conflictos de seguridad.

A diferencia de los usuarios humanos, muchas organizaciones poseen una comprensión limitada de lo que constituye un comportamiento esperado o anómalo para identidades autónomas. Esto explica por qué la disciplina de seguridad centrada en agentes de IA aún está emergiendo y por qué la gobernanza y la monitorización conductual se encuentran en fases tempranas de desarrollo. Existe, además, una desconexión potencial entre una inteligencia conductual madura para personas y una capacidad relativamente incipiente para agentes de IA, a pesar de operar cada vez más como identidades confiables dentro de entornos empresariales.

Entre los cambios relevantes, cabe preguntarse: ¿la diferencia entre comportamiento humano y de IA es realmente tan importante? En la era pre-IA, la analítica de comportamiento humano se basaba en patrones relativamente estables: horarios previsibles, conjuntos de aplicaciones constantes, ubicaciones familiares y actividades alineadas con el rol. Los humanos tienden a ser criaturas de hábitos, y, en el entorno laboral, la mayor parte de las personas no realiza acciones maliciosas.

Los agentes de IA son fundamentalmente diferentes: pueden operar de forma continua, no solo dentro de las horas laborales. La actividad a las 3 a. m. no es intrínsecamente sospechosa para un agente, mientras que para un empleado humano podría levantar alertas si se sale de los patrones habituales. Además, los agentes pueden interactuar con decenas de servicios y APIs en segundos dentro de un flujo de trabajo único; por tanto, una alta actividad puede ser esperada, no excepcional.

Aunque muchos agentes actúan en nombre de usuarios, también toman decisiones independientes para completar tareas dentro de parámetros definidos. Esto crea una capa adicional de abstracción entre la petición del usuario y las acciones efectivamente ejecutadas. Los permisos también pueden volverse más matizados a medida que las organizaciones amplían lo que los agentes pueden hacer. Un agente diseñado para tareas simples podría, con el tiempo, ganar autoridad para desencadenar procesos comerciales más complejos. Si los procesos de seguridad no evolucionan al mismo ritmo, surgen riesgos.

En conjunto, el reto no es solo preguntar si un comportamiento parece inusual desde la óptica humana, sino si es inusual para ese agente específico. Por ello, las organizaciones deben establecer líneas base conductuales para los agentes de IA de la misma manera que lo hacen con los usuarios humanos, reconociendo que las características de esas líneas base serán fundamentalmente diferentes y susceptibles a cambios.

La monitorización debe considerar si la secuencia de acciones permanece alineada con el objetivo previsto del agente, ya que acciones individuales legítimas pueden, combinadas, generar resultados no deseados o perjudiciales. Esto implica visibilidad: comprender qué agentes existen, qué identidades poseen, qué sistemas pueden acceder y con qué propósito fueron concebidos.

Las vasijas de comportamiento deben limitarse a las aplicaciones a las que un agente accede típicamente, a las APIs que llama, a los datos que recupera o modifica, a los procesos de negocio que apoya y al nivel de privilegio que normalmente ejerce. El contexto es crítico: pedir a un agente de finanzas que acceda a sistemas contables es razonable, mientras que la interacción del mismo agente con software de desarrollo o HR puede implicar diferentes niveles de riesgo. Al igual que con los usuarios, el objetivo es reconocer desviaciones significativas respecto a un patrón operativo establecido, no meramente eventos aislados.

La monitorización debe complementar controles de seguridad existentes, como la gestión de identidades y la gobernanza, además de la aplicación de políticas. Las tecnologías y procesos deben proporcionar una capa adicional de comprensión de cómo operan las identidades de IA autorizadas dentro de la empresa. Sin estos controles, veremos más titulares sobre ‘agentes rebelde’ y las posibles consecuencias de perder el control sobre su comportamiento.

Este artículo forma parte de TechRadar Pro Perspectives, un canal para mostrar las ideas de líderes en la industria tecnológica. Las opiniones expresadas son las del autor y no necesariamente las de TechRadar Pro o Future plc. Si está interesado en contribuir, puede obtener más información en las vías indicadas en el artículo original.

from Latest from TechRadar https://ift.tt/vwbNizu
via IFTTT IA

Especialización y el Valor Estratégico de la IA en las Empresas


Ask any business what it actually does and the answer is almost always specific. A quarrying company extracts rock. A peatland conservation organization restores peatlands. A retailer sells items. The answer is not “we send emails” or “we have meetings.”

This distinction between what makes a business unique and the common operations surrounding it has always mattered. More than two centuries ago, Adam Smith recognized that productivity comes from specialization.

Workers focusing on narrow tasks consistently outperformed generalists, and economies grew by dividing labor into ever finer slices. Businesses succeeded not by doing everything, but by becoming exceptionally good at one thing.

Artificial intelligence (AI) doesn’t change this principle. If anything, it reinforces it. So why does much of today’s AI discussion assume the opposite?

The prevailing belief is that increasingly capable general-purpose models will eventually become the best solution for almost every task.

While these systems will undoubtedly transform how organizations operate, there are strong economic and technical reasons to argue that the greatest competitive advantage will come not from general AI, but from specialized systems built around the work that makes each organization unique.

Universal workplace infrastructure

General-purpose AI models are rapidly being adopted across every industry. These tools summarize documents, write code, answer questions, analyze data and automate routine knowledge work well enough that not choosing to use them will soon become a competitive disadvantage.

But their greatest strength also creates their greatest limitation. When every organization has access to the same capabilities, those capabilities stop being a differentiator. Email transformed business, but no company gains competitive advantage simply by having email. Cloud computing became essential infrastructure, but it does not distinguish one organization from another.

General-purpose AI is likely to follow the same path. As these models become ubiquitous, they will increasingly resemble infrastructure – in other words, essential for remaining competitive, but insufficient for pulling ahead.

The obvious question then becomes: where will competitive advantage come from?

Specialist work requires specialist AI

The answer lies in the work that businesses actually exist to do.

General-purpose models excel because they are trained on tasks performed by millions of people. Specialist work is different.

Going back to my opening analogy, a quarrying company does not just need help with emails. It needs to optimize blast patterns based on geological conditions, monitor crusher efficiency in real time and match production to market demand.

A peatland conservation organization does not just need help writing reports. It needs to map erosion across thousands of hectares of remote terrain from aerial imagery, then plan restoration interventions accordingly.

These are not simply harder versions of general tasks. They are fundamentally different problems requiring specialized data. And this is where general-purpose models begin to struggle.

The reasons for this are not primarily about intelligence, but economics. There is way more training data available for common business tasks than for specialized industrial or scientific ones.

More importantly, frontier AI labs have enormous commercial incentives to optimize their capabilities for features that millions of customers will use. By comparison, niche use cases are a harder sell from the perspective of return on investment.

But while the economics of model development may more immediately favor general capabilities, the economics of competitive advantage do not.

Specialization creates strategic value

Today, switching between AI providers is reasonably easy. Many organizations continue to move freely between ChatGPT, Claude, Gemini and other models as new capabilities emerge. Because these systems remain broadly interchangeable, changing providers carries relatively little cost.

But that will not always be true. In fact, that flexibility will survive only as long as the models remain largely generic. Once they acquire organizational memory, switching providers becomes far more difficult.

The next generation of AI is likely to move beyond simply responding to prompts. Instead, models will increasingly learn how organizations operate: how decisions are made, how workflows evolve and how years of accumulated expertise are applied in practice.

This goes far beyond larger context windows, searchable document repositories or vector databases. These technologies allow models to retrieve information. They do not fundamentally change the model itself. True organizational memory means the system adapts to the business over time.

In its strongest form, the model learns continuously, gradually embedding the organization’s knowledge into how it reasons and makes decisions.

That creates the potential for a lasting competitive advantage – but only if the organization retains ownership of that accumulated memory rather than effectively renting it from an AI provider. Otherwise, organizational memory becomes a source of vendor lock-in rather than a strategic asset.

Building for the specific

This is why specialized AI deserves a much larger piece of today’s conversation.

Across multiple industries we have found that the greatest competitive value comes not from deploying the largest available model, but from designing systems around specific operational problems.

For a major quarrying operation, we developed a computer vision system that monitors rock size distribution on crusher conveyors, detecting hidden downtime that amounted to five to ten percent of operational hours.

For peatland restoration, we built a tool that maps erosion from aerial imagery and 3D depth data, dramatically accelerating what was previously slow and expensive manual assessment.

The list goes on.

Each system delivers value because it was designed around a particular problem: trained on business-specific data, using a model architected to the exact task. In many cases, the models used were smaller, faster and less computationally demanding than general-purpose alternatives. In this sense, specialization is not about adding complexity. It is about removing everything that does not serve the specific goal.

The economics haven’t changed

As AI matures, the distinction between general and specialized systems will become increasingly clear. General-purpose AI tools will handle the operational tasks shared by every organization. These will become table stakes, like internet access or accounting software. Necessary, but not distinctive.

The activities that truly define a business – the specific niche it exists to fill – will come to rely on AI built for that purpose. This is not a prediction about technology. It is simply the economics of specialization applied to a new generation of tools. Just as businesses create value through specialization, so too will the AI that powers them.

For organizations looking to capture that value, the time to build is now. As generic AI becomes commoditized, providers themselves will increasingly turn their attention to specialized domains, narrowing the window for businesses to establish their own enduring advantage through specialization.

We’ve featured the best AI chatbot for business.

This article was produced as part of TechRadar Pro Perspectives, our channel to feature the best and brightest minds in the technology industry today.

The views expressed here are those of the author and are not necessarily those of TechRadarPro or Future plc. If you are interested in contributing find out more here: https://www.techradar.com/pro/perspectives-how-to-submit

from Latest from TechRadar https://ift.tt/Cg4J2Rm
via IFTTT IA

La doble realidad de la IA: aliados que enfrentan a la marca ante un paisaje de fraude y abuso


La inteligencia artificial se presenta cada vez más como una aliada poderosa para acelerar tareas y ampliar capacidades, convirtiéndose en un compañero de trabajo que hace el trabajo pesado más eficiente. Sin embargo, esa misma potencia abre puertas a riesgos que pueden afectar la salud de un negocio si no se gestionan con rigor. Este artículo explora la delgada línea entre utilidad y amenaza que hoy marca el uso de herramientas de IA, especialmente en el ámbito de la generación de imágenes y la validación de reclamaciones.

La IA ha democratizado el fraude. Durante años, las empresas dependían de fotos y documentación para validar devoluciones y solicitudes de reembolso. Hoy, herramientas de generación de imágenes permiten a actores malintencionados crear recibos realistas, imágenes de productos dañados e evidencia de calidad cuestionable con solo introducir un prompt. Este cambio eleva la dificultad de detectar abusos y aumenta el costo del fraude a nivel minorista.

La velocidad y el alcance de estas imágenes generan ataques que pueden escalar entre múltiples cuentas y comercios en cuestión de horas. No es un fenómeno exclusivo de un tipo de actor: existen redes organizadas que aprovechan estas capacidades a gran escala, así como consumidores individuales que empujan los límites de las políticas de devolución. Aunque las motivaciones y la sofisticación difieran, el resultado para los minoristas es la necesidad de trabajar con mayor contexto y agilidad para distinguir reclamaciones legítimas de abusos.

El fraude impulsado por IA no distingue entre gran operación y incidente aislado. Grupos organizados coordinan actividades y crean múltiples cuentas para propagar reclamaciones dañadas o falsas, apoyándose en imágenes generadas por IA para dar credibilidad a sus claims. Casos reales muestran que estas operaciones pueden llegar a volúmenes significativos y pérdidas millonarias, con la posibilidad de reutilizar mercancía después de obtener el reembolso.

La línea entre fraude y abuso se difumina. No todos los casos anti-éticos provienen de profesionales: usuarios ocasionales pueden emplear estas herramientas para evitar costos de devolución o reclamar por daños que ellos mismos causaron. Para las tiendas, esto genera un terreno ambiguo donde validar la veracidad de una reclamación requiere más que una imagen aislada: contexto, historial de la cuenta, comportamiento de dispositivos y patrones de reclamación deben analizarse en conjunto.

Frente a este reto, combatir con más restricciones no es la solución. Encoger plazos de devolución, cobrar por retornos o demorar reembolsos puede disminuir el abuso, pero a costa de clientes leales y bienintencionados. La clave está en identificar al actor detrás de la reclamación con suficiente confianza, sin penalizar a los compradores legítimos.

La respuesta no está en métodos estáticos ni en revisiones manuales que no pueden escalar. Se requieren enfoques que operen en tiempo real y a gran escala, integrando aprendizaje automático con contexto de comercio: identidad, comportamiento de dispositivos, historial de transacciones y edad de la cuenta. La capacidad de detectar patrones complejos, no solo evidencia aislada, es lo que permite distinguir lo legítimo de lo sospechoso sin generar fricción innecesaria para el cliente.

La evidencia visual debe combinarse con inteligencia de contexto comercial. Un teléfono dañado de un cliente veterano con historial de devoluciones no es lo mismo que una cuenta nueva que presenta su quinto reclamo en una semana. En última instancia, las empresas necesitan entender quién está detrás de la reclamación para evaluar su legitimidad.

Este panorama exige una conversación clara sobre ética, seguridad y experiencia de cliente. El objetivo no es castigar a los buenos clientes, sino frenar a los agentes maliciosos con herramientas adecuadas, transparencia en políticas y una infraestructura tecnológica capaz de adaptarse al ritmo de la innovación.

Si te interesa explorar el tema con mayor profundidad, puedes consultar nuestra recopilación de plataformas de comercio electrónico destacadas y ver ejemplos de enfoques modernos para gestionar fraude y abuso en la era de la IA.

from Latest from TechRadar https://ift.tt/A7vWaHI
via IFTTT IA

Google Pixel 11 y más: lo que esperamos del próximo evento Made by Google


El reciente impulso de Samsung Galaxy Unpacked abre paso a una gran revelación de Google: hoy, en el evento Made by Google en Nueva York, la marca presentará su nueva generación de dispositivos Pixel. Además del esperado Google Pixel 11, todo indica que veremos también la Pixel Watch 5 y posiblemente otros productos de la cartera.

Qué podríamos ver exactamente, y cuándo verlo, a continuación.

Cómo ver el próximo evento Made by Google

– La presentación del Pixel 11 está programada para iniciar a las 3:00 p. m. PT / 6:00 p. m. ET / 11:00 p. m. BST del 12 de agosto, y serán las 8:00 a. m. AEST del 13 de agosto para los espectadores en Australia.
– El evento se realiza en Nueva York, pero también se transmitirá en línea. Puedes verlo en YouTube o mediante el video incrustado en este artículo. Si haces clic en el botón “Notify Me” en el video, recibirás un recordatorio cuando comience.
– También habrá una grabación disponible para verla después, y, si lo prefieres, puedes visitar la página de inicio de TechRadar para nuestro análisis experto de lo que se revele.

Qué esperar en el lanzamiento de Google Pixel 11

– Además del Pixel 11, es muy probable que Google presente el Pixel 11 Pro, el Pixel 11 Pro XL y el Pixel 11 Pro Fold.
– Se espera que estos teléfonos cuenten con una nueva función “HiLight” (anteriormente llamada Pixel Glow), que incluiría luces de colores en la parte trasera para notificaciones o interacciones con Gemini.
– Todo apunta a la inclusión de un nuevo chipset Tensor G6, para impulsar el rendimiento frente a la generación Pixel 10. En el caso de los modelos Pro (11 Pro y 11 Pro XL), podría haber un zoom de cámara de 120x, frente a 100x en la serie Pixel 10 Pro.
– No obstante, es posible que estos teléfonos sean más caros que sus predecesores y que las versiones Pro inicien con menos RAM.

Imagen destacada

[La imagen adjunta muestra el Google Pixel Watch 4 hands-on, con crédito de Future/Lance Ulanoff.]

Otros posibles anuncios en el evento

– Es probable que Google presente el Pixel Watch 5, con mayor capacidad de almacenamiento (posiblemente 64 GB) y más RAM (alrededor de 3 GB), además de una ligera mejora en la batería. Es probable que mantenga el chipset Snapdragon Wear W5 Gen 2.
– Se rumorea la posibilidad de revelar el Pixel Tag, el primer competidor de AirTag de Google.
– También podría haber anuncios sobre unas gafas Android XR y, finalmente, la llegada del esperado Gemini 3.5 Pro.

Conclusión

Con el foco puesto en la serie Pixel 11 y accesorios complementarios como el Pixel Watch 5 y el Pixel Tag, Google busca reforzar su ecosistema con hardware que combine IA avanzada y conectividad inteligente. Si no puedes verlo en directo, recuerda que tendrás la grabación disponible y análisis en profundidad tras el evento.

from Latest from TechRadar https://ift.tt/6MBd1Iy
via IFTTT IA