Coreboot 4.14 llega con mejoras de soporte para Intel, soporte para mas placas y mas

Se acaba de anunciar el lanzamiento de la nueva versión del proyecto CoreBoot 4.14 en la cual 215 desarrolladores han realizado 3660 nuevas confirmaciones.

En esta nueva versión se implementan mejoras a las placas base, a los conjuntos de chips, a la arquitectura general entre otras cosas más.

Para quienes desconocen de CoreBoot, deben saber que esta es una alternativa de código abierto al tradicional Sistema Básico de Entrada-Salida (BIOS) que ya se encontraba en las PCs MS-DOS 80s y reemplazándola con UEFI (Unified Extensible). CoreBoot es también un análogo gratuito de firmware patentado y está disponible para verificación y auditoría completas. CoreBoot se utiliza como firmware base para la inicialización del hardware y la coordinación de arranque.

Incluyendo la inicialización del chip gráfico, PCIe, SATA, USB, RS232. Al mismo tiempo, los componentes binarios FSP 2.0 (Intel Firmware Support Package) y el firmware binario para el subsistema Intel ME, que son necesarios para inicializar y lanzar la CPU y el chipset, están integrados en CoreBoot.

Principales novedades de Coreboot 4.14

En esta nueva versión de coreboot 4.14 se destaca que se implementó el soporte inicial para las APU AMD Cezanne y se realizó una reorganización general del código para admitir los SoC AMD, además de que se ha unificado el código estándar para los SoC AMD, lo que hizo posible utilizar los componentes ya disponibles para el SoC Picasso en el código para AMD Cezanne.

También se destaca que el soporte para procesadores de servidor Intel Xeon Scalable (Xeon-SP) de segunda y tercera generación, SkyLake-SP (SKX-SP) y CooperLake-SP (CPX-SP), se ha estabilizado y reconocido como listo para implementaciones de producción.

SKX-SP se usa para admitir placas base OCP TiogaPass, y CPX-SP se usa para admitir OCP DeltaLake, ya que la base de código optimizada y unificada para admitir diferentes generaciones de Xeon-SP.

En cuanto al soporte añadido, podremos encontrar que se agregó soporte para 42 placas base, 25 de las cuales se utilizan en dispositivos con Chrome OS o en servidores de Google:

  • AMD Bilby
  • AMD Mayólica
  • GIGABYTE GA-D510UD
  • Google Blipper
  • Google Brya
  • Google Cherry
  • Google Collis
  • Google Copano
  •  Google Cozmo
  • Google Cret
  •  Drobit de Google
  • Google Galtic
  • Google Gumboz
  • Google Guybrush
  • Google Herobrine
  • Google Homestar
  • Google Katsu
  • Google Kracko
  • Google Lalala
  • Google Makomo
  • Google Mancomb
  • Google Mazapán
  • Google Pirika
  • Google Sasuke
  • Google Sasukette
  • Google Spherion
  • Google Storo
  • Google Volet
  • HP 280 G2
  • Intel Alderlake-M RVP
  • Intel Alderlake-M RVP con Chrome EC
  • Intel Elkhartlake LPDDR4x CRB
  • Intel montaña de las sombras
  • Kontron COMe-mAL10
  • MSI H81M-P33 (MS-7817 v1.2)
  • Pine64 ROCKPro64
  • Purism Librem 14
  • System76 darp5
  • System76 galp3-c
  • System76 gaze15
  • System76 oryp5
  • System76 oryp6

Se eliminó el soporte para las placas base Intel Cannonlake U LPDDR4 RVP, Intel Cannonlake U LPDDR4 RVP y Google Boldar.

Se introdujo el marco ACPI GNVS centralizado, que se usa en lugar de los controladores APM_CNT_GNVS_UDPATE SMI y ahora se usa para inicializar los elementos genéricos de las tablas ACPI GNVS. Además de que el tamaño estático C_ENV_BOOTBLOCK_SIZE se eliminó principalmente en favor de la asignación dinámica del tamaño, aun que menciona que Kconfig todavía está disponible para usar como un tamaño fijo y para hacer cumplir un máximo para conjuntos de chips seleccionados.

Las secciones del vinculador ahora están alineadas en la parte superior para reducir la huella de flash y mantener los requisitos de salto cercano desde el vector de reinicio.

También se menciona que se modificó el formato del sistema de archivos CBFS utilizado para alojar componentes Coreboot en Flash. Los cambios reflejaron los preparativos para la implementación de la posibilidad de certificar archivos individuales con firmas digitales.

Si estás interesado en poder conocer más al respecto sobre esta nueva versión, puedes consultar los detalles en el siguiente enlace.

Obtener CoreBoot

Finalmente, para quienes estén interesados en poder obtener esta nueva versión de CoreBoot pueden hacerlo desde su sección de descargas, que se encuentra dentro de su página web oficial del proyecto.

Además de que en ella podrán encontrar documentación y más información sobre el proyecto.

El enlace es este.

from Linux Adictos https://ift.tt/3blsUGv
via IFTTT

Con los pies en el suelo: basta de decir que Linux es perfecto, por lo menos para la música, y no volvamos a mencionar a GarageBand

GarageBand, no hay nada parecido en Linux

Hace unos dos meses, hablando sobre que he vuelto a «jugar» con la música, escribí un artículo sobre Hydrogen, una caja de ritmos sobre la que no mentía al decir que me parecía interesante. Tampoco mentía cuando decía que «Apple está por encima del resto cuando hablamos de software para la música«, y en el caso de Linux la diferencia aún es mayor. Sé que puedo recibir críticas de los más fanáticos al escribir este artículo, pero, sintiéndolo mucho, los usuarios de Linux no tenemos nada comparable a GarageBand.

Esta entrada no va sobre hablar bien de Apple, aunque también lo haré, sino para todos aquellos compañeros de Linux, incluso de blogs, que aseguran que Audacity o Ardour son comparables a ese GarageBand que yo sí he usado durante más de 10 años. Pues, sencillamente, va a ser que no. A continuación voy a mencionar el software que más comparan con el DAW de Apple, a decir por qué no son lo mismo y a intentar zanjar de una vez por todas esto que, como músico aficionado, nunca he entendido.

Podemos hacerlo todo sin salir de GarageBand. Con las «alternativas», no

Vamos a empezar hablando de Audacity. Es gratis, tiene muchos efectos e incluso se puede editar MIDI, pero ¿y sus loops? ¿y sus efectos para guitarra? ¿Vamos a comparar el editor MIDI con el de Apple? No sé si reír o llorar, en parte por cómo suena uno y como suena el otro y en parte por lo sencillo que es en uno y lo complicado que es el otro. No, Audacity no es GarageBand.

Seguimos con software como Ardour y Reaper. En teoría, ninguno de los dos es gratis, aunque en Linux no me he encontrado con ninguna limitación. GarageBand es gratis desde hace 7-8 años al comprar un Mac/iPhone/iPad. Ambos nos permiten grabar y editar y tienen mejor pinta que Audacity, pero las mismas carencias. Nos pueden servir para proyectos sencillos, pero no si necesitamos añadir y editar pistas MIDI con los mejores sonidos.

Alguno estará pensando «LMMS. Ese sí, ¿no?». Tampoco. LMMS es una buena opción para el que quiere mezclar, pero, para empezar, hay que buscarse la vida para encontrar los samples, loops y demás. Por otra parte, ¿habéis encontrado el botón para grabar? Yo tampoco. Así que, aunque tiene muy buen diseño, si no sirve para grabar y editar ondas, que aunque esto último puede hacerlo, no es nada preciso, no es comparable con GarageBand.

Por supuesto, el software que se centra en el MIDI tampoco es comparable a GarageBand, y aquí podemos mencionar Rosegarden. El software de Apple es mucho más.

La cuestión: gratuito, intuitivo y todo en uno

Más que yo no lo siente nadie. Mi iMac es de 2009 y no sé si volveré a tener otro sólo pensando en la música. Ahora uso casi siempre Linux, y ni puedo acercarme a lo que hace el GarageBand. De hecho, la versión del iPad/iPhone ya tiene algo importante que no tiene el software para Linux: la biblioteca de sonidos y un editor MIDI muy fácil de usar con el que podemos editar guitarras, bajos, teclados, pianos, sonidos de viento, de cuerda, etc, y el sonido es brutal. Mención especial para la batería, que yo tengo una caja de ritmos muy buena y no la necesito porque me resulta más fácil usar el editor del iPad.

Siguiendo con la batería, existen los «Drummers», lo que son baterías que tocarán según le indiquemos, todo improvisando. ¿Qué software para Linux tiene drummers? Y es que con un solo GarageBand tenemos (o para llegar a lo que nos ofrece, necesitamos):

  • Ardour o Reaper. Con estos secuenciadores puede resultar «sencillo» subir y bajar el volumen con una línea, e indicarles dónde tiene que sonar (aunque no estoy seguro de esto último).
  • Rosegarden o LMMS. Con estos programas editaríamos el MIDI, pero el sonido no tiene nada que ver con lo que ofrece Apple, que parece real.
  • Audacity. Si queremos mezclar y que suene bien lo grabado y el MIDI, a lo mejor necesitamos Audacity para mezclarlo todo, o exportar el MIDI a WAV y meterlo en Ardour/Reaper. Sí podemos necesitarlo para añadir algunos efectos a las ondas.
  • Hydrogen. Me gusta esta caja de ritmos, pero el sonido también deja mucho que desear. Lo bueno es que se pueden encontrar kits… si los buscas.

«Change my mind»

Pero bueno, que no soy un tío totalitario que cree que lo sabe todo sobre todo, ni mucho menos. Me puedo equivocar, y a lo mejor vosotros conocéis un software para Linux que sí se acerque o incluso supere al GarageBand. Así que termino este artículo esperando que me digáis que no tengo razón y por qué. Y si tengo suerte, que me digáis una buena alternativa, que, sinceramente, lo agradecería.

¿Cómo tiene que ser? Pues como he explicado:

  • Secuenciador que me permita grabar, subir y bajar el volumen, mover el lado en el que sonará, editar las ondas y añadirles efectos.
  • Lleno de efectos para el audio, si puede ser con efectos de guitarra (aunque es cierto que yo no lo necesito, pero puede venir bien para corregir un sonido mal elegido).
  • Buen editor MIDI que no me haga perder el tiempo, tan sencillo de editar como Hydrogen con la batería, pero también para otros instrumentos. Y con buen sonido.
  • Loops y efectos para hacer canciones en un rato y que YouTube no me pida derechos de autor, o sencillamente para divertirme.
  • Que sea intuitivo, repito que no me gusta perder el tiempo.

Con lo anterior creo que me conformaría. Sin olvidar que la curva de aprendizaje no sea grande, ¿conocéis algo así?

from Linux Adictos https://ift.tt/33GQ4Ta
via IFTTT

Microsoft ha preparado una implementación de eBPF para Windows

Microsoft dio a conocer recientemente mediante una publicación la implementación del subsistema eBPF para Windows que le permite ejecutar controladores arbitrarios que se ejecutan en el nivel del kernel del sistema operativo.

eBPF proporciona un intérprete de código de bytes integrado en el kernel para crear controladores de red cargados de espacio de usuario, control de acceso y monitoreo del sistema. eBPF se ha incluido en el kernel de Linux desde la versión 3.18 y le permite procesar paquetes de red entrantes/salientes, reenviar paquetes, controlar el ancho de banda, interceptar llamadas al sistema, controlar el acceso y realizar el seguimiento.

A través de la compilación JIT, el código de bytes se traduce en instrucciones de máquina sobre la marcha y se ejecuta con el rendimiento del código compilado. EBPF para Windows es de código abierto bajo la licencia MIT.

Hoy nos complace anunciar un nuevo proyecto de código abierto de Microsoft para que eBPF funcione en Windows 10 y Windows Server 2016 y versiones posteriores. El proyecto ebpf-for-windows tiene como objetivo permitir a los desarrolladores utilizar cadenas de herramientas eBPF familiares e interfaces de programación de aplicaciones (API) sobre las versiones existentes de Windows. Basado en el trabajo de otros, este proyecto toma varios proyectos de código abierto eBPF existentes y agrega el «pegamento» para que se ejecuten en Windows.

eBPF para Windows se puede utilizar con herramientas eBPF existentes y proporciona una API genérica que se utiliza para aplicaciones eBPF en Linux.

En particular, el proyecto le permite compilar código escrito en C en código de bytes eBPF utilizando el compilador eBPF estándar basado en Clang y ejecutar controladores eBPF ya creados para Linux en la parte superior del kernel de Windows, lo que proporciona una capa de compatibilidad especial y admite la API Libbpf estándar para compatibilidad con aplicaciones que interactúan con programas eBPF.

Esto incluye capas intermedias que proporcionan enlaces similares a Linux para XDP (eXpress Data Path) y enlaces de socket que resumen el acceso a la pila de red de Windows y a los controladores de red. Los planes apuntan a proporcionar compatibilidad completa a nivel de fuente con controladores eBPF genéricos de Linux.

La diferencia clave en la implementación de eBPF para Windows es el uso de un verificador de código de bytes alternativo, propuesto originalmente por empleados e investigadores de VMware de universidades canadienses e israelíes.

El verificador se inicia en un proceso aislado separado en el espacio del usuario y se utiliza antes de la ejecución de los programas BPF para detectar errores y bloquear posibles actividades maliciosas.

Para la validación, eBPF para Windows utiliza el método de análisis estático de interpretación abstracta, que, en comparación con el verificador eBPF para Linux, demuestra una tasa de falsos positivos más baja, admite análisis de bucle y proporciona una buena escalabilidad. El método tiene en cuenta muchos patrones de ejecución típicos obtenidos del análisis de programas eBPF existentes.

eBPF es una tecnología conocida pero revolucionaria que proporciona capacidad de programación, extensibilidad y agilidad. eBPF se ha aplicado a casos de uso como la protección contra la denegación de servicio y la observabilidad.

Con el tiempo, se ha construido un ecosistema significativo de herramientas, productos y experiencia en torno a eBPF. Aunque el soporte para eBPF se implementó por primera vez en el kernel de Linux, ha habido un interés creciente en permitir que eBPF se use en otros sistemas operativos y también para extender los servicios en modo de usuario y demonios además del kernel.

Después de la verificación, el código de bytes se pasa al intérprete de nivel de kernel, o se pasa a través del compilador JIT, seguido de la ejecución del código de máquina resultante con derechos de kernel. Para aislar los controladores de eBPF a nivel de kernel, se utiliza el mecanismo HVCI (integridad de código reforzada por HyperVisor), que utiliza herramientas de virtualización para proteger los procesos en el kernel y garantiza que la integridad del código ejecutado esté firmado digitalmente.

Una limitación de HVCI es la capacidad de verificar solo los programas eBPF interpretados y la imposibilidad de usarlos junto con JIT (tiene una opción: rendimiento o protección adicional).

Finalmente si estás interesado en conocer más al respecto, puedes consultar el siguiente enlace.

from Linux Adictos https://ift.tt/2R45L4t
via IFTTT

CodeNet, un proyecto de IBM para sistemas de aprendizaje automático 

IBM logo

IBM dio a conocer recientemente su nuevo proyecto llamado «CodeNet» el cual tiene como objetivo proporcionar a los investigadores un conjunto de datos para experimentar con el uso de técnicas de aprendizaje automático para crear traductores de un lenguaje de programación a otro, así como generadores y analizadores de código.

CodeNet incluye una colección de 14 millones de ejemplos de código que resuelven 4053 problemas de programación comunes. En total, la colección contiene alrededor de 500 millones de líneas de código y cubre 55 lenguajes de programación, tanto lenguajes modernos como C++, Java, Python y Go, como heredados, incluidos COBOL, Pascal y FORTRAN.

«El software se está comiendo el mundo», escribió el famoso empresario estadounidense Marc Andreessen en 2011. Un avance rápido hasta el día de hoy: el software se encuentra en servicios financieros y atención médica, teléfonos inteligentes y hogares inteligentes. Incluso los automóviles ahora tienen más de 100 millones de líneas de código.

Los desarrollos del proyecto se distribuyen bajo la licencia Apache 2.0 y se prevé que los conjuntos de datos se distribuyan en forma de dominio público.

Los ejemplos están anotados e implementan algoritmos idénticos en diferentes lenguajes de programación. Se supone que el conjunto propuesto ayudará a entrenar sistemas de aprendizaje automático y desarrollar innovaciones en el campo de la traducción y el análisis automático de código, por analogía con la forma en que la base de datos ImageNet de imágenes anotadas ayudó al desarrollo de sistemas de reconocimiento de imágenes y visión artificial. Varios concursos de programación se mencionan como una de las principales fuentes de formación de colecciones.

Project CodeNet específicamente puede impulsar la innovación algorítmica para extraer este contexto con modelos secuencia a secuencia, al igual que lo que hemos aplicado en los lenguajes humanos, para hacer una mella más significativa en la comprensión de la máquina del código en lugar del procesamiento de la máquina del código.

A diferencia de los traductores tradicionales basados ​​en reglas de traducción, los sistemas de aprendizaje automático pueden capturar y tener en cuenta el contexto del uso del código. Al convertir de un lenguaje de programación a otro, el contexto es tan importante como al traducir de un lenguaje humano a otro. Es la falta de conciencia contextual lo que evita que el código se convierta de lenguajes heredados como COBOL.

La presencia de una gran base de implementaciones de algoritmos en varios lenguajes ayudará a crear sistemas universales de aprendizaje automático que, en lugar de traducción en vivo entre lenguajes específicos, manipulen una representación más abstracta del código, independiente de lenguajes de programación específicos.

Dicho sistema se puede utilizar como un traductor que traduce el código transmitido en cualquiera de los idiomas admitidos a su representación abstracta interna, a partir de la cual se puede generar código en muchos idiomas.

Incluyendo el sistema podrá realizar transformaciones bidireccionales. Por ejemplo, los bancos y las agencias gubernamentales continúan utilizando proyectos COBOL heredados. Un traductor de aprendizaje automático puede convertir el código COBOL a la representación de Java y, opcionalmente, traducir un fragmento de Java de nuevo al código COBOL.

Además de la traducción entre idiomas, se mencionan áreas de aplicación de CodeNet como la creación de sistemas de búsqueda de códigos inteligentes y la automatización de la detección de clones, así como el desarrollo de optimizadores y sistemas para la corrección automática de códigos.

En particular, los ejemplos presentados en CodeNet se proporcionan con metadatos que describen los resultados de las pruebas de rendimiento, el tamaño del programa resultante, el consumo de memoria y el estado que permite distinguir el código correcto del código con errores (para distinguir el código correcto del código incorrecto, ejemplos con errores se incluyen especialmente en la colección, cuya participación es del 29,5%).

Un sistema de aprendizaje automático puede tener en cuenta estos metadatos para generar el código más óptimo o para detectar regresiones en el código analizado (el sistema puede entender que el algoritmo no está implementado de manera óptima en el código transmitido o contiene errores).

Finalmente si estás interesado en conocer más al respecto sobre CodeNet, puedes consultar los detalles en el siguiente enlace.

from Linux Adictos https://ift.tt/2Qcnje5
via IFTTT

Quadrapassel: una implementación del Tetris para tu Linux

Quadrapassel Tetris Linux

El Tetris fue un videojuego de lógica diseñado por el ruso Alekséi Pázhitnov de la Unión Soviética. Su lanzamiento se produjo en 1984, mientras trabajaba en el Centro de Computación de Dorodnitsyn de la Academia de Ciencias de la Unión Soviética en Moscú.

Su nombre proviene del prefijo griego tetra, ya que las piezas del juegos se conocen como tetrominós. Todos están compuestos por 4 segmentos distribuidos de diferente manera para generar formas diferentes que tendrás que ir colocando para completar líneas y que éstas desaparezcan con el objetivo de no saturar la pantalla…

Creo que la dinámica del juego está bastante vista ya, pero por si hay algún usuario que haya nacido más tarde a este videojuego y aún no lo conocía…

Dicho esto, el videojuego fue tan popular que se transformó en uno de los clásicos más jugados de la historia. Y, a lo largo de la historia, han ido apareciendo muchas implementaciones y variantes de todo tipo. Todas ellas muy adictivas, ya que, pese a la simple dinámica del juego, tiene algo que genera una atracción total.

Su popularidad es tal que se ha implementado para multitud de equpos, desde los Apple II, pasando por los Commodore 64, máquinas Atari, Amiga, Amstrad, ZX Spectrum, hasta nuevos Mac, PCs, videoconsolas antiguas y modernas, dispositivos móviles, para navegadores web, e incluso integrado como huevo de pascua en aparatos como los osciloscopios, para editores como Emacs, etc.

Pues bien, si quieres sentir tú mismo esa esencia que tanto atrae, y si tienes tiempos libres en los que te apetece liberar tu mente del trabajo o de los estudios y echarte una partida a algún videojuego, qué mejor que estos simples. Por eso, deberías conocer Quadrapassel.

Quadrapassel es una nueva implementación del clásico Tetris perteneciente al software de GNOME. Puedes instalarlo fácilmente en tu distro con GNOME, pero también funciona perfectamente en otros entornos de escritorio, simplemente se deberán satisfacer las dependencias de las bibliotecas y funcionarán sin problema alguno.

from Linux Adictos https://ift.tt/3w247yP
via IFTTT

Linus Torvalds habla sobre los usuarios comerciales de código fuente abierto

La semana pasada, Linus Torvalds continuó con una extensa entrevista por correo electrónico con Jeremy Andrews, socio fundador y director ejecutivo de Tag1.

En la primera parte de la entrevista en abril, Torvalds habló de todo, desde los chips ARM64 de Apple y los controladores Rust, hasta su propio entorno de trabajo desde casa basado en Fedora y sus pensamientos sobre los primeros días de Linux. Pero la segunda parte ofrece una visión más profunda de cómo piensa Torvalds, una visión personal de lo que compartiría con otros mantenedores de proyectos y algunas ideas sobre cómo conseguir que las empresas ayuden a hacer crecer el negocio.

Linus reveló cómo procedió cuando comenzó el proyecto:

“Todavía recuerdo los primeros días, cuando la gente me enviaba arreglos, y realmente no los aplicaba como arreglos, pero los leía, que entendía lo que la gente quería hacer y que lo hice yo mismo. Porque así comencé el proyecto, y así me sentí más cómodo y que conocía mejor el código ”. Linus también explicó que era importante aprender a delegar: “Dejé de hacerlo bastante rápido, porque básicamente soy un vago. Me volví muy bueno leyendo los parches y descubriendo lo que estaban haciendo, y luego los apliqué ”.

Linus también se esforzó por permanecer imparcial a medida que Linux crecía y se volvía más exitoso:

“Yo muy conscientemente no quería trabajar para una empresa de Linux, por ejemplo, mantuve Linux durante la primera década sin que fuera mi trabajo. Esto no es porque crea que los intereses comerciales son malos, sino porque quería asegurarme de que la gente me viera como una parte neutral y nunca me sentí como «la competencia». «

Si bien el código abierto ha tenido un gran éxito, muchos de los usuarios más grandes, como las empresas, hacen poco o nada para apoyar o contribuir a los proyectos de código abierto de los que dependen.

Continúa escribiendo:

“Y muchas de las grandes empresas de tecnología que utilizan el kernel terminan participando activamente en el proceso de desarrollo. A veces terminan haciendo mucho trabajo interno y no son muy buenos empujando las cosas hacia atrás (no nombraré nombres, y algunos de ellos realmente están tratando de hacerlo mejor), pero en realidad es muy alentador ver a las grandes empresas que están involucradas de manera muy abierta en el desarrollo básico upstream y son miembros importantes de la comunidad ”.

Cuando se le preguntó si el código abierto es sostenible o no, Linus respondió:

“Sí. Personalmente, estoy 100% convencido de que no solo el código abierto es sostenible, sino que para cuestiones técnicas complejas realmente necesita el código abierto solo porque el espacio del problema termina siendo demasiado complejo para ser manejado por una sola empresa. Incluso una empresa de tecnología grande y competente ”.

Clave para el éxito de los encargados del mantenimiento de proyectos de código abierto: «estar ahí TODO EL TIEMPO» y «estar abierto»

Cuando Andrews quiso saber qué hace que un proyecto de código abierto sea exitoso, Linus admitió:

“Realmente no sé cuál es la clave del éxito. Sí, Linux ha tenido mucho éxito y está claro que Git también ha comenzado con el pie derecho, pero todavía es muy difícil atribuirlo a una causa más profunda. ¿Quizás tuve suerte? ¿O fue porque de todas estas personas que necesitaban estos proyectos, yo fui el que se puso de pie, hizo el trabajo y comencé el proyecto? «

Pero Linus finalmente explicar» algunos puntos prácticos y con los pies en la tierra que yo personalmente considero importante si usted es un fabricante de software de código abierto «. Recomienda que una persona a cargo de un proyecto de código abierto esté «presente» todo el tiempo.

“Tienes que quedarte, tienes que estar ahí para los otros desarrolladores, y tienes que estar ahí TODO EL TIEMPO. Te encontrarás con problemas técnicos y será frustrante. Trabajará con personas que pueden tener ideas muy diferentes sobre cómo resolver estos problemas técnicos. Y los problemas técnicos son la parte más fácil, porque generalmente tienen soluciones técnicas, y a menudo se puede decir de manera bastante objetiva «esto es mejor / más rápido / más fácil / lo que sea» «.

La otra clave que explicó Linus es estar «abierto», «estar abierto a las soluciones de otras personas y no tener esta idea muy clara e inflexible de cómo se deben hacer las cosas». Pero Linus denuncia una de las formas de ser abierto:

“Es realmente fácil crear una especie de ‘camarilla’ de personas, donde tienes una camarilla interna que discute las cosas en privado, y luego realmente solo ves el resultado final (o marginal trabajar) a plena luz del día, porque todas las cosas importantes han sucedido dentro de una empresa o dentro de un grupo central de personas, y a los externos les resulta difícil penetrar estos clics y, a menudo, incluso les cuesta ver lo que está sucediendo en ese grupo principal porque era tan privado y exclusivo ”.

“Esta es una de las razones por las que realmente me gustan las listas de correo abiertas. No es una lista de «invitaciones». Ni siquiera tienes que registrarte para participar. Está realmente abierto. Y prácticamente todas las discusiones sobre desarrollo deberían estar allí ”.

Hablando de otras habilidades específicas necesarias para proyectos exitosos de código abierto, Linus explicó su experiencia. Según él, “no es el resultado de planificar y leer manuales de gestión, etc. La mayoría de las cosas sucedieron solas, y la estructura que tenemos hoy no proviene de un organigrama escrito, sino de personas que acaban de «encontrar su lugar». Como ya se mencionó anteriormente, Linus recomienda la delegación de tareas. También mencionó las habilidades de comunicación como «muy importantes».

Fuente: https://www.tag1consulting.com

from Linux Adictos https://ift.tt/3o6uAZD
via IFTTT

Microsoft, Google y ARM se unen a la Bytecode Alliance para mejorar el desarrollo de WebAssembly

A fines de 2019, en un esfuerzo conjunto para hacer de WebAssembly un runtime de computación multiplataforma, las empresas como Mozilla, Fastly, Intel y Red Hat anunciaron el lanzamiento de Bytecode Alliance. Esta iniciativa construida alrededor de WebAssembly se centra en proporcionar un código de bytes predeterminado seguro que se puede ejecutar desde un navegador web, escritorio o IoT/plataforma incrustada.

WebAssembly ha sido promocionado como una arquitectura de conjunto de instrucciones virtuales con muchos casos de uso capaces de tomar código escrito en lenguajes de programación distintos de JavaScript y ejecutar ese código en una plataforma específica, al menos un navegador en este caso.

Esta solución también debería permitir que aplicaciones complejas, como videojuegos inmersivos en 3D, diseño computarizado o edición de imágenes y videos, funcionen de manera óptima en las plataformas de destino. Gracias a WebAssembly, los desarrolladores podrían, por ejemplo, codificar sus aplicaciones en C, C ++ o Rust y ejecutar estos programas a velocidad nativa en un navegador web, sin tener que volver a pasar por JavaScript con las limitaciones que esto impone.

Según los promotores de la iniciativa, el auge de la nube y los dispositivos IoT está provocando que los desarrolladores ejecuten código poco fiable en nuevos entornos, lo que plantea nuevos problemas, especialmente en términos de seguridad y portabilidad.

Bytecode Alliance deberá proporcionar una base para que los desarrolladores ejecuten con seguridad código no confiable en cualquier infraestructura, sistema operativo y dispositivo. Esta comunidad de código abierto se centrará en configurar un entorno de ejecución y cadenas de herramientas lingüísticas asociadas, incluidas cargo-wasi, wat y wasmparser, que brindan seguridad, eficiencia y modularidad en una amplia gama de arquitecturas y periféricos.

Y ahora se han unido nuevos integrantes de renombre, tales como Microsoft, Arm, DFINITY Foundation, Embark Studios, Google, Shopify y University of California San Diego.

En un comunicado, Bobby Holley, un distinguido ingeniero de Mozilla y miembro de la junta de Bytecode Alliance, describió el desarrollo de software actual como un conjunto de difíciles compensaciones.

“Si desea construir algo grande, no es realista crear todos los componentes desde cero”, dijo Holley. “Pero depender de una compleja cadena de suministro de componentes de otras partes permite que una falla en cualquier parte de esa cadena comprometa la seguridad y estabilidad de todo el programa. Mozilla ayudó a crear WebAssembly para permitir que la web creciera más allá de JavaScript y ejecutara más tipos de software a velocidades más rápidas. Pero a medida que madura Quedó claro que las propiedades técnicas de WebAssembly, en particular el aislamiento de la memoria, también tenían el potencial de transformar el desarrollo de software más allá del navegador. Varias otras organizaciones compartieron este punto de vista y nos unimos para lanzar Bytecode Alliance como una asociación industrial informal a fines de 2019 ”.

“Las herramientas como los contenedores pueden proporcionar cierto grado de aislamiento, pero agregan una sobrecarga sustancial y son inconvenientes de usar con granularidad por parte del proveedor. Y todas estas dinámicas refuerzan las ventajas de las grandes empresas que tienen los recursos para gestionar y auditar cuidadosamente sus cadenas de suministro ”

Además se menciona que los miembros fundadores compartieron un montón de herramientas WASM con Bytecode Alliance, incluidos entornos de tiempo de ejecución, componentes de tiempo de ejecución y más.

Ahora, con Microsoft, Google y Mozilla a bordo, Bytecode Alliance cuenta con el apoyo de tres de los cuatro principales proveedores de navegadores. El editor de Safari Apple es el único proveedor importante de navegadores que falta. Con un apoyo más amplio, la alianza se da a sí misma una mejor oportunidad de supervivencia a largo plazo.

«WebAssembly y la nueva especificación WebAssembly System Interface (WASI) permiten que las soluciones nativas de la nube se vuelvan más seguras de forma predeterminada y ayuden a solucionar problemas de TI en una variedad de entornos», dijo Ralph Squillace, gerente senior de programas de Microsoft en Azure Core Upstream y miembro de la junta de Bytecode Alliance.

El trabajo de Microsoft en WebAssembly incluye su lanzamiento de Blazor WebAssembly, que permite a los desarrolladores de C# y .NET crear aplicaciones que se ejecutan en el navegador con WebAssembly, pero que funcionan como una aplicación de escritorio nativa, también conocida como aplicaciones web progresivas.

Blazor WebAssembly es una de las cuatro versiones del Blazor Project de Microsoft, que incluye la representación de Blazor Server compatible para aplicaciones web, un renderizador Electron y los enlaces experimentales Mobile Blazor recientemente lanzados para crear aplicaciones iOS y nativas de Android usando C # y .NET en lugar de JavaScript.

Fuente: https://bytecodealliance.org

from Linux Adictos https://ift.tt/3o8V10v
via IFTTT

Bottlerocket 1.1.0 llega con Kernel 5.10, SELinux, mejoras y mas

Bottlerocket

Se acaba de dar a conocer la liberación de la nueva versión de la distribución de Linux «Bottlerocket 1.1.0» la cual es desarrollada con la participación de Amazon para ejecutar contenedores aislados de manera eficiente y segura.

La distribución y los componentes de control están escritos en el lenguaje Rust y se distribuyen bajo las licencias MIT y Apache 2.0. Admite la ejecución de Bottlerocket en los clústeres de Amazon ECS y AWS EKS Kubernetes, así como la creación de versiones y revisiones personalizadas que permiten diferentes herramientas de tiempo de ejecución y orquestación de contenedores.

La distribución proporciona una imagen de sistema indivisible actualizada de forma automática y atómica que incluye el kernel de Linux y un entorno de sistema mínimo que incluye solo los componentes necesarios para ejecutar contenedores.

El entorno utiliza el gestor del sistema systemd, biblioteca Glibc, Buildroot, gestor de arranque GRUB, un runtime para containerd, contenedores de la plataforma Kubernetes, AWS-iam-autenticador y el agente de Amazon ECS.

Las herramientas de orquestación de contenedores se envían en un contenedor de administración separado que está habilitado de manera predeterminada y administrado a través de la API y el Agente de AWS SSM. La imagen base carece de un shell de comandos, servidor SSH e idiomas interpretados (por ejemplo, sin Python o Perl): las herramientas para el administrador y las herramientas de depuración se mueven a un contenedor de servicios separado, que está deshabilitado de manera predeterminada.

La diferencia clave con respecto a distribuciones similares como Fedora CoreOS, CentOS/Red Hat Atomic Host es el enfoque principal en proporcionar la máxima seguridad en el contexto de fortalecer el sistema contra posibles amenazas, lo que dificulta la explotación de vulnerabilidades en los componentes del sistema operativo y aumenta el aislamiento de contenedores. Los contenedores se crean utilizando los mecanismos estándar del kernel de Linux: cgroups, namespaces y seccomp.

La partición root se monta como de solo lectura y la partición de configuración /etc se monta en tmpfs y se restaura a su estado original después de reiniciar. No se admite la modificación directa de archivos en el directorio /etc, como /etc/resolv.conf y /etc/containerd/config.toml, para guardar permanentemente la configuración, usar la API o mover la funcionalidad a contenedores separados.

Principales novedades de Bottlerocket 1.1.0

En esta nueva versión de la distribución se ha incluido al kernel de Linux 5.10 con la finalidad de poder usarlo en nuevas variantes junto con las dos nuevas versiones de las distribuciones aws-k8s-1.20 y vmware-k8s-1.20 compatibles con Kubernetes 1.20.

En estas variantes, así como en la versión actualizada de aws-ecs-1, está involucrado un modo de bloqueo que está configurado en «integridad» de forma predeterminada (bloquea la capacidad de realizar cambios en el kernel en ejecución desde el espacio del usuario). Se eliminó el soporte para aws-k8s-1.15 basado en Kubernetes 1.15.

Además, Amazon ECS ahora admite el modo de red awsvpc, que le permite asignar interfaces de red y direcciones IP internas independientes para cada tarea.

Se agregaron configuraciones para administrar varias configuraciones de Kubernetes TLS bootstrap, incluidos QPS, límites de grupo y la configuración de Kubernetes cloudProvider para permitir el uso fuera de AWS.

En el contenedor de arranque se proporciona con SELinux para restringir el acceso a los datos del usuario, asi como una división a las reglas de política de SELinux para sujetos de confianza.

De los demás cambios que se destacan de la nueva version:

  • Ahora se puede hacer que Kubernetes cluster-dns-ip sea opcional para admitir el uso fuera de AWS
  • Se cambiaron los parámetros para respaldar un escaneo CIS saludable
  • Se añadió la utilidad resize2fs.
  • Se generó un ID de máquina estable para invitados de VMware y ARM KVM
  • Se habilitó el modo de bloqueo del kernel de «integridad» para la variante de vista previa de aws-ecs-1
  • Eliminar la anulación del tiempo de espera de inicio del servicio predeterminado
  • Evitar que los contenedores de arranque se reinicien
  • Nuevas reglas de udev para montar CD-ROM solo cuando hay medios presentes
  • Soporte para la región de AWS ap-noreste-3: Osaka
  •  URI de contenedor de pausa con variables de plantilla estándar
  • Capacidad poder obtener IP de DNS del clúster cuando esté disponible

Finalmente si estás interesado en poder conocer más al respecto sobre esta nueva versión liberada o estás interesado en la distribución, puedes consultar los detalles en el siguiente enlace.

from Linux Adictos https://ift.tt/3f6h0kK
via IFTTT

Cómo instalar TensorFlow en un hosting cloud

Tensorflow

La inteligencia artificial avanza a pasos agigantados. Cada vez es más poderosa y permite aplicarse a nuevas tareas. El aprendizaje automático es uno de los campos de la IA al que debes prestar especial atención, con proyectos como TensorFlow. Si dispones de un servidor o hosting cloud, podrás instalar este proyecto allí para darle la capacidad de aprender sin necesidad de programar de forma explícita.

En este tutorial mostraré, paso a paso, cómo puedes instalar este proyecto de código abierto tan potente en un hosting cloud. Para ello, he elegido como referencia Clouding, por sus precios, facilidad, soporte en español 24/7, disponibilidad, prestaciones y, muy especialmente, por tener su centro de datos en territorio español, en Barcelona. Por tanto, estará bajo las leyes europeas de protección de datos…

¿Cómo me puede ayudar Tensorflow a mi negocio?
Apps empresariales

En la pandemia, se ha hecho mucho más evidente que las empresas necesitan modernizarse para poder ser competitivas. Gran parte de las ayudas europeas irán dirigidas precisamente a esa transición digital. Todos los negocios que no se han adaptado, han sufrido más las consecuencias económicas de esta crisis sanitaria. Por ejemplo, incluso los pequeños negocios se han apresurado a cambiar sus ventas físicas por las ventas online, lo que les ha permitido seguir funcionando sin que las medidas de las restricciones les afecten.

Tecnologías como la nube, el IoT, o la IA, son fundamentales. En concreto, con TensorFlow y el aprendizaje automático, podrás conseguir grandes beneficios. Por citar solo algunos ejemplos:

  • Mejorar imágenes usando IA si te dedicas a temas de diseño o fotografía.
  • Ayudar con el diagnóstico médico analizando los resultados de pruebas médicas.
  • Procesamiento de imágenes de forma ágil y catalogación automatizada.
  • Enseñarle reconocimiento de voz o de sonidos.
  • Análisis facial, de sentimientos, etc.
  • Detección de fallos automatizado.
  • Detección de idiomas en textos de forma automática.
  • Agilizar multitud de tareas cotidianas de la empresa.
  • Y un largo etc. Las aplicaciones son casi inimaginables…

Por eso, es ampliamente usado en la industria, en sectores como el automóvil, también en el sector sanitario, en seguros, agencias tributarias, y otros muchos profesionales.

¿Qué es TensorFlow?
logo Tensorflow

TensorFlow es un software de código abierto, desarrollado inicialmente por ingenieros e investigadores de Google, y más tarde liberado. Una biblioteca para computación numérica y aprendizaje automático. Emplea gráficos de flujo de datos para ello, los nodos representan operaciones matemáticas, mientras los bordes representan matrices de datos multidimensionales (tensores) comunicadas entre ellos.

Con este software se permite construir y entrenar redes neuronales artificiales para realizar múltiples tareas, como detectar y descifrar patrones y correlaciones, de una forma análoga a la forma de aprender y razonar que tienen los seres humanos.

Este proyecto también aporta mucha flexibilidad, pudiendo realizar los cálculos usando CPU o GPU, tanto una como varias de ellas, en PCs, servidores e incluso dispositivos móviles. Eso es posible puesto que es multiplataforma, pudiéndose ejecutar en sistemas como GNU/Linux, macOS, Windows, iOS y Android, así como un servicio web como veremos en este tutorial. Incluso dispone de varios envoltorios para usar diferentes lenguajes de programación: Python, C++, o Java. Todo con una única API.

Instalar TensorFlow paso a paso

Lo siguiente es mostrar un ejemplo paso a paso de cómo instalar TensorFlow en un hosting cloud. Para ello, emplearé un VPS de Clouding.io, donde se pueden elegir tanto sistemas operativos Windows como Linux. Por supuesto, dada la temática del blog y las bondades de GNU/Linux, no hay duda de que me basaré en una distro Linux.

Crear la cuenta y preparar la plataforma de Clouding

Antes de comenzar, hay que registrarse para obtener acceso al servicio que ofrece este proveedor y así disfrutar de los 5€ de saldo gratis que ofrecen para probar la plataforma. Será tan sencillo como seguir los pasos que indican para la verificación de la cuenta. Sólo toma un minuto.
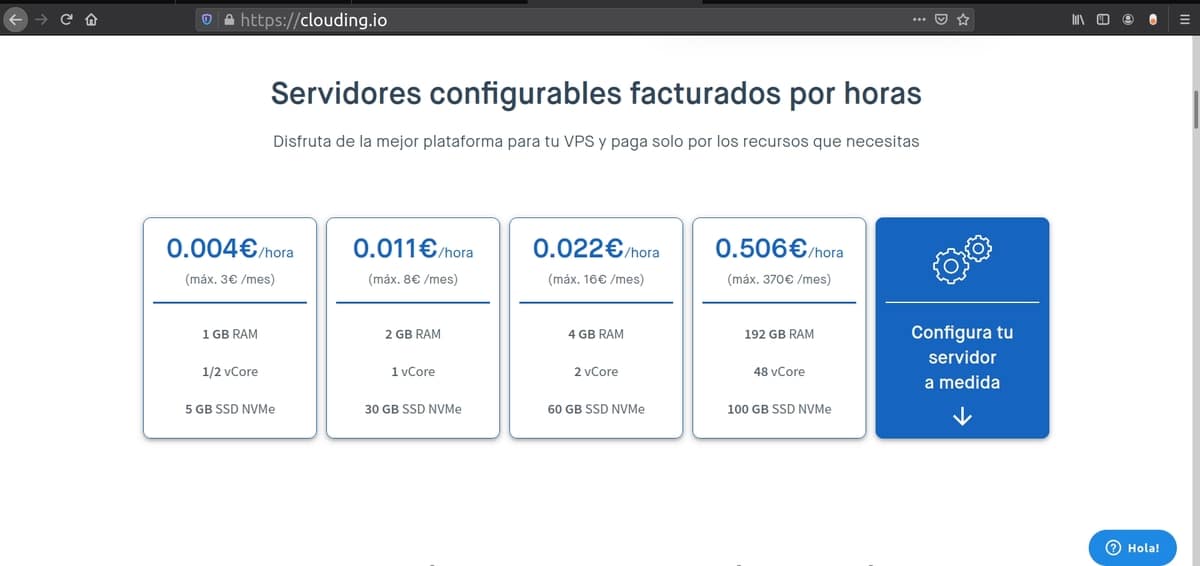
clouding

Después, deberás volver a la web oficial de Clouding y logearte introduciendo tu usuario y contraseña:
registro Clouding

Ahora ya puedes ver el panel de control de Clouding, que como verás es bastante sencillo e intuitivo de usar. Incluso sin demasiados conocimientos podrás manejarlo sin problema siguiendo este tutorial. Para comenzar a crear una instancia para TensorFlow, pulsa Haz click aquí para crear tu primer servidor:
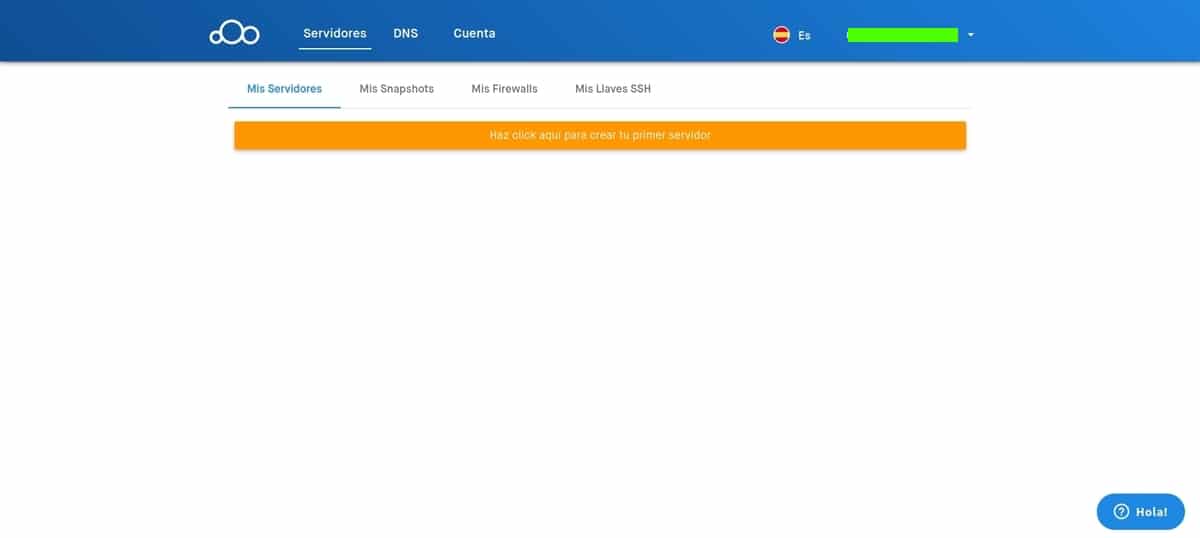
Inicion Cluding Tensorflow

Eso te llevará al menú de configuración de tu servidor. Lo primero será poner el nombre a tu VPS, puedes elegir el que prefieras. Luego hay que elegir el SO. Para este tutorial seleccionaré una de las distros que ofrecen (CentOS, Ubuntu Server, Ubuntu Desktop o Debian). Puedes elegir la que prefieras, en mi caso elegiré un Ubuntu Server 20.04:

Hosting configuración

Una vez seleccionado el sistema base, lo siguiente es configurar el resto de parámetros que aparecen en esa misma página más abajo. Como ves, entre las opciones de configuración de la máquinas podrás elegir la cantidad de RAM, los núcleos de vCPU, o el espacio de almacenamiento SSD que necesitas. Para TensorFlow en sí no necesitarás mucho, pero puede que para el resto de datos que tengas que manejar sí, por tanto, piensa bien lo que necesitas (no obstante, se puede escalar):
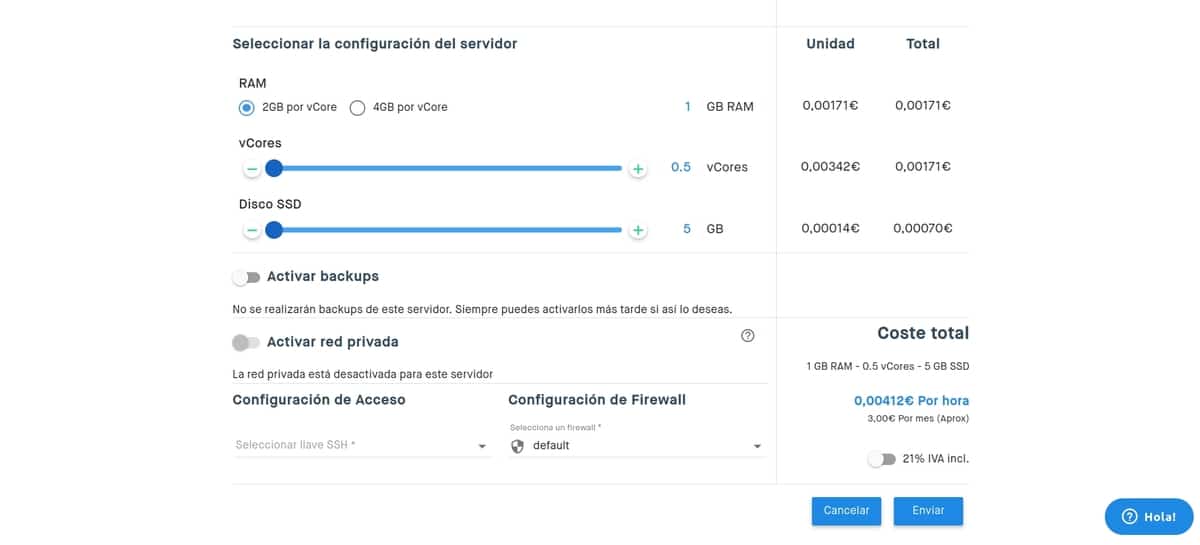
Instancia Tensorflow

También es importante que crees la llave SSH, dando el nombre que quieras. Eso te permitirá descargar el par para poder acceder remotamente sin tener que estar introduciendo la contraseña de forma manual cada vez que quieras entrar. Además, también te permite configurar el Firewall o copias de seguridad. En este caso, tanto los backups como el firewall lo dejamos como está.

Si ya has terminado, comprueba que esté todo OK y pulsa Eviar. Eso te redirige a otra pantalla con tu instancia cloud creada. Pero en el apartado de estado verás que se está creando:
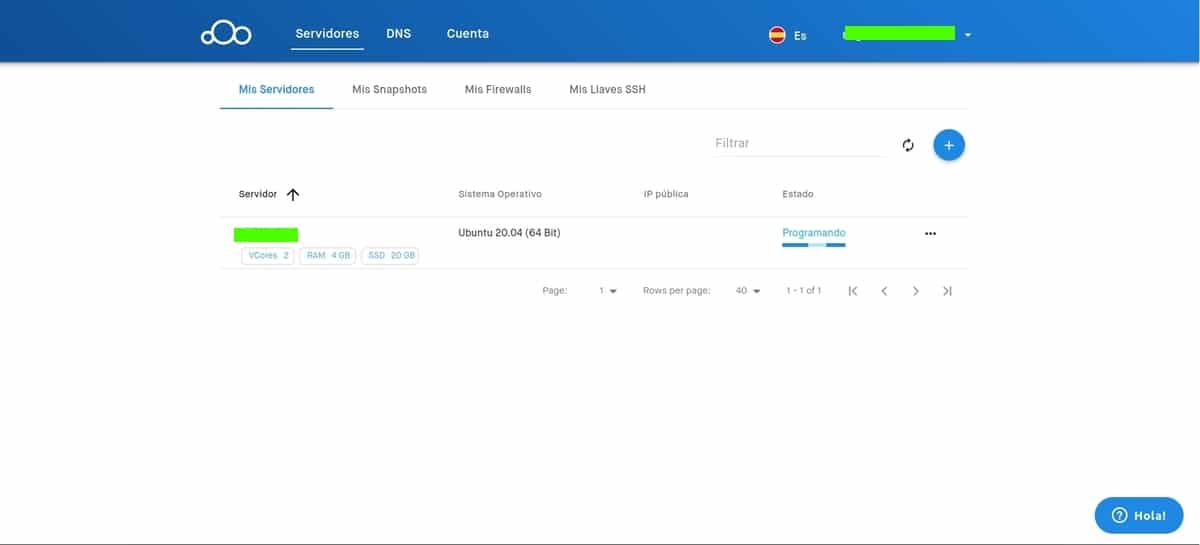
Instancia Tensorflow

En un abrir y cerrar de ojos, estará el sistema instalado y configurado. Entonces aparecerá el estado como Activo. Y ya puedes usarlo.
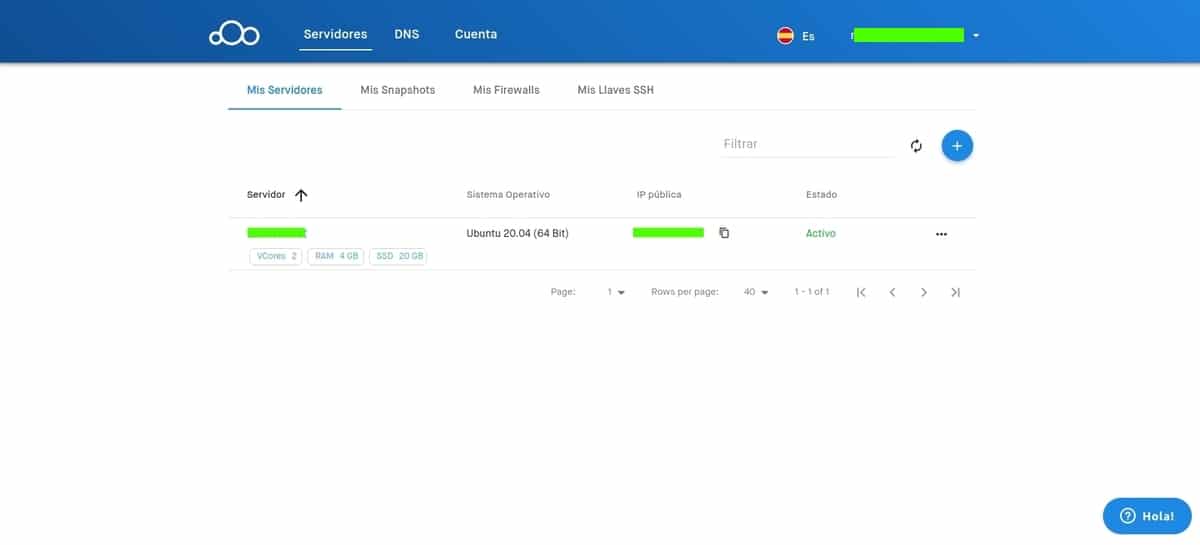
SERVIDOR Cluding Activo

Pulsa sobre el nombre de tu servidor en esta pantalla y te llevará a un resumen con los detalles:
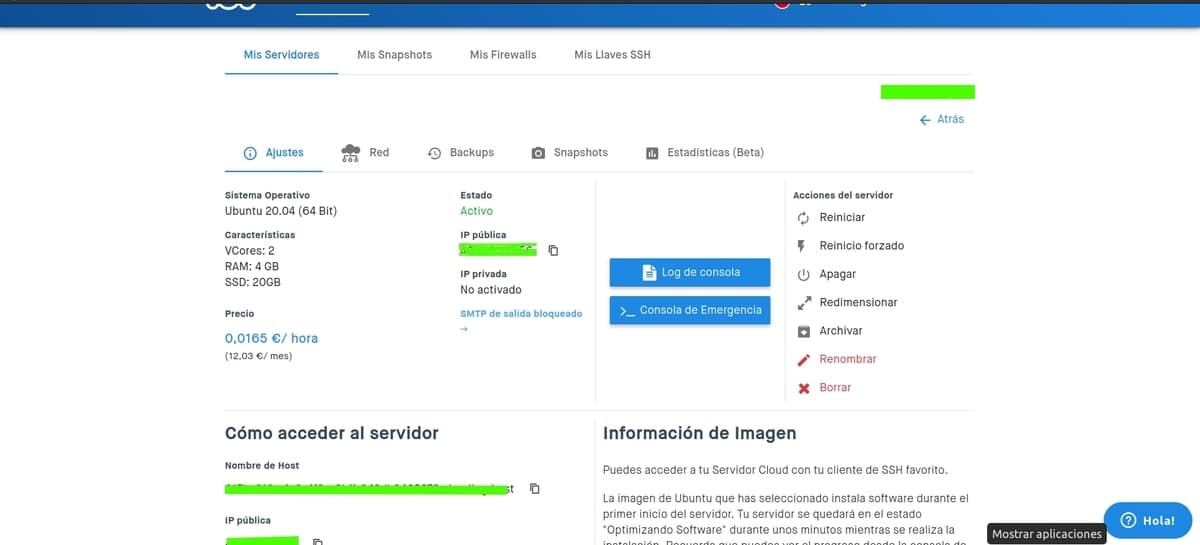
Configuración principal de acceso

Si haces scroll, encontrarás el apartado Cómo acceder al servidor. Es muy importante, ya que aquí es donde encontrarás todo lo necesario para acceder a tu servidor y administrarlo. Por ejemplo, te puedes bajar la clave SSH, o puedes ver la IP pública por la que acceder por SSH, el nombre de usuario (root), y la contraseña de acceso:

Claves ssh

No pierdas esos datos, puesto que te harán falta en los próximos pasos para comenzar a instalar Tensorflow en tu instancia de Clouding.

Pre-requisitos

Para comenzar, lo primero que hay que hacer es satisfacer algunas dependencias o paquetes que serán útiles para Tensorflow, así como actualizar para garantizar que todo está en su versión más reciente. Para ello, vamos a entrar en el terminal para conectarlos por SSH con la contraseña y la IP que mostré en la imagen anterior para acceder desde tu distro de forma remota a la instancia (recuerda sustituir tuipdelservidor por la IP de la instancia de Clouding):

ssh root@tuipdelservidor
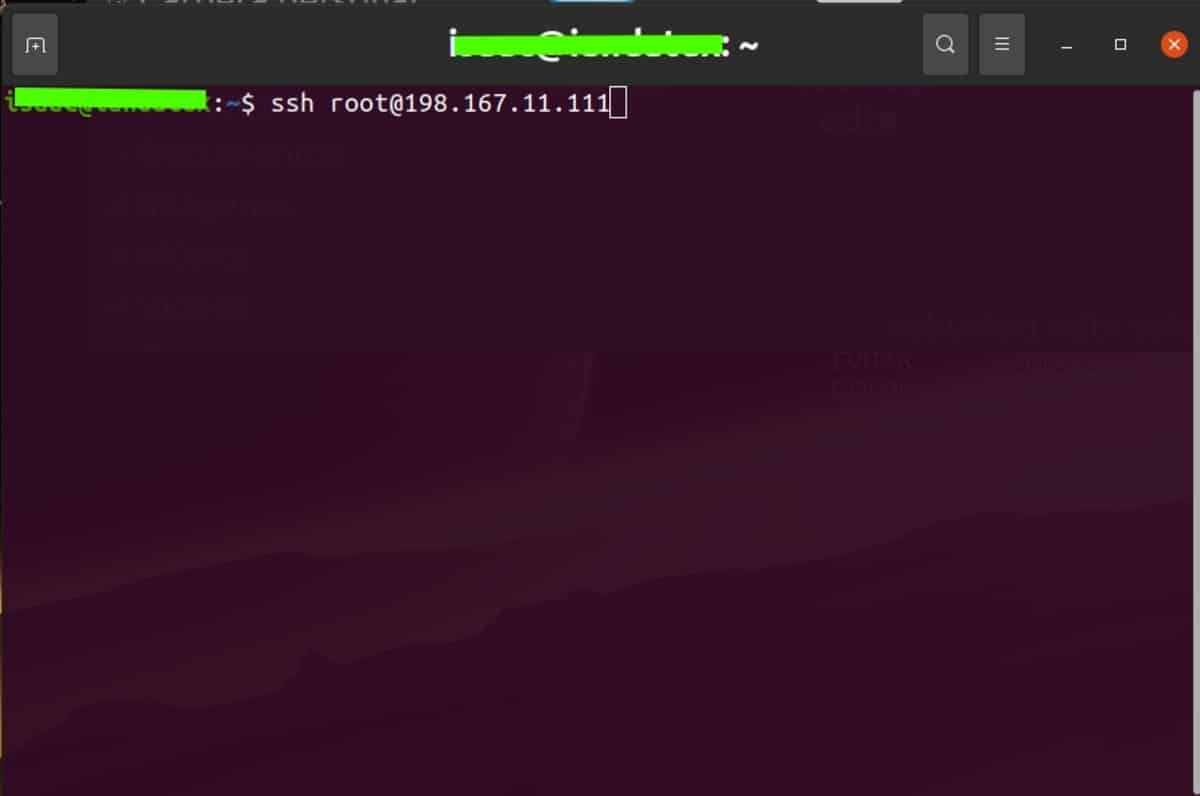
acceso ssh

Te pedirá la contraseña de la instancia que también tendrás que introducir y eso te dará acceso. Verás que el prompt de tu terminal ya no es el tuyo local, sino que estás dentro del servidor cloud. Por tanto, todos los comandos que ejecutes a partir de ahora, tendrán efecto en la instancia y no en tu sistema local.
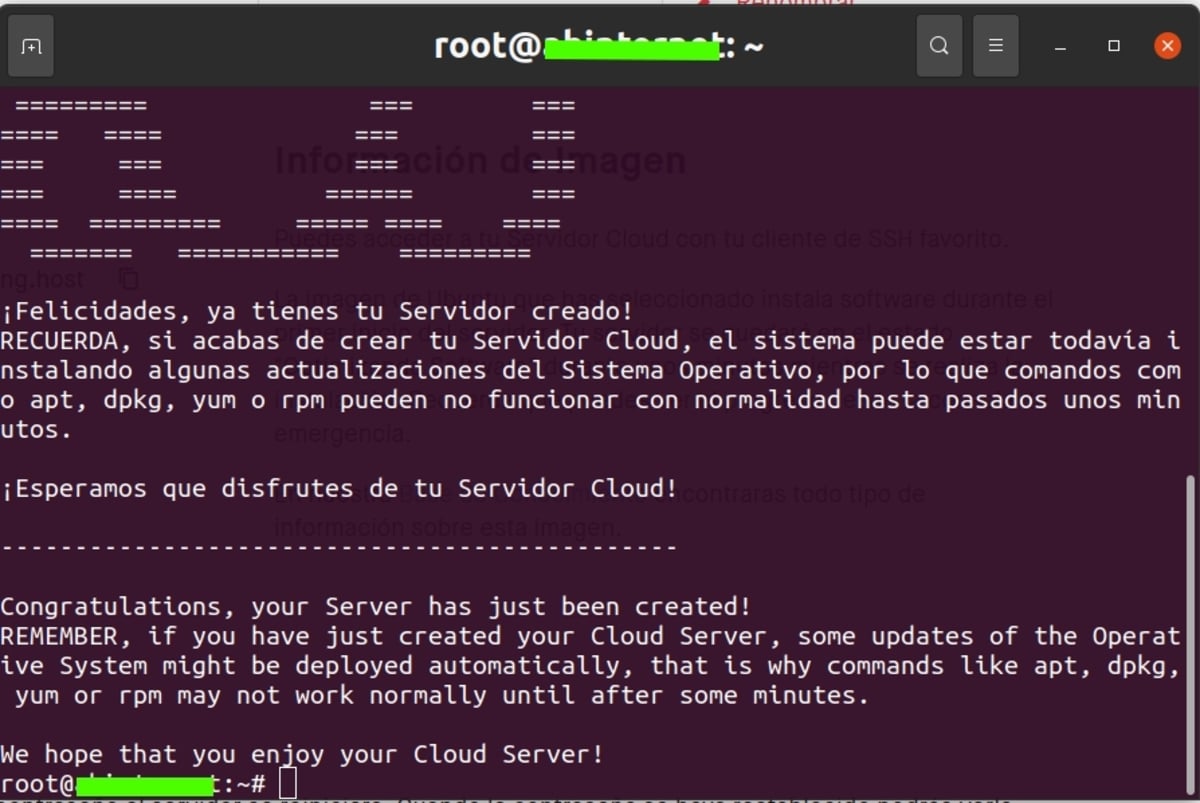
acceso ssh

Ahora, lo primero es actualizar el sistema con los siguientes comandos:

apt-get update && apt-get -y upgrade
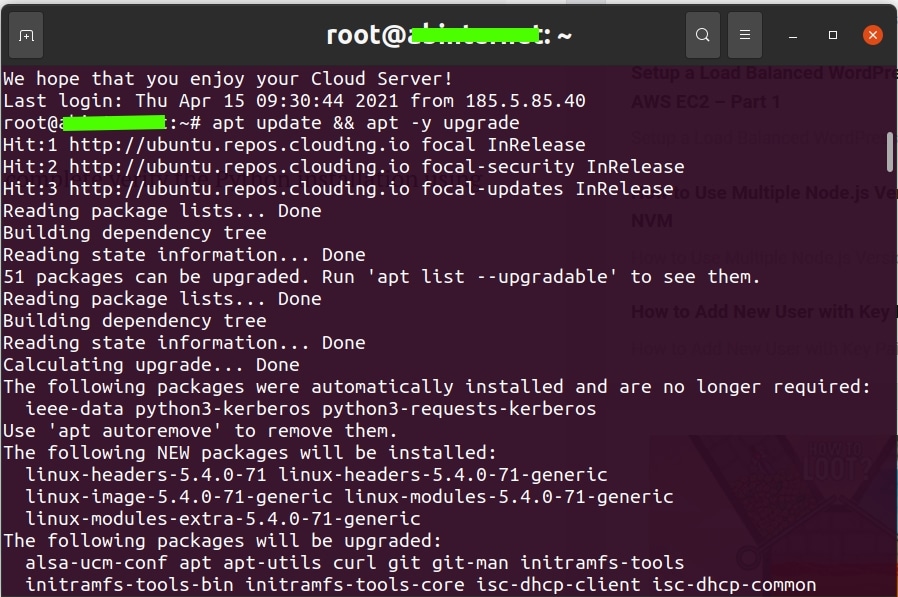
instalando Tensorflow

Ahora, deberás instalar Python3 y otros paquetes auxiliares que necesitarás:

apt-get install python3 python3-pip python3-dev

Lo siguiente es preparar el entorno virtual, usando el módulo virtualenv, que forma parte de la biblioteca estándar de Python3:

pip3 install virtualenv

mkdir ~/miproyecto

cd ~/miproyecto

virtualenv tf-env

source tf-env/bin/activate
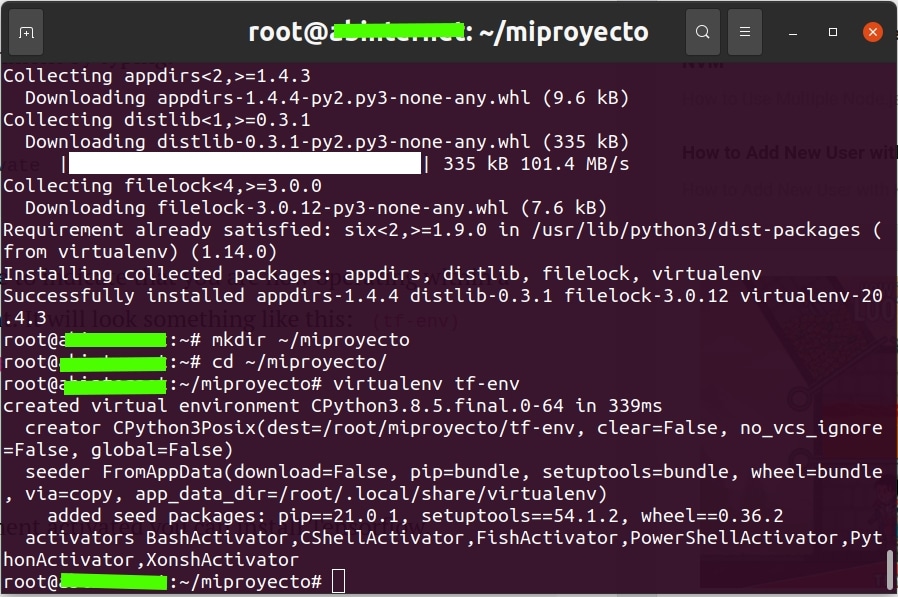
instalación modulos python

Tras eso notarás que tu prompt ha cambiado, y ahora muestra tf-env antes del nombre de usuario y host.
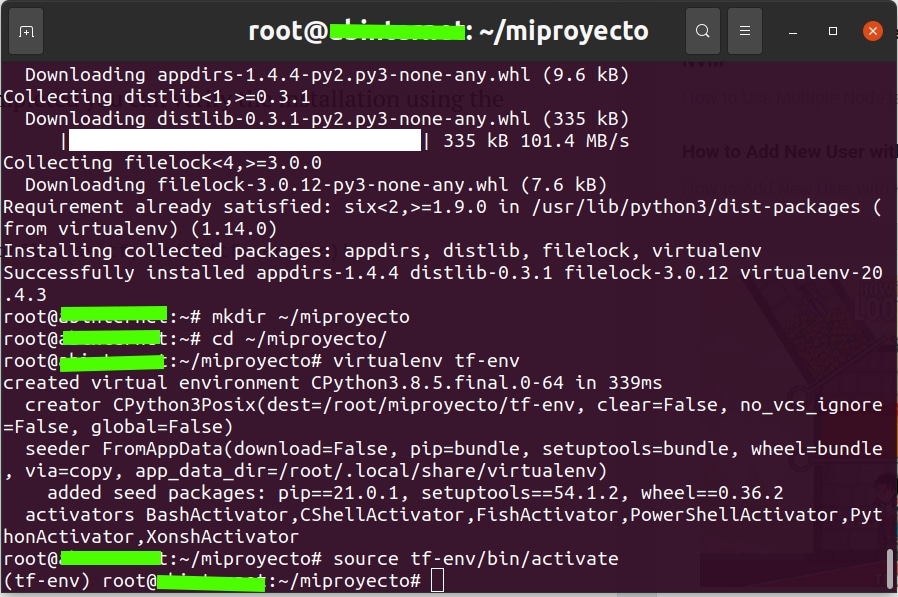
prompt

Instalar Tensorflow (soporte para CPU)

Ya está todo preparado para la instalación de TensorFlow en tu instancia de Clouding. El siguiente paso a seguir sería:

pip install --upgrade tensorflow

Una vez se ha instalado, puedes verificar la instalación usando el siguiente comando:

python -c ‘import tensorflow as tf; print(tf.version)’

Y eso te debería devolver una salida con la versión de Tensorflow instalada. A partir de ahí, ya podrías comenzar a usar Tensorflow para cualquier tarea que necesites…

Conclusión

En conclusión, las facilidades que ofrece Clouding para trabajar con sus VPS hacen que la experiencia para instalar cualquier proyecto como Tensorflow, o realizar configuraciones, sea tan fácil como hacerlo en tu máquina local. Solo que con la potencia y escalabilidad de este tipo de servidores.

Además, su panel de control es bastante intuitivo y el asistente te guía incluso si no tienes grandes conocimientos técnicos. Por otro lado, las opciones que te da también son muy flexibles, pudiendo elegir tanto los recursos del hardware virtual que necesitas, como el sistema operativo. Esa versatilidad hace que se adapte de maravilla a tus necesidades, por muy particulares que sean.

from Linux Adictos https://ift.tt/33vfIui
via IFTTT

Cifrar una memoria USB en Linux de forma muy sencilla

Pendrive USB Windows 10

Cuando tienes una memoria USB que quieres asegurar para evitar miradas indiscretas, es probable que necesites cifrar tus datos para que nadie sin la clave pueda acceder a ellos. Por ejemplo, cuando se comparte uno de estos dispositivos o está al alcance de varias personas que no deberían tener acceso, es la mejor solución para protegerla.

Hacerlo en Linux es muy sencillo, tienes varias opciones para ello. Por ejemplo, en este tutorial usaré un método válido para la distro Debian/Ubuntu y derivados, aunque también puede funcionar de forma similar para otras si instalas las apps que aquí voy a detallar.

Para poder cifrar tu memoria USB, lo primero debes tener los dos programas a usar. Uno de ellos es la herramienta gráfica Disks (Discos), una utilidad que ya tendrás instalada si empleas el entorno de escritorio GNOME por defecto. La otra es cryptsetup, que es una herramienta para la CLI. Si por algún caso no los tuvieras, te recomiendo ejecutar estas órdenes:


sudo apt-get install update -y

sudo apt-get install -y gnome-disk-utility cryptsetup

Ahora, ya las deberías tener instaladas. Lo siguiente es determinar el nombre de tu memoria USB para cifrar. Para ello, conecta tu pendrive en el puerto USB y ejecuta la orden


lsblk

Eso listará los medios disponibles, entre ellos deberías detectar cuál es la partición o medio correspondiente a tu memoria USB. Es importante que conozcas bien el nombre y no te confundas, o podrías cifrar otra unidad que no es la correcta…

Es importante que el pendrive no tenga nada dentro, o si lo tiene, que hagas copia de seguridad, ya que se borrarán los datos en el proceso, ya que se va a formatear la unidad.

Ahora comenzarían los pasos para el cifrar la unidad:

  1. Abre Discos o Disk.
  2. Selecciona allí el pendrive USB entre las unidades que aparecen en la izquierda.
  3. Desmonta la unidad haciendo clic sobre el recuadro Detener que está en la derecha, bajo la imagen de la partición.
  4. Pulsa ahora en el icono de engranajes para desplegar las opciones. Elige Formatear partición…
  5. Es el momento de seleccionar las opciones. Pon el nombre que quieras a tu unidad USB. En la sección Tipo elige «Disco interno para usarlo solamente con sistemas Linux (ext4)«. Marca también «Volumen protegido por contraseña (LUKS)» para cifrar.
  6. Pulsa Siguiente.
  7. En la siguiente ventana te pide la contraseña para cifrar. No la pierdas, o no podrás acceder a tus datos. Una vez la escribes dos veces, pulsa Siguiente.
  8. Ahora te muestra una advertencia de que se perderán los datos al formatear. Pulsa Formato.
  9. Espera a que termine el proceso y tendrás ya la unidad lista.
  10. Ahora, para los accesos te pedirá la contraseña, por eso, nadie que no la posea podrá acceder a los datos.

from Linux Adictos https://ift.tt/3o6jZha
via IFTTT