Unknown's avatar

About Frank Cisco

Esposo, papá. Entusiasta de Linux y F1.

Express AI: privacidad y productividad en un entorno de cómputo confidencial


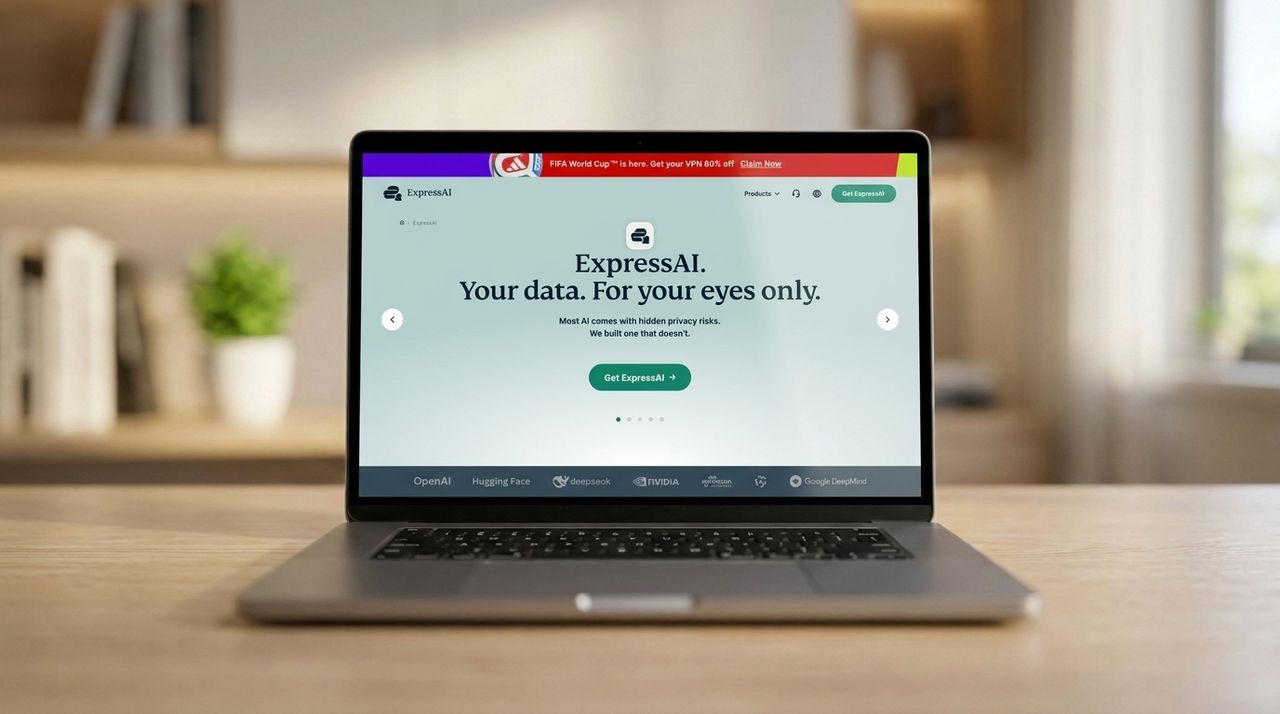
Express AI, lanzado el 31 de marzo de 2026, es el intento de ExpressVPN por responder a una pregunta que muchos usuarios de IA no se han planteado: ¿quién puede leer tus chats? La plataforma ofrece acceso a cinco modelos de IA dentro de un entorno de cómputo confidencial, donde los prompts y las salidas están criptográficamente aislados de todos, incluido ExpressVPN. Es una afirmación audaz en una categoría donde las políticas de privacidad tienden a ser largas en palabras y cortas en cumplimiento.

La plataforma se incluye con el plan Pro de ExpressVPN, sin costo adicional, posicionándose junto al gestor de contraseñas, correo seguro y herramientas de protección de identidad de la empresa. He cubierto plataformas de IA y software empresarial durante años para TechRadar Pro, incluyendo nuestras guías de compra de 2026 para codificadores y herramientas de IA, OpenClaw y Moltbook.

Para esta reseña, pasé tiempo usando Express AI en una variedad de tareas cotidianas: redacción, resumen de documentos y razonamiento frente a problemas técnicos, para ver cómo se desempeña frente a plataformas de IA más conocidas.

Qué es Express AI?
Express AI es una plataforma de chat de IA multi-modelo diseñada por ExpressVPN y accesible en app.expressai.com. En su lanzamiento, ofrece acceso a cinco modelos de propósito general, cada uno seleccionado para un tipo de tarea diferente. Lo que la diferencia de plataformas como ChatGPT o Claude no es la cartera de modelos, sino su arquitectura subyacente: cada interacción se ejecuta dentro de un entorno de cómputo confidencial donde las claves de cifrado se generan dentro del hardware, aislando matemáticamente las conversaciones de proveedores de nube, operadores de modelos y de ExpressVPN.

La plataforma está dirigida a profesionales e individuos que comparten información sensible en sus chats de IA, como preguntas financieras, documentos de trabajo y comunicaciones personales, y que quieren garantías de que sus datos no se retendrán ni se usarán para entrenar modelos futuros. Es especialmente adecuada para usuarios ya integrados en el ecosistema de ExpressVPN, ya que el acceso está vinculado a la suscripción Pro.

Las afirmaciones de privacidad en el espacio de IA son fáciles de hacer y difíciles de verificar, por eso ExpressVPN encargó una auditoría independiente a Cure53, una firma alemana de ciberseguridad conocida por evaluaciones rigurosas. La revisión previa al lanzamiento, realizada en febrero y marzo de 2026, abarcó pruebas de penetración, inspección de código fuente y análisis de la criptografía y gestión de claves del sistema. Cure53 confirmó que Express AI procesa las interacciones de los usuarios dentro de enclaves de cómputo confidencial y no encontró vulnerabilidades sin resolver al momento del lanzamiento.

Express AI: vistas rápidas
– Modelo subyacente: cinco modelos de código abierto: GPT OSS 120B, DeepSeek R1 Distill 32B, Qwen2.5-VL 32B, Qwen3.5 35B-A3B y Nemotron 12B.
– Mejor para: profesionales conscientes de la privacidad, análisis de documentos sensibles y comparaciones entre múltiples modelos.
– Funciones distintivas: cómputo confidencial, Ghost Mode, bóveda cifrada, comparación entre modelos lado a lado, sin retención de datos.
– Interfaz de usuario: interfaz de chat limpia con selección por modelo, monitor de créditos y soporte para carga de archivos.
– Coste de suscripción: incluido con ExpressVPN Pro; sin plan gratuito independiente.
– Precio de API: no hay acceso público a la API en el lanzamiento.

Cómpralo si…
– Compartes información sensible con herramientas de IA. Si tus prompts suelen incluir datos personales, financieros o profesionales, la arquitectura de cero acceso de Express AI ofrece una capa de protección que las plataformas convencionales no ofrecen.
– Quieres múltiples modelos sin gestionar varias suscripciones. La plataforma agrupa cinco modelos en una sola interfaz, cubriendo escritura, análisis de documentos y codificación, reduciendo costos y fricción.

No lo compres si…
– No eres suscriptor de ExpressVPN. El acceso requiere un plan Pro, por lo que pagarás por un conjunto de VPN junto a la plataforma de IA.
– Necesitas API o control a nivel de desarrollador. Express AI no ofrece API pública al lanzamiento, lo que lo convierte en una opción poco atractiva para desarrolladores.

Mi experiencia con Express AI
La interfaz es sobria y deliberadamente simple. Seleccionas un modelo, escribes tu prompt y obtienes una respuesta. No hay un panel lateral con herramientas o ajustes enterrados en tres menús. Encontré la conmutación de modelos la característica más útil: ejecutar el mismo prompt en DeepSeek R1 Distill 32B para tareas de razonamiento y luego en Qwen2.5-VL 32B para análisis de documentos tomó segundos, en lugar de un constante cambio de pestañas entre plataformas.

Ghost Mode funcionó como se describía: las conversaciones desaparecen tras la sesión sin rastro en el panel de historial. La bóveda cifrada almacena conversaciones pasadas bajo una contraseña establecida por el usuario, lo que significa que el historial no es accesible del lado del servidor, aunque olvidar la contraseña elimina el historial de forma permanente. Es un intercambio razonable para la garantía de privacidad, pero hay que considerarlo si dependes del historial de conversaciones para la continuidad del flujo de trabajo.

Una nota honesta: no pude verificar de forma independiente las afirmaciones de cómputo confidencial más allá de lo publicado por Cure53. Tomo la auditoría como válida, tal como lo harán la mayoría de usuarios. Los 500 créditos diarios a un crédito por prompt me parecieron suficientes para mi prueba, pero podrían frustrar a usuarios que realizan sesiones de investigación largas e iterativas.

Características de Express AI
Express AI lanza con cinco modelos abiertos en lugar de desarrollar modelos propios desde cero. GPT OSS 120B maneja escritura y razonamiento cotidiano; DeepSeek R1 Distill 32B es ideal para lógica multietapas y análisis; Qwen2.5-VL 32B lee y extrae datos de imágenes y documentos; Qwen3.5 35B-A3B se orienta a codificación y prompts complejos; y Nemotron 12B de NVIDIA maneja tareas técnicas y matemáticas. En la práctica, tenerlos en una sola interfaz permite adaptar el modelo a la tarea sin mantener cuentas o claves API separadas.

La herramienta de comparación lado a lado es destacada. Puedes ejecutar el mismo prompt en varios modelos simultáneamente para comparar salidas, lo cual es útil para decidir qué modelo usar en una tarea recurrente. Muy pocas plataformas de IA independientes ofrecen esto de forma nativa.

Ghost Mode y la bóveda cifrada abordan las dos principales categorías de riesgo de privacidad. Ghost Mode elimina automáticamente las conversaciones después de cada sesión, dejando sin registro. La bóveda almacena el historial bajo cifrado controlado por el usuario: solo la contraseña puede descifrarlo, ni ExpressVPN ni los proveedores de modelos pueden acceder a él. Estas no son afirmaciones de marketing; la auditoría de Cure53 verificó ambos mecanismos antes del lanzamiento.

Los archivos pueden cargarse de hasta 50 MB por archivo. Los 2 GB de almacenamiento seguro incluidos con el plan Pro suelen ser suficientes para la mayoría de tareas de análisis de documentos. Probé PDFs e imágenes sin problemas, y Qwen2.5-VL 32B manejó el análisis con precisión en mis pruebas. También hay un monitor de crédito transparente, que muestra el uso diario restante de forma clara.

Lo que falta, al menos en el lanzamiento, es la capacidad de agentes. Express AI no soporta uso de herramientas, navegación web ni tareas autónomas en varios pasos. Es una interfaz de chat, y así se decidió. Para usuarios que buscan agentes de IA que gestionen flujos de trabajo o se integren con servicios externos, tendrán que buscar otras opciones. La posición sin API también limita el atractivo de Express AI para desarrolladores, lo que podría reducir la audiencia de la plataforma más de lo que ExpressVPN pretende.

Experiencia de usuario de Express AI
La interfaz prioriza la simplicidad, adecuada para la audiencia principal. Los nuevos usuarios pueden iniciar una conversación en menos de un minuto. No hay tutorial de incorporación ni demostraciones de funciones, pero el diseño es lo suficientemente intuitivo para que la mayoría no necesite uno. El conmutador de modelos y el modo Ghost están en el centro, por lo que no requieren buscar en menús.

En diseño, se siente más como una herramienta de productividad enfocada que como una plataforma de IA completa. Esa contención funciona a favor de usuarios preocupados por la privacidad que no buscan complejidad, pero podría parecer austero para quienes vienen de interfaces más densas como las de ChatGPT o Claude. ExpressVPN ha descrito Express AI como parte de un ecosistema de privacidad más amplio, sugiriendo posibles expansiones, pero la versión de lanzamiento no ofrece profundidad inmediata para usuarios avanzados.

Soporte al cliente de Express AI
Express AI hereda la infraestructura de soporte de ExpressVPN, que incluye chat en vivo 24/7 a través del sitio principal de ExpressVPN. Los tiempos de respuesta en mi experiencia han sido rápidos, típicamente menos de dos minutos. Los agentes conocen el conjunto de VPN, pero pueden tener profundidad limitada en consultas técnicas específicas de Express AI, dada la reciente llegada de la plataforma.

La documentación de soporte para Express AI es actualmente escasa. La base de conocimientos cubre preguntas de configuración y facturación, pero la guía detallada sobre selección de modelos, uso de créditos y la bóveda cifrada es escasa. Dada la novedad del producto, es comprensible, pero los usuarios que afronten casos límite podrían encontrar la documentación menos útil de lo que esperarían.

Precio de Express AI
– Incluido con ExpressVPN Pro. Express AI está disponible sin costo adicional para suscriptores Pro, lo que lo convierte en el modelo de precio más accesible para usuarios existentes.
– El plan Pro empieza en 7,49 USD/mes con compromiso de 2 años, sube a 8,99 USD/mes con plan de 1 año y a 19,99 USD/mes en modalidad mes a mes.
– No hay plan independiente ni nivel gratuito. No hay forma de acceder a Express AI sin una suscripción activa a ExpressVPN Pro.

El precio es sencillo una vez aceptas que Express AI es un beneficio incluido en el paquete, no un producto independiente. Los suscriptores Pro obtienen 500 créditos diarios, 2 GB de almacenamiento cifrado y acceso a los cinco modelos junto con las demás características de ExpressVPN. Para usuarios que ya pagan por un plan Pro, Express AI no añade coste.

Para usuarios que no necesitan una VPN, la propuesta de valor es menos clara. El plan Pro de 19,99 USD/mes es competitivo con algunas suscripciones de IA independientes (por ejemplo, ChatGPT Plus cuesta 20 USD/mes), pero estás pagando primero por un conjunto de VPN y luego por una plataforma de IA. ExpressVPN no ha anunciado un plan independiente para Express AI, por lo que esa decisión seguirá en el aire.

Alternativas a considerar
– ChatGPT (OpenAI): la plataforma de IA más usada, con mayor acceso a modelos, API y capacidades de agente, pero sin cómputo confidencial ni arquitectura de cero acceso.
– Claude (Anthropic): una buena alternativa para escritura y razonamiento, con políticas de privacidad competitivas, aunque los prompts pueden ser revisados para seguridad y mejora del modelo.
– Lumo (Proton): una alternativa orientada a la privacidad de los creadores de ProtonMail, que vale la pena vigilar a medida que desarrolla su conjunto de herramientas de IA para usuarios preocupados por la privacidad.

Cómo evalué Express AI
– Utilicé Express AI para redacción, resumen y respuesta a preguntas de investigación en varias sesiones para evaluar calidad de modelo y consistencia.
– Cargué PDFs e imágenes para probar la capacidad de extracción de datos y respuestas de Qwen2.5-VL 32B sobre contenido subido.
– Probé Ghost Mode, la bóveda cifrada y el seguimiento de créditos para confirmar que se comportaban como se describe en la documentación y la síntesis de la auditoría Cure53.

En resumen, Express AI presenta una propuesta centrada en la privacidad dentro de un ecosistema de productividad. Su mayor fortaleza es la combinación de múltiples modelos en una sola plataforma con una arquitectura de confidencialidad verificable. Su mayor limitación, por ahora, es la falta de API y funciones de agente, que podrían ampliar su alcance para usuarios técnicos y desarrolladores. Si ya formas parte del ecosistema de ExpressVPN y priorizas la protección de la información sensible en tus chats de IA, Express AI vale la pena considerar como una herramienta de apoyo a la productividad, sin añadir complejidad innecesaria a tus flujos de trabajo.

from Latest from TechRadar https://ift.tt/HU0268c
via IFTTT IA
Lumo de Proton: privacidad en primer plano para el IA ayudante empresarial


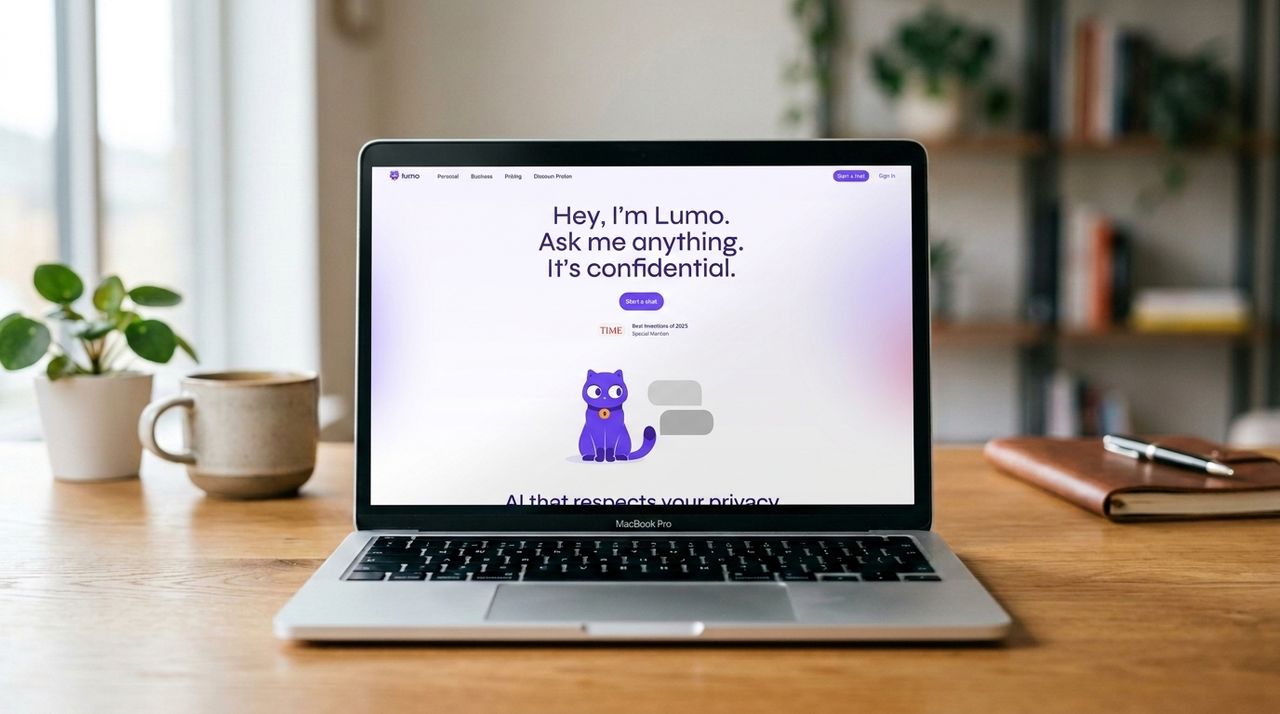
La mayoría de los asistentes de IA se sostienen sobre un acuerdo conocido: obtienes herramientas útiles y la empresa accede a tus datos. Lumo, lanzado por la empresa suiza de privacidad Proton en julio de 2025, rechaza ese trato por completo. Cada conversación está protegida por cifrado de acceso cero, no se guardan registros en el servidor y tus chats nunca se utilizan para entrenar los modelos subyacentes.

Lumo opera con un conjunto de modelos de lenguaje de código abierto, incluyendo Mistral Small 3, OLMO 2 32B y OpenHands 32B, con una capa de enrutamiento que dirige cada consulta al modelo más adecuado para la tarea. El código del cliente es abierto en GitHub y está disponible para revisión independiente. TIME reconoció a Lumo con una mención especial en Best Inventions 2025, destacando la arquitectura de privacidad más allá del rendimiento puro de IA.

TechRadar Pro ha evaluado software empresarial desde 2012. Para ampliar nuestra cobertura de IA, puedes explorar nuestra recopilación de herramientas de IA para 2026.

Qué es Lumo?

Lumo es un asistente de chat de IA de Proton AG, la empresa suiza detrás de Proton Mail y Proton VPN. Maneja tareas cotidianas: redactar textos, resumir documentos, responder preguntas, escribir y depurar código, y traducir entre idiomas. A diferencia de la mayoría de herramientas de IA, Lumo está diseñado para que ni Proton ni terceros puedan acceder a tu historial de conversaciones.

La plataforma está orientada a individuos y equipos que trabajan con información sensible y no pueden compartirla con grandes servicios tecnológicos. Abogados revisando contratos, periodistas protegiendo fuentes, profesionales de la salud discutiendo casos delicados y otros que exigen privacidad encuentran en Lumo un ajuste natural. Proton lanzó Lumo for Business en octubre de 2025 para atender despliegues en equipo con controles administrativos y gestión multiusuario.

Se está desarrollando una API de Lumo, según la hoja de ruta de primavera de 2026, que permitiría a plataformas de terceros incorporar chat de IA privado en sus flujos de trabajo. Por ahora, Lumo está disponible en la web en lumo.proton.me y a través de apps para iOS y Android.

Lumo: a grandes rasgos

Atributo

Notas

Modelos subyacentes

Enrutamiento entre Mistral Small 3, OLMO 2 32B, OpenHands 32B y Mistral Nemo según la tarea

Para qué es mejor

Usuarios preocupados por la privacidad, profesionales con flujos sensibles, suscriptores existentes de Proton

Funciones distintivas

Cifrado de acceso cero, Ghost Mode, política sin registros, búsqueda web respetuosa con la privacidad

Características de la UI

Interfaz de chat limpia con modo oscuro (v1.2+), disponible en web, iOS y Android

Coste de suscripción

Gratis (prompts limitados); Lumo Plus a $12.99/mes o $119.88/año ($9.99/mes efectivo)

Precio de API

La API está en desarrollo; no se ha publicado una estructura de precios a mediados de 2026

Compártelo si…

  • Manejas información confidencial. El cifrado de acceso cero implica que ni Proton puede leer tus chats guardados, lo que importa enormemente para trabajo legal, sanitario o periodístico que ninguna rival convencional puede igualar.
  • Ya eres suscriptor de Proton. Los miembros de Proton Unlimited obtienen acceso gratuito al nivel base de Lumo, lo que lo convierte en una adición natural a un flujo de trabajo cifrado existente.
  • Tu negocio necesita IA compatible con GDPR. Lumo se aloja en los servidores suizos de Proton, sujeto a la normativa europea de protección de datos, una ventaja real para equipos con obligaciones regulatorias.

No lo compres si…

  • Necesitas salidas de IA de frontera. Los modelos de código abierto de Lumo son adecuados para tareas cotidianas, pero quedan por debajo de GPT-4o o Claude en razonamiento complejo y escritura detallada de forma extensa.
  • El análisis de imágenes es parte de tu trabajo. A mediados de 2026, Lumo no admite cargas de imágenes. Si la comprensión visual es relevante para tu flujo, necesitarás otra herramienta.
  • Eres un usuario ligero y no quieres pagar. El límite de prompts en la versión gratuita genera fricción para usos más allá de consultas ocasionales, y Lumo Plus puede ser difícil de justificar si la privacidad no es prioritaria.

Mi experiencia con Lumo

No es necesario crear una cuenta para empezar: abre un chat como invitado en lumo.proton.me y comienza a escribir de inmediato. Hay un único campo de texto, un toggle de búsqueda web y un botón Ghost Mode para sesiones que quieras borrar al cerrar la ventana. La incorporación fue sorprendentemente fluida.

Para tareas rutinarias como resumir un PDF, redactar un correo breve o explicar un concepto técnico, Lumo mostró desempeño competente. Los tiempos de respuesta fueron razonables. En salidas más largas y estructuradas, el circuito a veces se deshilachaba y las respuestas analíticas se quedaban cortas frente a candidatos como Claude o ChatGPT Plus ante prompts idénticos.

Ghost Mode resulta práctico y está bien implementado. Una sola acción abre una sesión que no deja rastro en ningún servidor al cerrarse. Es una característica relevante para consultas sensibles y no he visto a competidores mainstream ofrecerlo con esa simplicidad.

Características de Lumo

Lumo cubre las herramientas estándar de un asistente de IA: análisis de documentos, escritura y depuración de código, traducción de textos, redacción de correos, lluvia de ideas y preguntas y respuestas en general. El sistema de enrutamiento dirige automáticamente consultas de codificación a OpenHands 32B, conversación general a modelos Mistral y tareas de razonamiento profundo a OLMO 2. No seleccionas manualmente el modelo; la lógica de enrutamiento de Proton decide qué maneja cada consulta.

La arquitectura de privacidad es el gran atractivo. El cifrado de acceso cero significa que las conversaciones guardadas solo pueden descifrarse en tu propio dispositivo con tu contraseña, y no se guardan registros en el servidor. Tus entradas nunca se utilizan para entrenar los modelos subyacentes, y la función de búsqueda opcional se canaliza a través de motores de búsqueda que respetan la privacidad en lugar de servicios con publicidad.

Lumo 1.1, lanzado en agosto de 2025, mejoró la pila de modelos y aportó mejoras significativas de velocidad. La versión 1.2 en octubre de 2025 añadió modo oscuro, correcciones de errores y personalización básica del chat. Lumo for Business siguió ese mismo mes con un costo de $11.99 por usuario al mes (facturación anual), añadiendo controles administrativos y manejo de datos conforme a GDPR, HIPAA y CCPA.

Las brechas de funcionalidad son reales. No hay entrada de imágenes, no hay modo de voz, no existe un mercado de plugins y no hay memoria para respuestas personalizadas entre sesiones. Para usos centrados en la privacidad, estas ausencias son manejables, pero los usuarios avanzados que comparan Lumo con la caja de herramientas de ChatGPT o con la gestión de contexto extendido de Claude notarán la diferencia.

Experiencia de usuario de Lumo

La interfaz es mínima, rápida y fácil de navegar. Iniciar una conversación toma un clic, el historial es buscable si inicias sesión y el panel de ajustes es claro. El modo oscuro llegó en la versión 1.2 y las apps móviles iOS y Android ofrecen una experiencia muy parecida a la web sin grandes saltos de funcionalidad entre plataformas.

Las opciones de personalización son escasas por diseño: sin ajustes de prompt del sistema, sin preferencias de modelo ancladas, sin configuración de memoria. La lógica de enrutamiento es completamente automática y, en gran medida, debes confiar en el juicio de Proton sobre qué modelo maneja cada tarea. Los usuarios que buscan control fino pueden sentirse frustrados; los que solo quieren escribir pueden empezar a trabajar rápidamente.

Soporte al cliente de Lumo

Proton ofrece soporte de Lumo a través de su centro de ayuda en proton.me/support/lumo, que incluye guías de inicio, documentación de funciones y artículos de resolución de problemas. Una plataforma de opinión de usuarios permite enviar y votar solicitudes de funciones. Los tickets de soporte basados en cuentas pueden gestionarse desde el panel de control.

No existe chat en vivo ni soporte telefónico en ningún nivel, lo que puede generar fricción para usuarios empresariales con problemas de tiempo. Es probable que Lumo for Business ofrezca acceso de soporte más directo, pero Proton no ha publicado SLA detallados para ese plan. En general, la documentación de autoservicio es clara, pero los compradores empresariales deben confirmar las opciones de escalamiento antes de comprometerse.

Lumo AI by ProtonVPN

(Image credit: ProtonVPN)

Precio de Lumo

  • Nivel gratuito: acceso como invitado (sin cuenta) con un número limitado de prompts por sesión. Una cuenta Proton gratuita desbloquea historial de chats cifrado y más mensajes diarios.
  • Lumo Plus: $12.99/mes o $119.88/año, con chats ilimitados, cargas de documentos, búsqueda de historial, tiempos de respuesta prioritarios y acceso a todos los modelos disponibles.
  • Lumo for Business: $11.99 por usuario al mes, facturado anualmente. Añade controles de equipo y manejo de datos preparado para cumplimiento de GDPR, HIPAA y CCPA.

El nivel gratuito funciona para uso esporádico, pero sus límites pueden generar fricción para usos más intensivos. A $12.99/mes, Lumo Plus se sitúa por debajo de ChatGPT Plus y Claude Pro en precio, y el valor depende de cuánto cueste la garantía de privacidad para ti. Si más que rendimiento buscas proteger tus datos y no te importa la procedencia de la salida, hay opciones más capaces a precios similares.

Los suscriptores de Proton Unlimited ($14.99/mes o $9.99/mes con facturación anual) obtienen acceso gratuito al nivel base de Lumo como parte de su plan. Lumo también se integra en Proton Workspace Premium, que incluye correo cifrado, VPN y almacenamiento en la nube.

Alternativas a Lumo que deberías considerar

  • ChatGPT Plus ($20/mes): la plataforma de OpenAI ofrece razonamiento más sólido, análisis de imágenes, modo de voz y un ecosistema de plugins. El trade-off de privacidad es significativo, pero en capacidad sigue siendo la referencia.
  • DuckAI (gratis): Duck.ai redirige consultas a múltiples modelos a través de proxies respetuosos con la privacidad y no requiere cuenta. La profundidad de cifrado es menor que el enfoque de acceso cero de Lumo, pero es una alternativa gratuita para uso casual.
  • Claude Pro ($20/mes): Claude maneja documentos largos y escritura matizada especialmente bien. No ofrece una arquitectura de cifrado comparable, pero la calidad de salida en tareas complejas está por encima de Lumo.

Cómo probé Lumo

  • Probé Lumo con resúmenes de documentos, redacción de correos, depuración de código y preguntas y respuestas en varias sesiones para evaluar calidad y consistencia de respuestas.
  • Verifiqué Ghost Mode, búsqueda web con y sin el toggle, cargas de documentos y la app iOS en iPhone y iPad, tanto en modo invitado como con cuenta.
  • Corroboré planes con la documentación oficial de soporte de Proton, anuncios de producto y otros materiales de la empresa.

Mi prueba abarcó la web y el cliente iOS durante varios días. Comparé la salida con Claude y ChatGPT Plus en prompts idénticos para situar a Lumo en el panorama actual. Las afirmaciones de privacidad se evaluaron frente a documentación pública, código abierto del cliente y análisis técnicos independientes.

from Latest from TechRadar https://ift.tt/pXtUKwr
via IFTTT IA

Evaluación de Modelos de Imagen AI: Meta vs. ChatGPT vs. Gemini en Propuestas Creativas y Realismo Visual


Meta ha lanzado un nuevo modelo de imágenes impulsado por IA, diseñado para competir con ChatGPT y Gemini de Google. Este artículo explora, con un enfoque profesional, qué tan bien cada sistema logra no solo generar imágenes estéticas, sino también entender la intención y el contexto de prompts complejos. A través de una serie de pruebas creativas y de realismo, analizamos cómo cada modelo maneja diseño de producto, fotografía de naturaleza, invitaciones sociales y narrativa visual secuencial, evaluando tanto la calidad técnica como la fidelidad conceptual.

Pruebas y lógica de evaluación
– Producto publicitario: diseñar un cartel pulido para una bebida ficticia llamada Moon Orchard, con texto exacto en la etiqueta y un titular específico. Se evalúa la precisión tipográfica y la coherencia entre imagen y copy.
– Fotografía de fauna: una marta roja caminando en un bosque nevado al amanecer, evaluando morfología, textura de pelaje, iluminación y atmósfera.
– Invitación a fiesta en jardín: un post cuadrado para Instagram con ambientación cálida, luces de hadas y una mesa de madera, con texto legible y distribución realista.
– Tira cómica de robot cocinero: cuatro paneles con consistencia de personaje a lo largo de la historia, evaluando continuidad y ritmo narrativo.
– Noir cartoon: combinación de estilo noir con estética de dibujos animados en una cocina suburban de los años 40, en blanco y negro, para medir la fusión de géneros y humor.

Conclusiones clave
– Todas las plataformas generan resultados estilísticamente atractivos, pero difieren en su intuición creativa y en la forma de interpretar prompts.
– ChatGPT tiende a entregar la pieza más coherente con la intención expresada en el prompt, destacando por su capacidad de integración entre palabras y diseño.
– Gemini suele ofrecer una composición de revista o cartel con una distribución clara, aunque a veces añade elementos superfluos que desvían la atención del mensaje principal.
– Meta AI tiende a realizar apuestas creativas más marcadas, con toques de humor y una presentación más premium, pero a veces acentúa detalles visuales a expensas de la textualidad o del encaje preciso del copy.

Conclusión operativa
La mejor elección depende del objetivo del usuario: si se busca alineación exacta entre el texto y la imagen y coherencia de concepto, ChatGPT se distingue; si se prioriza una estética editorial pulida y una narrativa visual fuerte, Gemini puede ser la opción preferente; si se valoran giros creativos y presentaciones con alto potencial comercial, Meta ofrece resultados particularmente llamativos. En todos los casos, los tres modelos demuestran que la generación de imágenes por IA ha evolucionado hacia una comprensión más rica de la intención y del estilo deseado, abriendo posibilidades para creadores y marcas por igual.

from Latest from TechRadar https://ift.tt/lJ4sqjO
via IFTTT IA

Consolidación y confianza: moviendo el control de seguridad al centro de la experiencia de usuario en el navegador


En un mundo donde cada brecha de seguridad suele cubrirse con una nueva herramienta, las organizaciones tienden a construir una pila cada vez más compleja. La consecuencia es una seguridad fragmentada, costosa de licenciar y difícil de gestionar, que dificulta la experiencia del usuario y complica la gobernanza ante la junta directiva. Este enfoque fragmentado produce controles superpuestos, problemas de integración y una experiencia de usuario con fricción constante, e incluso puede dirigir los esfuerzos de seguridad en una dirección inconsistente.

Para muchos trabajadores del conocimiento, el navegador es el inicio y el final de la jornada laboral. Desde CRM hasta correo electrónico, cada vez más aplicaciones empresariales se entregan mejor a través de una pestaña de navegador. La adopción de herramientas de IA generativa ha acelerado este uso, convirtiendo al navegador en el propio espacio de trabajo. Sin embargo, la arquitectura de seguridad no ha seguido el ritmo de este cambio, ya que los controles tradicionales fueron diseñados para redes corporativas y dispositivos gestionados, no para un entorno donde la mayor parte de la actividad ocurre dentro de la propia sesión del navegador.

La consecuencia es un punto ciego significativo: los controles de red y de nivel de dispositivo pueden determinar si un usuario puede acceder a una aplicación, pero no ven qué sucede dentro de ella. Cuando el flujo de trabajo se produce dentro del navegador, información crítica sobre interacción y manejo de datos puede quedar fuera del alcance de las políticas existentes. Por ejemplo, es posible que nunca se detecte si se accede a datos sensibles, how se manejan o si se copian a correo personal o se pegan en herramientas de IA públicas.

El navegador como superficie de ataque principal

La mayoría de los trabajadores utiliza navegadores de consumo diseñados para una audiencia amplia. Al no estar optimizados para las exigencias empresariales, se convierten en objetivos atractivos para actores maliciosos, quienes pueden obtener credenciales dentro de la sesión del navegador o atacar cookies y contraseñas almacenadas localmente. La exfiltración de datos ya no depende exclusivamente de una brecha de red, sino de acciones rutinarias como copiar un registro de cliente, descargar un informe o compartir un archivo con un destino indebido. Además, la IA genera un nivel de riesgo adicional, ya que los usuarios pueden pegar datos sensibles en plataformas de IA generativa sin comprender dónde van ni cómo se retienen. Las herramientas agentic que ejecutan acciones en sistemas empresariales en nombre de un usuario introducen riesgos difíciles de ver para las defensas tradicionales, y dejan trazas mínimas en el perímetro de red.

Las herramientas de seguridad heredadas no están diseñadas para ver dentro de una sesión de navegador. Suelen inspeccionar tráfico y finales, o alertar retroactivamente, por lo que la acción ya puede haber ocurrido cuando se aplica un control. En este escenario, la centralización de la seguridad debe moverse hacia el lugar donde se toman las decisiones: dentro del navegador y durante la acción.

La necesidad de trasladar el control a donde se toman las decisiones

Con la actividad empresarial cada vez más concentrada en el navegador, la capa de aplicación de las políticas debe hacer lo mismo. El enfoque debe evolucionar de gestionar el acceso a gestionar el comportamiento. Aunque seguir determinando si un usuario está permitido a acceder a una aplicación sigue importando, lo más crucial es lo que ocurre dentro de la aplicación una vez concedido el acceso. Un archivo descargado a un dispositivo personal o un registro de cliente pegado en un correo privado son momentos en los que el movimiento de datos puede convertirse en una pérdida de datos, y la mayoría de las pilas de seguridad no pueden ver estos momentos.

Incorporar seguridad y protección de datos directamente en el navegador hace que estos momentos sean gobernables, ya que la política se aplica en el punto de acción, en tiempo real, sin interrumpir el flujo de trabajo. Un usuario que maneja datos sensibles puede moverse libremente entre aplicaciones autorizadas, mientras los controles evitan que esa información llegue a un destino no autorizado. Aquí también se realiza la visión de confianza cero de manera continua: la evaluación de identidad y estado del dispositivo ya no se limita al inicio de sesión, sino que se ajusta de forma constante a medida que cambian las circunstancias, sin interrumpir la experiencia del usuario. La aplicación de las políticas acompaña al trabajo, en lugar de esperar al borde de la red.

La consolidación como único camino hacia adelante

Gestionar el riesgo del navegador no se resuelve simplemente añadiendo más herramientas a la pila. Muchas empresas se encuentran con una pila ya cargada de capas que fueron diseñadas para compensar navegadores de consumo. Se utiliza una interfaz de escritorio virtual (VDI) para controlar el acceso a las aplicaciones, y las VPN mantienen túneles de red para herramientas en la nube que requieren métodos de conectividad y protección muy diferentes. Las soluciones de prevención de pérdida de datos (DLP) buscan interceptar el movimiento de datos después de que ocurre, y las capas de CASB median el acceso a la nube que el navegador ya facilita. Aunque son respuestas razonables ante una brecha, juntas constituyen una infraestructura difícil de gestionar y que no estaba diseñada para funcionar como un todo. Estos sistemas fuerzan el 100% de los datos a atravesar puntos de estrangulamiento (proxies SASE) para inspección, lo que genera cuellos de botella de rendimiento y una experiencia de usuario deficiente. A medida que los cifrados avanzan hacia estándares con criptografía post-cuántica, una parte considerable de este tráfico queda ciega ante estas arquitecturas de inspección y ruptura.

Cerrar estas capas desde el interior, haciendo del navegador el punto de gobernanza principal, elimina la necesidad de muchas de estas soluciones. La pila ha crecido precisamente al intentar resolver el problema equivocado; resolver el correcto empieza por el propio navegador.

Este artículo forma parte de las perspectivas de TechRadar Pro, una iniciativa para presentar las mentes más brillantes de la industria tecnológica hoy en día.

from Latest from TechRadar https://ift.tt/QVyLuEU
via IFTTT IA

Guía de ventiladores en stock para combatir la ola de calor: opciones que puedes comprar esta semana


En medio de una ola de calor, encontrar un ventilador disponible para entrega rápida puede ser un verdadero alivio. A continuación, presento una selección de opciones de grandes marcas que, según mi revisión, aún están en stock para entrega esta semana. Estas recomendaciones combinan rendimiento, versatilidad y facilidad de uso para ayudarte a mantener la casa fresca sin complicaciones.

1) Shark ChillPill 3-In-1 Personal Fan Travel Bundle
– Descripción: Un ventilador portátil 3 en 1 que funciona como ventilador personal y aporta opciones de enfriamiento para viajar o para usar en espacios reducidos. Ideal para transporte público o para uso inmediato en interiores. Disponibilidad en colores como plata y gris.
– Por qué podría interesarte: Su formato compacto y funciones multipropósito lo convierten en una solución rápida para el calor de hoy y el uso puntual en otras estaciones.

2) Dimplex FlexBlade Multi-Directional Bladeless Fan
– Descripción: Ventilador sin aspas de dirección múltiple que ofrece flujo de aire amplio y estable, diseñado para enfriar de forma constante sin ruidos excesivos.
– Por qué podría interesarte: Equilibrio entre rendimiento y diseño, especialmente si buscas una silueta más minimalista en el salón o dormitorio.

3) Meaco Sefte 6″ Desk Fan
– Descripción: Ventilador de escritorio de 6 pulgadas, compacto pero eficaz para corrientes de aire focalizadas en el puesto de trabajo o sobre la mesa de noche.
– Por qué podría interesarte: Ideal para espacios de trabajo o estudio donde necesitas aire más directo sin ocupar mucho espacio.

4) Dyson Pure Hot+Cool HP00 Purifying Fan Heater
– Descripción: Ventilador purificador que también funciona como calefactor, ofreciendo versatilidad para todo el año. Aunque el enfoque principal es la purificación y el control de temperatura, puede servir como solución de confort en inviernos.
– Por qué podría interesarte: Si buscas un equipo que cubra tanto verano como invierno, este modelo es una inversión a largo plazo.

5) Dimplex DuoCool Smart Wi-Fi Cordless 2-in-1 Fan
– Descripción: Ventilador 2 en 1 con conectividad Wi‑Fi y funcionamiento sin cables, lo que facilita la colocación en diferentes habitaciones sin depender de enchufes cercanos.
– Por qué podría interesarte: La conectividad y la movilidad lo hacen práctico para hogares con varias estancias y uso flexible.

6) Shifts notables de tiendas y ubicaciones
– Meaco Sefte 6″ Desk Fan (John Lewis): si te interesa un ventilador de escritorio de Meaco y tu tienda habitual ha agotado su stock directo, esta opción de distribución puede estar disponible para entrega rápida en algunas tiendas o plataforma de venta asociada.
– Ofertas y disponibilidad: la tendencia es que estas unidades vuelen rápido; si ves alguna pieza disponible, conviene actuar con decisión para asegurarte la entrega esta semana.

Consejos para elegir y comprar con rapidez
– Verifica la disponibilidad de entrega esta semana en tu zona antes de agregar al carrito.
– Considera el tamaño de la habitación y la ubicación de enchufes para seleccionar entre un modelo de escritorio, portátil o de uso en el suelo.
– Piensa en funciones adicionales (purificación, humidificación suave, conectividad Wi-Fi) si buscas una solución más versátil para distintas estaciones.
– Si el presupuesto es clave, prioriza modelos con mayor rendimiento de flujo de aire por vatio para obtener más enfriamiento por cada unidad de consumo.

Conclusión
– Si necesitas una solución rápida para la ola de calor, estas opciones de grandes marcas ofrecen disponibilidad actual para entrega esta semana y son lo suficientemente versátiles para adaptarse a diferentes espacios y usos. Actúa con rapidez para asegurar la pieza que mejor se adapte a tus necesidades y a tu hogar antes de que el stock se agote.

from Latest from TechRadar https://ift.tt/F3GZ1mE
via IFTTT IA

La impresora como eje estratégico de ciberseguridad en las pymes


Para muchas pequeñas y medianas empresas, las conversaciones sobre ciberseguridad suelen centrarse en los endpoints: portátiles, servidores y plataformas en la nube. Sin embargo, existe una categoría de dispositivos que permanece fuera de ese foco: la impresora. A pesar de estar profundamente integrada en la operación diaria y de manejar información altamente sensible, la infraestructura de impresión sigue siendo ampliamente pasada por alto. Esta falta de escrutinio es parte de un desafío más amplio. Investigaciones recientes muestran que el 73% de las pymes del Reino Unido temen problemas de privacidad de datos en sus procesos actuales de gestión documental, subrayando una preocupación generalizada sobre cómo se maneja la información sensible en flujos de trabajo tanto digitales como físicos. Aun así, el 55% de las pymes británicas considera a las impresoras una prioridad baja dentro de su estrategia de ciberseguridad. Esta desconexión preocupante entre los datos críticos que manejan las impresoras y su baja priorización de seguridad crea una vulnerabilidad que los atacantes pueden explotar para acceder a flujos de trabajo sensibles, interceptar documentos o moverse lateralmente dentro de una red.

Un punto ciego creciente en entornos de trabajo híbridos
Como sabemos, el trabajo ya no se ubica únicamente en la oficina. Ocurre a través de redes domésticas, dispositivos personales y espacios compartidos, entornos que las pymes luchan por monitorear o controlar. Hoy, los flujos de impresión y escaneo manejan datos sensibles, desde nóminas y contratos hasta registros de clientes. Sin visibilidad de quién imprime qué y dónde, las organizaciones no pueden proteger esa información sensible. Tampoco hace falta mucho: un escaneo mal dirigido o un trabajo de impresión dejado en una bandeja puede exponer información confidencial, a menudo sin señales evidentes de que algo anda mal. Según Quocirca, el 74% de las pymes ha experimentado un incidente de pérdida de datos relacionado con la impresión en el último año. Un 33% adicional indica que los documentos impresos en impresoras propiedad de los empleados son ahora un factor principal en la pérdida de datos.

Además, factores conductuales agravan el problema. Investigaciones señalan que el 47% de las pymes del Reino Unido cree que los empleados intentan eludir las directrices de seguridad de la impresión. Al mismo tiempo, el 63% asume que sus impresoras son seguras porque se encuentran detrás de un firewall, y la mitad no las considera una amenaza de seguridad en absoluto. En conjunto, estas tendencias apuntan a una brecha de seguridad clara: mientras los flujos de impresión manejan datos cada vez más sensibles en entornos distribuidos, no se securizan, monitorizan ni gobiernan al mismo nivel que otros endpoints.

Riesgos reales en hardware desactualizado
Casi tres cuartas partes (73%) de las pymes del Reino Unido frecuentemente se preocupan por el riesgo que representa su hardware desactualizado. Impresoras más antiguas con firmware sin parchear y credenciales por defecto procesan y almacenan datos sensibles sin ser gestionadas. Una impresora comprometida puede servir como punto de entrada a sistemas empresariales más amplios. Si los portátiles y los servidores requieren monitoreo activo, las impresoras también lo requieren. Las preocupaciones no se limitan al hardware; abarcan exposiciones de ciberseguridad vinculadas a impresoras conectadas, vulnerabilidades introducidas mientras los documentos escaneados se mueven a través de la nube y el riesgo de acceso no autorizado a las colas de impresión. Junto a esto, existen problemas visibles y cotidianos, como documentos confidenciales dejados desatendidos y la dificultad de rastrear la información cuando existe en formato físico. Estos riesgos pueden gestionarse, pero solo si las pymes tratan la impresión y el escaneo como parte del perímetro de seguridad. Sin ello, la resiliencia en flujos de trabajo híbridos se convierte en conjeturas. El futuro del trabajo no solo se trata de la nube y la IA; también se trata de asegurar los procesos documentales diarios que movilizan datos sensibles entre entornos físicos y digitales.

Construir control a través de visibilidad e impresión más inteligente
A pesar de la baja priorización, casi seis de cada diez pymes (63%) en el Reino Unido reconocen que la seguridad de la impresión requiere mejoras. Para asegurar el futuro del trabajo, las organizaciones necesitan bases de hardware seguras y protecciones que acompañen las amenazas en evolución. La impresión inteligente se apoya en estas bases de hardware seguras al incorporar visibilidad, aplicación de políticas y trazabilidad directamente en los flujos de impresión y escaneo. De las pymes británicas que han adoptado la impresión inteligente, el 89% afirma que proporciona una visibilidad más clara de la actividad de impresión y escaneo entre usuarios y ubicaciones, el 86% afirma que les ayuda a cumplir con normas de cumplimiento y seguridad, y el 85% dice que mejora la aplicación de reglas y restricciones.

Repensar el rol de la impresión en la ciberseguridad
A medida que profundizamos en el futuro del trabajo, las impresoras deben integrarse a la estrategia de seguridad más amplia. Una brecha de datos originada en una impresora puede ser tan perjudicial como una originada en un dispositivo o red comprometidos, con potenciales pérdidas financieras significativas, sanciones regulatorias y daño reputacional. Las impresoras no son solo equipos de oficina; forman parte de la infraestructura digital que sostiene el trabajo moderno. A medida que los flujos de impresión y escaneo se vuelven más digitales y conectados a la nube, las impresoras merecen la misma atención de seguridad que cualquier otro endpoint. En la práctica, eso significa que las pymes necesitan tres cosas: una base de hardware segura como cimiento, una seguridad que se mantenga al ritmo de las nuevas amenazas y la visibilidad y el control para mantener la resiliencia a escala. Incorporar las impresoras en la estrategia de seguridad es un paso práctico para proteger datos sensibles en un mundo donde el trabajo y el riesgo están distribuidos.

Notas finales
Este enfoque no es solo una mejora técnica; representa una evolución cultural en la gestión de la seguridad, donde cada dispositivo, incluso el que imprime, es parte de la defensa conjunta. Al priorizar la seguridad de la impresión, las pymes pueden reducir puntos ciegos, reforzar controles y garantizar que la información sensible circule de forma segura desde la creación hasta la archivación, ya sea en papel o en la nube.

Texto generado para apoyar a profesionales y tomadores de decisiones que buscan fortalecer la ciberseguridad en entornos híbridos, destacando la importancia de un enfoque integral que incluya la impresión como parte central de la protección de datos.

from Latest from TechRadar https://ift.tt/6xorU7T
via IFTTT IA

Duck.ai: Privacidad sin registro y acceso a modelos de vanguardia


Duck.ai se posiciona como una plataforma de chat con IA que permite conversar con modelos avanzados como GPT-5 o Claude Opus sin necesidad de crear una cuenta. Lanzada por DuckDuckGo a principios de 2025, la oferta se integra en el ecosistema de búsqueda y navegación de la compañía, accesible en duck.ai, a través del navegador de DuckDuckGo o mediante extensiones de escritorio. Dos rasgos distinguen a esta herramienta frente a soluciones similares: todo el flujo de conversación pasa por un proxy de anonimización de DuckDuckGo y los proveedores de IA tienen restricciones contractuales que impiden usar estas conversaciones para entrenamiento. Este compromiso es especialmente relevante frente a plataformas de acceso directo a modelos que no ofrecen garantías equivalentes.

En TechRadar Pro hemos evaluado software empresarial desde 2012. Nuestra cobertura de IA incluye una recopilación de herramientas de IA y una guía de compra centrada en el desarrollo de código para 2026, además de reseñas y noticias sobre plataformas. A continuación se ofrece una visión completa de Duck.ai y sus posibles usos, beneficios y limitaciones para profesionales y equipos que valoran la privacidad y la eficiencia.

Qué es Duck.ai? Duck.ai es el servicio de chat de DuckDuckGo diseñado para permitir la interacción con modelos de IA de alto rendimiento sin necesidad de registro ni exposición de datos personales. Está disponible en duck.ai, a través de las extensiones de DuckDuckGo y dentro de la app para iOS y Android. El servicio enruta todas las conversaciones mediante un proxy de privacidad, anonimizando las solicitudes antes de llegar al proveedor de IA. DuckDuckGo también exige a los proveedores límites contractuales estrictos sobre el uso de datos, lo que implica que las conversaciones no se almacenan en los servidores de DuckDuckGo y no pueden usarse para entrenar modelos por parte de los proveedores o de la propia Duck.

Funciona para tareas habituales de IA: redacción de correos, resumen de documentos, respuestas a preguntas, escritura de código y chat general. Es una opción especialmente atractiva para profesionales concienciados con la privacidad, freelancers y cualquiera que quiera acceso de vanguardia a IA sin una suscripción recurrente.

Duck.ai: visión general
– Modelo subyacente: variedad de opciones que, según el nivel de suscripción, incluyen GPT-4o mini, GPT-5 mini, Claude 4.5 Haiku, Claude Sonnet 4.6, Claude Opus 4.7 y otros, con disponibilidad de versiones Pro y Plus.
– Ideal para: usuarios preocupados por la privacidad; tareas generales de IA; acceso sin registro.
– Funciones distintivas: enrutamiento a través de un proxy de privacidad; acceso sin inicio de sesión; conmutación entre modelos; chat por voz.
– Interfaz de usuario: interfaz de chat mínima; barra lateral izquierda para cambiar de modelo; historial de chat almacenado localmente en el dispositivo.
– Costes de suscripción: gratuito; Plus: 9,99 USD/mes o 99,99 USD/año; Pro: 19,99 USD/mes o 199,99 USD/año.
– Precio de API: sin API pública; producto de consumo solamente.

Cuándo comprar Duck.ai
– Si quieres chatear con IA sin necesidad de crear una cuenta.
– Si la privacidad es determinante para tu flujo de trabajo: Duck.ai anonimiza cada conversación y restringe el uso de datos por parte de los proveedores, superando en protección de datos a una cuenta directa con OpenAI o Anthropic.
– Si valoras el multi-modelo: el plan Plus combina GPT-5.4 y Claude Sonnet 4.6 con VPN e protección de identidad, lo que resulta competitivo.

Cuándo no comprar Duck.ai
– Si necesitas una API para desarrollos o automatizaciones: Duck.ai no ofrece API; para construir productos o integraciones conviene ir directamente a OpenAI o Anthropic.
– Si ya dispones de una VPN: los planes de pago incluyen VPN y servicios de identidad; no hay una opción solo IA.
– Si dependes de límites predecibles: DuckDuckGo no publica límites diarios exactos, lo que dificulta planificar trabajo de alto volumen o con requisitos temporales.

Mi experiencia con Duck.ai
Probé Duck.ai en los niveles gratuito y Pro durante varias semanas. En el nivel gratuito, la experiencia es limpia y rápida, sin registro y con seis modelos listos para usar. Cambiar entre GPT-4o mini y Claude 4.5 Haiku se hace con un clic y ambos manejan consultas de investigación y tareas de redacción sin problemas. El nivel Pro añade Claude Opus 4.7 con razonamiento extendido. En tareas complejas, Opus 4.7 ofrece respuestas más estructuradas y bien razonadas. Para escritos cotidianos o consultas rápidas, el nivel gratuito es suficiente; el Pro brilla en trabajos especializados y que requieren múltiples pasos. Una frustración constante fue la opacidad de los límites de uso: DuckDuckGo mantiene los límites vagos para evitar abusos, y es posible que usuarios de alto volumen alcancen techos sin aviso claro.

Duck.ai: características
– Característica definitoria: el proxy de privacidad; cada mensaje pasa por DuckDuckGo antes de llegar al proveedor de IA. DuckDuckGo exige a los proveedores límites contractuales de uso de datos, lo cual es crucial cuando se manejan datos sensibles como decisiones financieras, cuestiones de salud o asuntos confidenciales.
– Repertorio de modelos en la versión gratuita: GPT-4o mini, Claude 4.5 Haiku, GPT-5 mini, gpt-oss-120b, Llama 4 Scout y Mistral Small 3 24B, con opciones más potentes en planes de pago.
– Suscripciones de pago: Plus añade GPT-5.4 y Claude Sonnet 4.6 junto con VPN y protección de identidad; Pro añade Claude Opus 4.7 y razonamiento extendido, con límites de uso superiores.
– Chat por voz: lanzado en febrero de 2026, permite hablar con un modelo de IA a través de una conexión cifrada. El audio no se almacena tras la sesión y actualmente el proveedor de modelos es OpenAI, limitando la variedad de modelos para voz.
– Cargas de archivos: aún no disponibles; para analizar PDFs o documentos hay que pegar contenido manualmente. DuckDuckGo ha indicado que la carga de archivos está en la hoja de ruta.

Duck.ai: experiencia de usuario
La interfaz es deliberadamente mínima: no hay paneles de control, configuraciones complejas ni procesos de onboarding. La historia de chat se almacena localmente en el dispositivo. Se cambia de modelo haciendo clic en el nombre del modelo en la parte superior de la conversación. Los usuarios nuevos pueden iniciar un chat en segundos. Las funciones de IA son opcionales; DuckDuckGo permite ocultar los botones de Duck.ai y superposiciones de IA en la configuración de búsqueda, una muestra de su enfoque centrado en la privacidad. Deshabilitar IA sin perder otras funciones es un rasgo que muchos servicios no ofrecen.

Soporte al cliente
DuckDuckGo mantiene documentación detallada de ayuda con políticas de privacidad, disponibilidad de modelos, límites de uso y gestión de suscripciones. En general, la documentación es clara y responde a la mayoría de preguntas sin necesidad de contacto directo. No hay chat en vivo ni teléfono de soporte. Para cuestiones de suscripción o facturación, se puede recurrir al menú de configuración de suscripción, pero los tiempos de respuesta no se publicitan. Las empresas que dependan del plan Pro para trabajos críticos deberían considerar este aspecto en su evaluación.

Precio y modelos
– Gratuito: seis modelos, sin registro, con límites de uso diarios no especificados.
– Plus: 9,99 USD/mes o 99,99 USD/año; añade GPT-4o, GPT-5.4, Claude Sonnet 4.6 y Llama 4 Maverick, más VPN, Eliminación de información personal y Recuperación de identidad.
– Pro: 19,99 USD/mes o 199,99 USD/año; añade Claude Opus 4.7, razonamiento extendido y el doble de límites de uso frente a Plus.

Conclusiones
El nivel gratuito de Duck.ai es de los mejores ofrecidos sin inicio de sesión disponibles en la actualidad, al permitir acceso a GPT-5 mini y Claude 4.5 Haiku con protecciones de privacidad reales y sin coste. El plan Plus ofrece una relación precio-beneficio atractiva frente a alternativas como ChatGPT Plus o Claude Pro, al combinar modelos de vanguardia con un conjunto de servicios de seguridad. El plan Pro es más recomendable para usuarios avanzados que requieren análisis complejos y múltiples pasos. Sin embargo, no existe una opción de IA aislada, por lo que si ya se paga por VPN u otros servicios, podría resultar redundante. En cuanto a limitaciones, la ausencia de una API y la falta de claridad en límites de uso diarios pueden ser factores decisivos para empresas con necesidades de automatización o de alta cadencia. Duck.ai continúa evolucionando con funciones como el chat por voz y la posibilidad de cargar documentos en el futuro, lo que podría ampliar aún más su caso de uso profesional.

from Latest from TechRadar https://ift.tt/ZreipUW
via IFTTT IA

Lidl’s Cyberattack Incident: What It Means for Customers and Data Security


Recent reports indicate that Lidl identified a cyberattack impacting data stored by an IT service provider connected to Lidl Online Shop. The incident led to the exposure of some personal information, including full names, phone numbers, email addresses, dates of birth, and customer numbers. Importantly, passwords, billing and delivery addresses, bank details, and other payment information were not reportedly compromised, and customer accounts remained unaffected.

Lidl has advised customers to stay vigilant against phishing and identity fraud, acknowledging that stolen data could be used to craft more convincing targeted emails. While there is no concrete evidence of misuse at this time, the company emphasizes precautionary measures to reduce risk and protect customers against potential fraud.

The company described its response as prompt, stating that it immediately resumed security controls and took necessary steps to restore the affected systems. A formal report was filed with the relevant authorities, and IT forensic experts were engaged to investigate the breach. Local data protection authorities in the Netherlands, Belgium, and Germany were notified as part of the incident response. Lidl operates approximately 12,900 stores across 32 countries in Europe and the United States.

This event underscores the broader challenges that large retail organizations face when relying on third-party IT service providers. It serves as a reminder for consumers to monitor financial statements and correspondence, verify unexpected communications, and exercise heightened skepticism regarding unsolicited messages that request sensitive information.

For organizations, the incident reinforces the importance of robust third-party risk management, rapid containment, clear communication with customers, and proactive collaboration with law enforcement and forensic experts to investigate and mitigate data exposure.

from Latest from TechRadar https://ift.tt/KWFvl9u
via IFTTT IA

Cómo reducir el costo del AI en producción: lecciones de la capa de datos


Los costos de infraestructura para IA en las empresas Global 1000 se proyectan que serán un 30% más altos que los presupuestos actuales para 2027, según IDC. Esa brecha revela una desalineación entre cómo se comportan las cargas de trabajo de IA en producción y cómo la TI empresarial ha planificado históricamente la capacidad. Este patrón se repite en múltiples industrias: un piloto valida un modelo en un conjunto de datos controlado y se crean presupuestos en torno a esa economía. Pero cuando el sistema pasa a producción, la factura suele superar con creces lo que se modeló originalmente.

La tendencia natural es señalar el tamaño del modelo o el costo de los tokens, pero ese no es el principal culpable. El gasto reside en la capa de datos, impulsado por la frecuencia de lectura, cuántos servicios se tocan y cuán continuamente operan esas acciones.

Qué no muestran los pilotos
Un piloto se ejecuta contra un conjunto de datos estrecho, con unos pocos usuarios concurrentes y una cadencia de solicitud-respuesta familiar para una aplicación web. La producción es muy distinta.

Pensemos en un agente de soporte al cliente de IA en producción. Una sola solicitud de usuario puede activar búsquedas simultáneas a través de actividad de sesión, registros CRM, sistemas de inventario, manuales recuperados y otras fuentes, antes de que el modelo genere una respuesta. Todo esto ocurre bajo presupuestos de latencia de sub-100 ms, y la búsqueda más lenta regula el resto. El problema operativo se convierte en la latencia en cola (tail latency) entre muchas búsquedas pequeñas en paralelo.

Luego se añaden flujos de trabajo agentivos. Una solicitud de usuario se descompone en un plan y luego en una serie de pasos que emiten sus propias búsquedas, escriben estados intermedios y los leen de nuevo. Lo que empieza como una inferencia se expande a decenas o cientos de accesos a datos, con la sesión y el estado de la memoria mantenidos a lo largo de todo el recorrido. El perfil de costos que emerge no se parece en nada a lo que se tasó en el piloto.

De dónde sale el 30% de sobrecosto
La sobrecarga proviene de una serie de decisiones defensivas tomadas ante la incertidumbre. Cuando los equipos no pueden ver cómo fluyen los datos en una única solicitud, sobreprovisionan para absorber picos. Cuando no pueden predecir el comportamiento de caché bajo contexto cambiante, duplican datos entre sistemas para reducir riesgos de dependencia.

Si un servicio downstream se ralentiza, se añade otro servicio para aislarlo. Cada decisión tiene sentido de forma local. En conjunto, se genera un sistema que cuesta un 30% más que la carga de trabajo real, y eso antes de añadir cualquier nuevo caso de uso.

Los problemas subyacentes suelen ser los mismos. El fan-out por solicitud no se mide de extremo a extremo. El contexto se fragmenta a través de tiendas de características, sesiones, sistemas de perfiles de usuarios, índices vectoriales y APIs de terceros. Las cachés KV y el reuso de prefijos quedan fuera de la cuenta porque la capa de inferencia no puede mantener o compartir estado entre llamadas. Las decisiones de replicación y jerarquía se toman por sistema, no por patrón de acceso. Todo ello no aparece en un piloto: aparece en la factura de producción.

Qué debe entregar la capa de datos de IA
La IA en producción es un sistema distribuido y continuo cuyo camino más activo es la construcción del contexto: muchos lectos pequeños por solicitud bajo presupuestos de baja latencia, combinados con escrituras que deben mantener representaciones múltiples del mismo ente consistentes. Estas arquitecturas requieren dos cosas al mismo tiempo: lecturas de baja latencia previsibles bajo alta concurrencia y escrituras consistentes a lo largo de la ruta de datos. La infraestructura subyacente tiene que dimensionarse y formarse en consecuencia.

Decisiones arquitectónicas que empujan el resultado
– Emparejar la capa de datos con el patrón de acceso: estados de sesión, memoria de agentes, búsquedas de características, contexto recuperado y reutilización de caché KV presentan diferentes patrones de lectura, requisitos de frescura y necesidades de durabilidad. Tomarlas como capas de datos diferentes o colocarlas sobre la misma base de datos sin considerar estos patrones es una fuente común de sobrecosto. La tienda de sesión y el sistema de registro difieren en demandas de acceso de la misma capa de datos.
– Diseñar para fan-out y latencia tail predecible: el rendimiento (throughput) no debe ser la métrica principal para una capa de datos de IA. La métrica adecuada es la predictibilidad de múltiples lecturas pequeñas disparadas por una única solicitud. Un lote de búsquedas en paralelo solo es tan rápido como su miembro más lento; una búsqueda lenta detiene toda la construcción del contexto.
– Tratar la consistencia de escrituras como un requisito de corrección: cuando las actualizaciones entre perfiles de usuario, embeddings, vectores de características y estado de sesión no están sincronizadas, las lecturas de contexto subsequentemente obtienen versiones mezcladas y el modelo genera salidas basadas en datos contradictorios. Esto provoca alucinaciones que no tienen que ver con muestreo o probabilidad de modelo, y no se corrigen con prompts más grandes.
– Reutilización de datos en tiempo de inferencia como infraestructura: reutilizar caché KV, compartir prefijos y persistencia de memoria de agente deben ser consideraciones de infraestructura de primer nivel. Las equipos que lo abordan temprano pueden ejecutar las mismas cargas de trabajo con menor utilización de GPU que quienes no lo hacen. Este es el mayor punto de apalancamiento que no suele aparecer en la mayoría de los modelos de costos de IA.

Cómo empezar
El paso más útil es trazar una única solicitud de producción de extremo a extremo: contar las lecturas, registrar las fuentes y medir las latencias en cola. Este ejercicio revela más que una revisión arquitectónica. Una vez que los equipos ven cómo se mueven los datos en una interacción, pueden categorizar los accesos a datos por capa y verificar que cada uno funcione sobre infraestructuras adecuadas a su patrón.

A partir de ahí, la pregunta siguiente es qué se está recomputando y podría reutilizarse, especialmente entre llamadas de inferencia y pasos agentivos. El fan-out por interacción debería convertirse en una métrica que se observe tan de cerca como la latencia p99, porque a escala impulsa el costo con la misma claridad.

El costo de IA en producción es una disciplina de diseño. Los equipos que abordan este tema temprano tienen mucho más control sobre el rendimiento y el gasto que los que esperan a que la factura obligue a actuar. En muchos casos, la brecha del 30% es el costo de aprender estas lecciones demasiado tarde.

Notas finales
– Este análisis subraya la importancia de tratar la capa de datos como la clave para gestionar costos y rendimiento en IA en producción.
– Las decisiones de diseño deben centrarse en patrones de acceso y en la coherencia de datos a lo largo de todo el flujo de trabajo, no solo en el rendimiento aislado de un modelo.
– Trazar y medir de extremo a extremo una interacción real se revela como la herramienta más poderosa para evitar sorpresas en la factura y para lograr una IA más eficiente y confiable en producción.

Este artículo forma parte de TechRadar Pro Perspectives, que reúne a las mentes más brillantes de la industria tecnológica para compartir ideas y experiencias relevantes.

from Latest from TechRadar https://ift.tt/Xl8wRyW
via IFTTT IA

DeepSeek y el desafío de la IA: rendimiento, costos y consideraciones estratégicas en 2026


DeepSeek entró en escena como un trueno en enero de 2025, cuando su modelo de razonamiento R1 ocupó brevemente el puesto de ChatGPT como la aplicación gratuita más descargada en la App Store de EE. UU. Desarrollado por un laboratorio de IA con sede en Hangzhou y respaldado por el hedge fund chino High-Flyer, afirmó igualar el rendimiento de la IA de frontera a una fracción del costo de desarrollo. Esta afirmación provocó una conversación global sobre quién estaba ganando realmente la carrera de la IA.

Desde entonces, DeepSeek ha crecido hasta cerca de 97 millones de usuarios activos mensuales y ha lanzado múltiples generaciones de modelos, siendo la más reciente la familia V4 en abril de 2026. Su estructura de precios para la API destaca: el modelo V4 Flash comienza en $0.14 por millón de tokens de entrada, más barato que la mayoría de los modelos de nivel “lite” de OpenAI y Google, y competitivo en benchmarks de codificación, matemáticas y razonamiento. La licencia de código abierto bajo MIT facilita que equipos auto-alojen los modelos y eviten costos por token a gran escala.

En TechRadar Pro llevamos evaluando software B2B desde 2012, y plataformas de IA entre nuestras áreas de cobertura más activas en años recientes. Nuestras recopilaciones de herramientas de IA, guías de codificación y explicadores como OpenClaw y Moltbook dan una idea de las herramientas que seguimos de cerca. DeepSeek es una de las plataformas más polarizantes que hemos probado: impresionante en muchos aspectos, pero no exenta de señales de alerta.

Qué es DeepSeek?

DeepSeek es una plataforma de chat de IA y servicio API desarrollada por Hangzhou DeepSeek Artificial Intelligence Co., Ltd., una empresa china fundada en 2023 y financiada por el hedge fund cuantitativo High-Flyer. Ofrece una interfaz de chat web y móvil gratuita en chat.deepseek.com junto con una API de desarrollador de pago, ambas alimentadas por la misma familia de modelos subyacentes.

La plataforma opera con los propios modelos de IA de DeepSeek, específicamente V4 Flash y V4 Pro, ambos basados en una arquitectura Mixture-of-Experts (MoE). Solo una fracción de los parámetros se activa por token, lo que reduce costos de inferencia sin disminuir la base de conocimiento del modelo.

V4 Pro tiene 1.6 billones de parámetros totales, pero solo 49 mil millones activos en inferencia. V4 Flash tiene 284 mil millones totales con 13 mil millones activos, lo que lo hace significativamente más rápido y económico sin sacrificar en tareas diarias.

Los usuarios natural es la audiencia: desarrolladores, investigadores y empresas sensibles al costo. La capa gratuita de chat sirve para individuos y equipos pequeños que exploran la herramienta, mientras que la API con precios agresivos resulta atractiva para cualquiera que desarrolle aplicaciones impulsadas por IA a gran escala.

DeepSeek, a simple vista

Atributo

Notas

Modelos subyacentes

DeepSeek V4 Flash (284B total / 13B activos) y V4 Pro (1.6T total / 49B activos), ambos MoE

Mejor para

Asistencia de codificación, razonamiento matemático, análisis de documentos, uso de API de presupuesto

Funciones distintivas

1M de contexto, modos de pensamiento/no-pensamiento, caching de prompts, pesos abiertos (MIT)

Funciones de UI

Chat web y apps iOS/Android con conmutador de búsqueda web, subida de archivos (PDF, DOCX, TXT), Modo Experto y Modo Instantáneo

Costos de suscripción

Gratuito (aplicación de chat, consultas ilimitadas); no existen tiers de chat pagos

Precios de API

Pago por token; 5M tokens gratis para nuevas cuentas válidos 30 días; V4 Flash a $0.14 / $0.28 por 1M tokens (entrada/salida); V4 Pro a $1.74 / $3.48 estándar, con descuentos promocionales disponibles

Compre si…

  • Necesita una API barata y capaz para codificación o razonamiento. V4 Flash a $0.14 por millón de tokens de entrada es de among los APIs más asequibles en su tipo, y sus resultados en codificación y matemáticas se mantienen frente a competidores más caros.
  • Quiere pesos abiertos para despliegue en su propia infraestructura. Ambos modelos V4 se publican bajo licencia MIT en Hugging Face, permitiendo ejecutar el modelo en su infraestructura y eliminar costos por token en cargas de trabajo a gran escala.
  • Está haciendo trabajo de exploración no sensible. Para investigadores individuales, estudiantes o desarrolladores prototipando proyectos no confidenciales, la app de chat gratuita ofrece búsqueda web, subida de archivos y un contexto de 1M de tokens sin costo.

No lo compre si…

  • Su trabajo implica datos confidenciales o regulados. Todos los datos de usuario se almacenan en servidores en la China continental, sujetos a la ley china, que permite acceso gubernamental sin consentimiento. Varios gobiernos han prohibido DeepSeek en dispositivos oficiales por esta razón.
  • Necesita respuestas consistentes en temas sensibles. DeepSeek evita ciertos temas políticamente sensibles, especialmente sobre asuntos internos chinos. Este filtrado puede generar respuestas evasivas o incompletas frente a temas que otras plataformas manejan de forma directa.
  • Está en una región regulada por GDPR. La autoridad de protección de datos de Italia bloqueó DeepSeek en enero de 2025 tras una respuesta considerada por reguladores como “completamente insuficiente” a consultas sobre prácticas de datos.

Mi experiencia con DeepSeek

probé la app de chat y la API de DeepSeek en una variedad de tareas: generación de código, resumen de documentos, razonamiento de alto nivel y preguntas y respuestas generales. En capacidad cruda, los modelos V4 me impresionaron. Las salidas de código eran limpias y bien estructuradas, los resúmenes de documentos largos eran precisos y el contexto de 1M tokens manejó la ingestión de PDFs completos sin problema.

El modo de pensamiento, accesible a través del Modo Experto en la interfaz de chat, añadió un razonamiento estructurado de varias etapas que resultó útil para problemas complejos; no fue solo exhibición. Sin embargo, lo que me dejó dudas fue todo lo demás fuera del modelo. Algunas indicaciones políticamente sensibles devolvieron respuestas conspicuamente vagas o elusivas, un comportamiento poco aceptable en contextos profesionales donde la información debe ser completa y confiable. También observé que la interfaz de chat carece de memoria y personalización que sí ofrecen ChatGPT o Claude.

El valor por dinero en el lado de la API es difícil de negar. Una aplicación de producción con prompts bien estructurados se beneficia sustancialmente del caching: token de entrada en caché a $0.014 por millón para V4 Flash, una reducción del 90%. Para cargas de trabajo de alto volumen y baja sensibilidad, esa aritmética es atractiva.

DeepSeek: Funciones

La oferta núcleo de DeepSeek cubre: generación de texto, escritura y depuración de código, resumen de documentos, razonamiento matemático y búsqueda web. La integración de búsqueda web es un conmutador manual en lugar de estar siempre activa, lo que mantiene las respuestas más rápidas por defecto, pero requiere activarlo cuando la información en tiempo real importa. La subida de archivos admite PDF, DOCX y TXT, con la capacidad de resumir y responder preguntas basadas en el contenido subido.

La capacidad destacada es el contexto de 1M de tokens introducido con V4, frente a 128K en la generación anterior. Es un salto significativo para analizar largos contratos, bases de código o documentos de investigación en una sola sesión. V4 Flash cubre tanto modos de pensamiento como de no pensamiento, para no necesitar cambiar entre modelos según la complejidad de la tarea. Esa flexibilidad es más importante de lo que parece al alternar entre tareas casuales y análisis complejos en el mismo flujo de trabajo.

En lo que DeepSeek falla, está el soporte multimodal. La plataforma no soporta generación o comprensión de imágenes en la web, lo que la pone por detrás de ChatGPT, Claude y Gemini en ese frente. Las capacidades agenticas están disponibles en la Vista previa de V4, pero siguen siendo iniciales frente a plataformas dedicadas.

Experiencia de usuario de DeepSeek

La interfaz de chat en chat.deepseek.com es directa y rápida para empezar. Registrarse solo requiere un correo electrónico de un proveedor global como Gmail o Yahoo, y la experiencia por defecto te lleva directo a una ventana de conversación. La distinción entre Expert Mode (pensamiento, más lento) e Instant Mode (más rápido, sin pensamiento) se muestra claramente en la parte superior de la interfaz, y las apps móviles en iOS y Android replican la experiencia web con carga de archivos y búsqueda web incluida.

La curva de aprendizaje es suave para uso casual. Cambiar entre modos de pensamiento y no pensamiento requiere un clic, y el flujo de subida de archivos es simple con arrastrar y soltar.

La experiencia de API es menos indulgente para los integradores primerizos. A diferencia de la app de chat, la API es sin estado, lo que significa que cada llamada debe incluir toda la historia de la conversación en el arreglo de mensajes. La documentación de DeepSeek lo explica con claridad, pero toma por sorpresa a desarrolladores acostumbrados a gestionar el estado de conversación en otros lugares.

Atención al cliente de DeepSeek

Las opciones de soporte para usuarios de chat gratuito se limitan a un servidor de Discord y a un canal de correo para consultas de API (api-service@deepseek.com). Las respuestas de la comunidad en Discord pueden ser rápidas, pero dependen de otros usuarios más que del personal oficial. No hay chat en vivo ni soporte telefónico.

Los clientes de API tienen un poco más de recurso mediante correo directo; la documentación oficial en api-docs.deepseek.com es completa y organizada, cubriendo detalles del modelo, precios, límites y ejemplos de código en Python y curl. Para desarrolladores cómodos con la autoayuda documental, es suficiente.

DeepSeek: Precios

  • La app de chat es gratuita y sin límites de consultas. Las aplicaciones web y móviles permiten acceso ilimitado a V4 Flash y V4 Pro sin costo, incluyendo búsqueda web, subida de archivos y el contexto completo.
  • Nuevas cuentas de API reciben 5M tokens gratis, válidos por 30 días, para prototipar y probar sin coste.
  • Facturación de API es de pago por uso. V4 Flash cuesta $0.14 por millón de tokens de entrada y $0.28 por millón de tokens de salida. V4 Pro se sitúa en $1.74 / $3.48 a tarifas estándar, con descuentos promocionales que pueden reducirlas a $0.435 y $0.87. Los tokens de entrada en caché cuestan una décima de la tarifa de entrada en ambos modelos.

La capa gratuita de chat es generosa en cualquier métrica. Acceso ilimitado con un contexto de 1M de tokens sitúa a DeepSeek por delante de la mayoría de competidores en términos de acceso, y no hay una suscripción de chat paga que preocupe. Los usuarios avanzados que necesiten más control pueden quedarse con la app gratuita o pagar por tokens vía la API.

En la API, DeepSeek ofrece fuertes argumentos para gestionar costos a gran escala. Descuentos fuera de pico de hasta un 75% están disponibles entre las 16:30 y 00:30 UTC, brindando a los equipos con horarios flexibles una palanca adicional de costos. Para apps de producción con prompts bien estructurados y un contexto de sistema compartido, los costos efectivos pueden caer por debajo de $0.02 por millón de tokens con caché aplicado.

Alternativas a considerar

  • ChatGPT (OpenAI): La plataforma de IA más capaz en general, con comprensión de imágenes, voz y memoria. El precio de la API es más alto, pero la residencia de datos en EE. UU. y acuerdos empresariales de datos la hacen una opción más segura para cargas de trabajo sensibles.
  • Claude (Anthropic): Especialmente fuerte para escritura de larga duración y análisis de documentos, con contextos comparables y políticas de manejo de datos más claras. Claude Pro empieza en $20/mes para usuarios individuales.
  • Gemini (Google): Bien integrada con Google Workspace y diseñada para trabajo multimodal en texto, imagen y video. Gemini 2.5 Flash ofrece precios de API competitivos sin preocupaciones de jurisdicción de datos china.

Cómo probé DeepSeek

  • Utilicé la app web gratuita para generación de código, resumen de documents, razonamiento matemático, preguntas y respuestas en múltiples turnos y análisis de archivos, abarcando tanto Instant Mode como Expert Mode para cada tipo de tarea.
  • Realicé llamadas a la API con tamaños de prompts variados para verificar comportamiento de contexto, descuentos por caché y consistencia de respuestas, siguiendo las indicaciones de temperatura de DeepSeek para distintos tipos de tarea.
  • CRuceé la política de privacidad oficial de DeepSeek, investigaciones de seguridad de terceros y acciones regulatorias de Italia, Australia, Corea del Sur y entidades gubernamentales de EE. UU. para construir una visión completa del riesgo de datos.

Más allá de las pruebas prácticas, revisé la documentación oficial de API, el informe técnico V4 publicado en Hugging Face y datos de benchmarks de la versión de abril de 2026. Las cifras de precios se tomaron de la documentación oficial de DeepSeek y se corroboraron con servicios de seguimiento de terceros.

from Latest from TechRadar https://ift.tt/FWpRG63
via IFTTT IA