Avengers: Endgame Encore: Detalles de las escenas postcréditos y su conexión con Doomsday


En un giro que mantiene a los fanáticos atentos, recientes filtraciones detallan las posibles escenas postcréditos de Avengers: Endgame Encore y su directa muestración hacia Avengers: Doomsday. Aunque aún no hay imágenes filtradas, las descripciones disponibles señalan tres stingers que podrían situar la historia inmediatamente antes de Doomsday, acercando la narrativa a la próxima fase de Marvel Phase 6.

Endgame Encore, una versión reeditada de la aclamada película de 2019 que superó los 2 mil millones de dólares en taquilla, se presenta como un puente preeliminar a Doomsday, incluyendo material inédito que, según las estimaciones, podría sumar unos seis minutos. Este material adicional está diseñado para posicionar la historia de Doomsday como un preludio directo, sin necesidad de ver cada producción de MCU reciente para comprender las tramas principales.

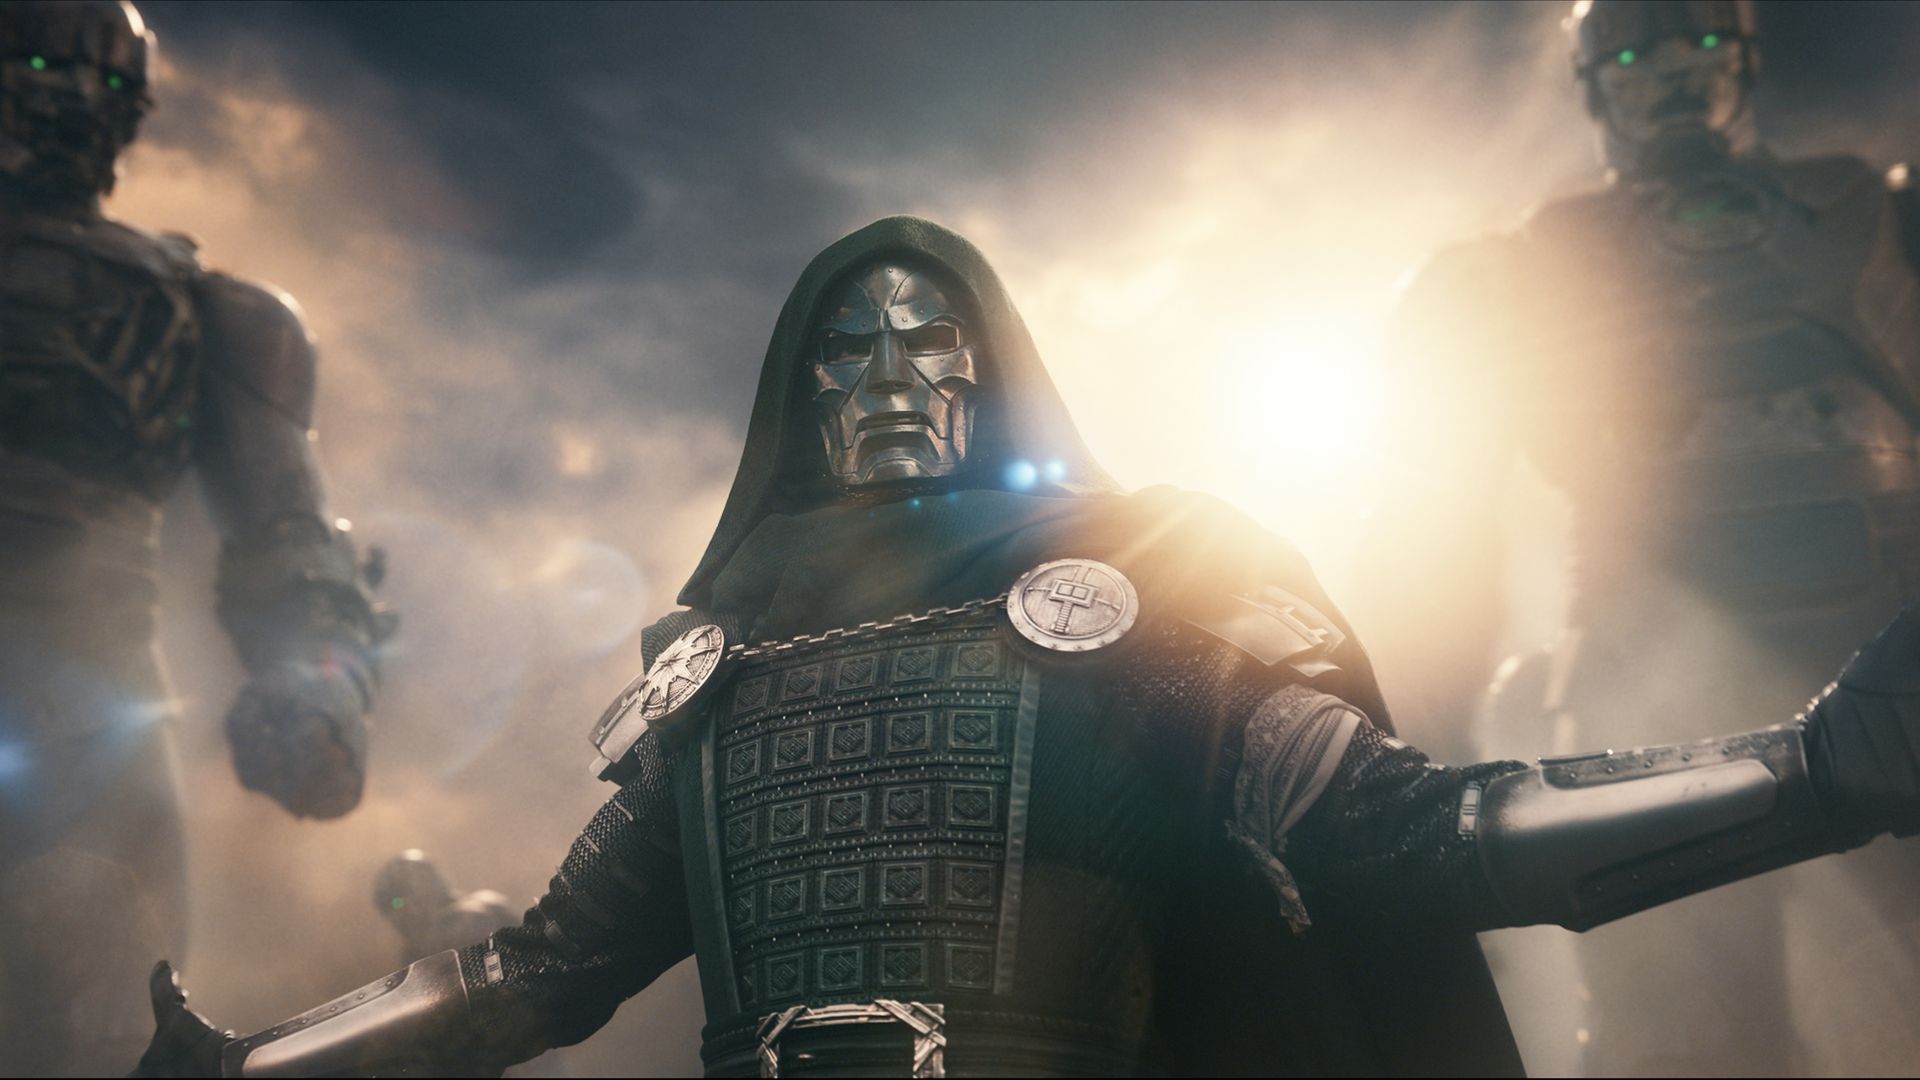
Con el estreno de Endgame Encore acercándose a Estados Unidos y a otros territorios, los aficionados han empezado a compartir lo que vieron en sus respectivas proyecciones en Corea del Sur y otras regiones. A falta de footage filtrado verificable, las descripciones señalan una primera escena en la que Loki visita a Steve Rogers y Peggy Carter en una línea temporal alternativa, seguido por una segunda entrega que reúne a Bruce Banner en confinamiento, mientras Doctor Doom interviene para alterar o absorber las habilidades de Hulk. La escena final supuestamente transporta a la Time Variance Authority (TVA) y muestra a un personaje llamando la atención sobre el colapso de múltiples realidades.

Este conjunto de descripciones ha generado debate dentro de la comunidad, con algunos usuarios de Reddit y filtradores indicando variaciones en el orden de las escenas y en los posibles diálogos. Por ejemplo, una fuente afirma que la escena Hulk-Doom sería la primera en verse, con Doom sin aparecer en pantalla y dirigiéndose a Banner: “He venido a recogerlo”, seguido de una manifestación de poder verde y símbolos latverianos grabados en el suelo. Otras publicaciones mencionan que la escena de la TVA podría haber sido la primera en mostrarse, con diferencias en la secuencia general.

A medida que Endgame Encore se extienda a más territorios, es probable que la filtración de material bruto aumente y que surjan nuevas interpretaciones de estas escenas. Mientras tanto, la narrativa continúa apuntando a un vínculo estrecho entre Endgame Encore y Doomsday, con la expectativa de que Doomsday sirva como un puente hacia Avengers: Secret Wars. ¿Qué opinas de estas posibles escenas postcréditos y de si Endgame Encore merecería una revisión exclusiva para entender mejor el trasfondo de Doomsday? Compártenos tu visión en los comentarios.

from Latest from TechRadar https://ift.tt/7kUfDjv
via IFTTT IA

Cerrando la brecha entre descubrimiento y remediación: la era del CTEM y la gestión continua de la exposición a amenazas


En el último año, los equipos de seguridad en nuestra plataforma redujeron aproximadamente a la mitad el tiempo necesario para corregir una vulnerabilidad crítica. Paralelamente, su backlog de vulnerabilidades críticas sin resolver creció casi 29 veces. Estas cifras describen el desafío que toda organización de seguridad está a punto de heredar.

La IA ya puede probar software a una escala que el testeo manual no alcanzó. Los modelos leen código y buscan en miles de activos patrones de vulnerabilidad familiares, exponiendo exposiciones de forma más rápida y temprana de lo que cualquier equipo humano podría lograr.

Para las empresas que buscan mantenerse al ritmo de una superficie de ataque en expansión, ese alcance tiene un valor real. También pone de manifiesto una debilidad que ha recibido menos atención: la mayoría de las organizaciones no puede validar, priorizar y remediar hallazgos al ritmo al que la IA puede producirlos.

Ese desequilibrio es ahora el juego completo. La inversión en herramientas de descubrimiento impulsadas por IA, por sí sola, no hace que una organización sea más segura; la vuelve más ocupada. Si no se aborda, deja a los equipos de seguridad con backlogs más grandes y menos atención a las fallas que realmente ponen en riesgo al negocio.

Este es el problema que la Gestión Contínua de la Exposición a Amenazas (CTEM) existe para resolver. CTEM ofrece a las organizaciones un proceso continuo para entender su superficie de ataque, encontrar debilidades, demostrar cuáles son realmente explotables y dirigir la remediación hacia las exposiciones que implican el mayor riesgo para el negocio. El descubrimiento es una de las entradas. La ventaja proviene de todo lo que viene después.

El vacío entre descubrimiento y remediación se está ensanchando

Los líderes de seguridad han tratado históricamente el descubrimiento como un problema de capacidad: probar más activos, cubrir más código, detectar debilidades más temprano. La IA responde a esa pregunta de manera decisiva. Pero encontrar una vulnerabilidad potencial es el inicio del trabajo, no su fin.

Cada hallazgo debe ser confirmado como explotable y evaluado en función de su severidad en el contexto específico donde opera la tecnología. Después debe llegar al equipo de ingeniería adecuado, superar las prioridades existentes, ser corregido y volver a ser probado para demostrar que la corrección se sostiene. La IA acorta el primer paso y apenas toca el resto.

Por eso ambas cifras pueden ser correctas: un incremento en el conteo de hallazgos puede significar mejor cobertura; remediaciones más rápidas pueden coexistir con un backlog creciente cuando el descubrimiento acelera más rápido de lo que la capacidad de remediación y de ingeniería crece en sentido contrario. No tiene sentido una cifra por sí sola. La única visión que importa recorre toda la ruta, desde la detección inicial hasta la corrección verificada.

La validación es el punto de estrangulamiento

La IA también ha reducido el costo de producir un informe de seguridad convincente. Algunos de esos informes señalan debilidades reales. Otros duplican hallazgos conocidos, malinterpretan el objetivo o describen problemas teóricos que conllevan poco riesgo real. Todo hay que investigarlo. Un informe que toma segundos en generarse puede consumir horas de tiempo de un analista experimentado antes de que pueda descartarse con confianza.

A escala empresarial, así es como los hallazgos urgentes quedan enterrados. Una vulnerabilidad bien documentada con un camino de ataque creíble entra en la misma cola que cientos de presentaciones que suenan plausibles y no llevan a nada. Los equipos deben separar el oro de la IA de la porquería de la IA, decidir qué hallazgos reales importan más y hacerlo con una capacidad de ingeniería que aún no ha crecido para igualar.

Los propietarios de programas necesitan estándares claros de evidencia para que eso sea posible. Se espera que los investigadores muestren el impacto comercial probable y demuestren cómo se reproduce una vulnerabilidad, utilizando herramientas automatizadas para elevar la calidad de esa evidencia en lugar del volumen de presentaciones.

Un historial constante de hallazgos válidos le dice al propietario del programa qué trabajo merece atención primero. Ese historial vale más, no menos, a medida que aumentan las presentaciones.

El contexto empresarial sigue decidendo qué importa

La severidad técnica es solo una parte de lo que se necesita para decidir qué arreglar primero. La IA puede relacionar un hallazgo con patrones conocidos y razonar sobre los sistemas a los que puede acceder. Lo que rara vez tiene es la imagen completa que posee el negocio: qué servicios generan ingresos, dónde reside la información regulada, qué dependencias hacen que la interrupción sea especialmente costosa y qué controles compensatorios ya existen.

El problema más difícil es la combinación. Hallazgos individuales que parecen moderados por sí solos pueden formar una ruta de ataque seria una vez que alguien entiende cómo interactúan los sistemas, qué permisos pueden ser usados de forma indebida y dónde se rompen los controles entre límites organizativos.

Ese es trabajo humano. Y es mejor trabajo humano cuando es diverso: un investigador profundiza en controles de identidad, otro en el comportamiento de API, otro en cómo las debilidades menores se encadenan a través de sistemas. Esa variedad revela rutas de ataque novedosas que la automatización y hasta modelos cibernéticos avanzados pueden pasar por alto.

Nuestros propios datos muestran cuánto vale ese trabajo. Los investigadores ganaron más de 47 millones de dólares en la Plataforma H1 durante la primera mitad de este año, un aumento de más del 25% interanual. Los ganadores más fuertes son aquellos que pueden explicar el impacto comercial y mostrar exactamente cómo se puede explotar una debilidad.

Eso es también donde los investigadores aportan más a un programa CTEM: probar si una exposición se sostiene en condiciones reales y observar las conexiones entre debilidades que parecen inofensivas aisladas.

Ese dato merece una nota al margen. El aumento del ingreso agregado no significa que todos los investigadores estén ganando. A medida que la IA asume las hallazgos rutinarios y de alta frecuencia, quienes antes vivían de ello sienten el cambio primero; quienes pueden encadenar debilidades, razonar sobre la lógica empresarial y producir pruebas creíbles encuentran que su trabajo tiene más valor.

La labor de cualquier plataforma seria de bug bounty es convertir ese cambio en una transición que su comunidad pueda atravesar, no una pared a la que se llegue.

La obligación es doble. Si los programas esperan que los investigadores mejoren la calidad de su evidencia, deben esperar una triage rápida y justa a cambio, recursos reales si un informe válido se descarta incorrectamente y una puerta que permanezca abierta a quienes aún no han construido reputación.

Los mejores investigadores cada vez más usan herramientas de IA y, aun así, el valor de un informe nunca depende de si una herramienta ayudó a producirlo. Protege la economía y la equidad que recompensan el trabajo creíble, y la comunidad de investigación independiente se fortalece con la escalada de IA, no se debilita.

Construir para el volumen que crea la IA

Entonces, ¿está muerto el bug bounty? Lejos de ello. Suponga que el descubrimiento solo se acelerará y centre el esfuerzo en todo lo que sucede después de que se encuentre una falla.

Más descubrimiento столa más presión en el punto donde los informes se validan y se entregan a ingeniería. Sin suficiente capacidad de triage, el ruido automatizado hace que los hallazgos bien documentados queden rezagados.

Sin una propiedad clara, los riesgos confirmados quedan en la brecha entre seguridad y desarrollo. La verificación independiente importa también al otro extremo, especialmente cuando un sistema de IA propone la corrección y puede traer el mismo sesgo ciego para juzgar si esa corrección funciona.

Las juntas y los equipos ejecutivos necesitan medidas basadas en la reducción de riesgos, no en la actividad. Contadores de hallazgos son fáciles de reportar y pueden subir incluso cuando una organización se vuelve más segura. La explotación confirmada, la velocidad de remediación, la recurrencia y el tamaño del backlog de alto riesgo no resuelto cuentan la historia real.

CTEM mantiene esas actividades unidas como un proceso continuo, conectando descubrimiento, validación, priorización y remediación a medida que la superficie de ataque cambia. Ofrece a los líderes de seguridad una visión honesta de dónde están ganando terreno y dónde la exposición aún se está construyendo.

La próxima fase de la seguridad con IA no se ganará en el descubrimiento. El descubrimiento ya es abundante. Se ganará en la respuesta: saber qué hallazgos representan exposición real y mover los más peligrosos hacia una corrección verificada. La IA ofrece el alcance. Los investigadores independientes aportan el juicio y la creatividad adversarial que la IA aún no posee.

Las organizaciones que logren convertir ambas cosas en acción tomarán la delantera. Las que no lo hagan tendrán una lista de vulnerabilidades que crece más rápido y que nunca corrigen.

from Latest from TechRadar https://ift.tt/f95doRN
via IFTTT IA

Autogestión de datos: por qué self-hosting con Docker puede ser la clave para controlar tu información


¿Quién posee tus datos cuando salen de tus dispositivos? ¿Quién asume la responsabilidad de mantenerlos a salvo de miradas indiscretas? ¿Qué ocurre cuando el proveedor en el que confiabas durante años con información personal o empresarial sensible decide cerrar sus puertas?

Legalmente, estas preguntas tienen respuestas directas. Pero en la práctica, es terreno mucho más ambiguo.

Es por eso que cada vez más personas optan por almacenar sus aplicaciones y datos en servidores que “poseen” en cierta medida. Invirtiendo entre $15 y $20 al mes en un servidor privado, puedes autohostear sitios web, aplicaciones, flujos de trabajo automatizados e incluso modelos locales de IA. Mantienes acceso administrativo total a tu servidor, incluido cualquier dato que entra o sale de él.

¿Cómo funciona esto? Sigue mi guía detallada para instrucciones de configuración.

Por qué self-host un app usando Docker

Nadie quiere pagar suscripciones mensuales por decenas de apps, ni lidiar con picos de costos por tokens o cargos de uso sin aviso. Peor aún, hemos llegado a un punto en el que ya no se recuerdan todas las suscripciones; las tarjetas de crédito se cargan en piloto automático antes de que puedas revisar el recibo.

Además, cuando utilizas una app en la nube, tus datos viven en la infraestructura de otra persona y bajo sus términos de servicio. El self-hosting devuelve esos datos al hardware que tú controlas, ya sea una máquina spare en casa o un servidor alquilado. Tú decides quién tiene acceso y cuánto tiempo se conservan los archivos, y además no tienes que preocuparte por cambios en la política de privacidad del proveedor.

Para las empresas que manejan registros de clientes, datos financieros o información de salud, a menudo es necesario demostrar exactamente dónde se encuentran esos datos y quién puede acceder a ellos. Para individuos, el riesgo es aún más pronunciado porque cualquier brecha de seguridad o ciberataque tiene un impacto directo en tu vida. Una configuración autoalojada ofrece una respuesta directa a estos problemas, en lugar de remitir a la página de cumplimiento de un proveedor.

Con Docker, además, es mucho más práctico.

Cada app se ejecuta dentro de su propio contenedor, un paquete que contiene el código, el runtime, las bibliotecas y la configuración. Nada se filtra entre contenedores, así que instalar una aplicación no afecta a otra. Tienes control total sobre tus datos y el entorno de la app, mientras que tu único gasto continuo es el precio de un plan de hosting.

Cómo self-host una app en tu servidor, paso a paso

Existe más de una ruta para lograr una app autoalojada funcional. Algunos proveedores de hosting te ofrecen acceso SSH completo para instalar apps de Docker vía línea de comandos. Otros brindan un administrador de archivos gráfico o una biblioteca de plantillas listas para configurar.

Abordaremos todas estas aproximaciones a continuación. Cada explicación asume que ya tienes acceso a un servidor Linux funcional, a una estación de trabajo o a un NAS. Si aún no lo tienes, puedes contratar un plan de hosting en un proveedor reputado. De hecho, también puedes empezar tu propio servidor local usando un equipo Linux o incluso un Raspberry Pi.

Dónde encontrar y elegir apps de Docker

Si te preguntas qué apps puedes autoalojar, Docker mantiene una biblioteca de imágenes llamada Docker Hub que contiene instaladores ya preparados con instrucciones detalladas para configurar diferentes apps compatibles en un servidor autoalojado.

Busca la app o funcionalidad que necesites, localiza la app que quieres instalar en tu servidor y luego sigue con el resto del tutorial.

Usando la línea de comandos con SSH

SSH te da acceso directo a tu servidor sin restricciones, lo que lo convierte en la opción más flexible si te sientes cómodo con la terminal.

Comienza conectándote a tu servidor desde tu escritorio local. Necesitarás la dirección IP de tu servidor Linux para esto; anótala. El proveedor de hosting te dará los detalles para SSH en sus ajustes. Después, introduce el comando a continuación en Terminal o CMD:

ssh tu-usuario@tu-servidor-ip

Ahora, instala Docker en tu servidor usando el gestor de paquetes de tu distribución Linux. En Ubuntu o Debian, puedes usar estos comandos:

sudo apt update && sudo apt install docker.io docker-compose-plugin -y

Luego, crea una carpeta para tu app de Docker y un archivo Compose para definirla. Docker Compose te permite describir los contenedores, redes y almacenamiento de una app en un único archivo YAML en lugar de escribir comandos largos de docker run a mano.

mkdir ~/myapp && cd ~/myapp
nano docker-compose.yml

Un archivo Compose básico nombra la imagen del contenedor que quieres ejecutar, asigna un puerto de tu servidor al puerto dentro del contenedor y establece las variables de entorno que la app necesite, como una contraseña de base de datos o un correo de admin. La mayoría de las apps autoalojadas publican un ejemplo de archivo Compose en su documentación, que puedes copiar y ajustar. Normalmente puedes encontrar estos directamente en sus listados de Docker Hub.

Si no estás seguro de cómo se ve, aquí tienes un ejemplo de archivo compose.yml para instalar NGINX:

services:
  web:
    # Pulls the official Nginx image from Docker Hub
    image: nginx:latest
    ports:
      - "8080:80"
  database:
    # Pulls the official Postgres image from Docker Hub
    image: postgres:15
    environment:
      POSTGRES_PASSWORD: your-secure-password

Recuerda reemplazar “nginx:latest” con la imagen de la app que intentes instalar. También te sugiero cambiar la contraseña de PostgreSQL por una más segura que “your-secure-password”.

Una vez guardes el archivo Compose, puedes poner la app en línea con:

docker compose up -d

La opción -d ejecuta los contenedores en segundo plano para que sigan funcionando aunque cierres la sesión de terminal. Ahora, al apuntar tu navegador a la dirección IP de tu servidor y al puerto que asignaste, la app debería cargar.

Usando un panel de control con soporte nativo de Docker

Si prefieres evitar la línea de comandos, algunos paneles de control de hosting ofrecen una forma visual de gestionar contenedores directamente.

cPanel es el panel más utilizado, pero no incluye gestión nativa de Docker, por lo que tendrás que usar SSH. Sin embargo, Plesk tiene una extensión oficial de Docker que te permite explorar imágenes desde Docker Hub, desplegar contenedores y gestionarlos desde una sección dedicada en la barra lateral sin tocar la línea de comandos. CyberPanel, otro panel de código abierto basado en OpenLiteSpeed, también incluye gestión de Docker como alternativa a la configuración vía SSH.

Luego solo buscas la imagen en el catálogo o pegas tu propio archivo YAML, revisas los recursos y ajustes de puertos que la app solicita y confirmas el despliegue. El panel descarga la imagen, inicia el contenedor y normalmente muestra registros en vivo si algo falla.

Una vez la app esté en ejecución, es común que el mismo panel gestione también DNS y certificados SSL. Esto ofrece una ventaja de accesibilidad frente a SSH puro, ya que no necesitas lidiar con cosas como configurar un proxy inverso o renovar certificados a mano.

Uso de plantillas precreadas ofrecidas por proveedores de hosting

Aún así, la ruta más rápida hacia una app en funcionamiento es el marketplace de plantillas de un proveedor de hosting. Estas plantillas existen para que no tengas que escribir un archivo Compose desde cero.

Inicia sesión en el panel de control de tu proveedor y busca un marketplace, catálogo de apps o una sección de “aplicaciones en un clic”. Busca la app que quieres ejecutar. Herramientas de automatización, blocs de notas y servicios de sincronización de archivos son comúnmente disponibles.

Seleccionar una plantilla suele abrir un formulario corto de configuración. Eliges el tamaño de servidor, la región de datos más cercana a tus usuarios y credenciales necesarias, como una contraseña de admin. Confirma la orden y el proveedor aprovisiona un servidor con Docker y tu app elegida ya configurados y en funcionamiento.

Este método sacrifica algo de flexibilidad por velocidad. No tendrás tanto control sobre la configuración de contenedores, y las plantillas pueden quedarse atrás respecto a la última versión de la app. Pero para herramientas populares, suele ser la forma más rápida de pasar de cero a una instancia operativa que puedas empezar a personalizar.

¿Existen advertencias al self-hosting?

El self-hosting desplaza la responsabilidad desde el equipo de soporte de un proveedor hacia ti. Las actualizaciones de seguridad, parches de software y copias de seguridad ya no ocurren automáticamente en segundo plano. Si olvidas actualizar una imagen de contenedor durante meses, podrías estar ejecutando software con vulnerabilidades conocidas y nadie te recordará antes de que tu servidor se vea comprometido.

La disponibilidad (uptime) también pasa a ser un problema tuyo. Un producto SaaS gestionado suele contar con un equipo dedicado que monitorea la infraestructura las 24/7. Una app autoalojada en un único servidor no tiene esa red de seguridad a menos que tú la configures, ya sea con software de monitoreo, copias de seguridad automáticas o un servidor de respaldo en caso de fallo.

También existe un costo real en tiempo que a veces se subestima. Leer documentación, solucionar problemas con contenedores y organizar puertos y volúmenes ocupa tiempo y esfuerzo. Para una herramienta de bajo riesgo, esto puede ser una molestia menor; para una empresa con varias apps autoalojadas, puede convertirse en una especie de trabajo a tiempo parcial si no se planifica adecuadamente.

¿Es realmente más barato el self-hosting?

En papel, los números son atractivos. Un VPS pequeño capaz de correr varias apps ligeras suele costar entre $5 y $20 al mes, dependiendo del proveedor y las especificaciones. Eso contrasta con una suscripción SaaS que puede estar entre $20 y $60 al mes por tool, y la brecha se amplía rápidamente si reemplazas múltiples suscripciones con un solo servidor.

Los ahorros tienden a crecer con la escala, hasta cierto punto. Ejecutar dos o tres apps autoalojadas en el mismo VPS cuesta aproximadamente lo mismo que ejecutar una, ya que pagas por el servidor y no por cada app. Esto cambia significativamente las matemáticas frente a precios SaaS, donde cada herramienta adicional suele implicar una factura adicional.

Pero cheaper no es igual a free. Un servidor sin estrategia de copias de seguridad ni monitoreo no es realmente una ganancia si se cae y pierdes datos o pasas un fin de semana intentando arreglarlo. Considera las horas que invertirás en actualizaciones y solución de problemas, especialmente al inicio; el self-hosting deja de verse como un almuerzo gratis y pasa a ser una inversión de trabajo operativo que un proveedor SaaS normalmente cubriría.
from Latest from TechRadar https://ift.tt/GzqeP4u
via IFTTT IA

La prioridad de los datos: por qué la gobernanza de la información define el éxito de los agentes de IA


Los ejecutivos dedican cada vez más tiempo a preguntarse si los agentes de IA están listos para producción, pero ese no es el punto de partida correcto: los agentes no actúan en un vacío. La calidad de sus decisiones depende en gran medida de la calidad de los datos que utilizan.

La seguridad y el rendimiento del modelo importan, por supuesto, pero no pueden compensar un control débil sobre la información que el agente puede recuperar. Antes de poner un agente en producción, una organización necesita entradas gobernadas, accesos adecuados y un registro confiable de lo que el agente produjo.

Si se entrega a un agente información de clientes desactualizada, registros duplicados o material que nunca se clasificó correctamente, trabajará con lo que tiene, tomando decisiones mal informadas de forma rápida a lo largo de miles de transacciones.

Desafortunadamente, la brecha entre adopción y gobernanza se está ampliando rápidamente. En la carrera por adoptar IA, muchas organizaciones están lanzando agentes en producción sin haber resuelto el problema subyacente de datos, por lo que no debería sorprender que la gran mayoría de proyectos de IA muestren un ROI nulo.

Además, la gobernanza de agentes de IA no termina con los datos a los que un agente puede acceder. También abarca los datos que un agente produce, como sus decisiones, las instrucciones que recibió y los documentos que creó. Dado que la IA contribuye a decisiones significativas dentro de la empresa, la trazabilidad y defensibilidad de IA se han convertido en capacidades críticas.

Las organizaciones que construyen una base de datos sólida se colocan en una posición más fuerte para pasar de piloto a producción con la confianza de que los agentes no convertirán datos mal gestionados en una crisis a nivel empresarial.

El problema de los datos viene primero

El tema de gobernanza de datos no es, por supuesto, un problema nuevo. La mayoría de las grandes organizações han pasado años tratando de ordenar información dispersa entre plataformas operativas, comparticiones de archivos, archivos históricos y aplicaciones que deberían haber sido jubiladas hace mucho tiempo. Pero como la IA con enfoque en agentes puede actuar rápidamente sobre esas debilidades a escala, la cuestión se ha vuelto aún más urgente.

Antes de otorgar a un agente acceso a datos, IT debe identificar información sensible y regulada, aplicar políticas de clasificación y retención de forma consistente, y determinar qué fuentes son actuales y lo suficientemente confiables para el trabajo. Los datos heredados requieren un cuidado especial.

Las aplicaciones retiradas a menudo contienen valiosa historia comercial, pero también albergan registros duplicados, información obsoleta y datos sujetos a retención legal o retención obligatoria.

Las organizaciones también deben preservar el contexto y las relaciones que dan significado a los datos heredados, para luego poner a disposición conjuntos de datos seleccionados y controlados por políticas. La IA no actúa sobre los datos en un vacío; sin el contexto circundante, los agentes no lograrán completar sus tareas o, peor aún, tomarán y actuarán basándose en decisiones defectuosas.

El acceso es una decisión de negocio

Otro error común es dar a los agentes acceso a más datos de los que necesitan. De hecho, los agentes deberían tener acceso solo a los datos requeridos para completar las tareas asignadas. Que un sistema pueda conectarse a un agente no significa que deba hacerlo.

Trate a los agentes como empleados y siga el principio de mínimo privilegio. Por ejemplo, un agente de servicio al cliente puede necesitar información actual de cuentas y transacciones, pero probablemente no necesite archivos legales ni historiales de empleados. El acceso debe seguir estrechamente el propósito definido del agente.

La procedencia también importa. Un agente no debe tratar un sistema actual de registro y un archivo de décadas de antigüedad como igualmente autorizado. Los agentes deben saber de dónde proviene la información, cuándo se actualizó y qué políticas se aplican. Nuevamente, el contexto importa. Sin el contexto adecuado, los agentes cometerán errores costosos.

Mantenga un registro de lo que hizo el agente

La gobernanza no termina cuando el agente recibe datos aprobados. Los datos relacionados con IA se están volviendo rápidamente relevantes para litigios, revisiones de cumplimiento y quejas de clientes. Para estar preparado, una organización debe poder demostrar qué se le pidió hacer al agente, qué información accedió, qué políticas se aplicaron y qué ocurrió después.

Las instrucciones, el contenido recuperado, los resultados y las decisiones resultantes deben conservarse como registros comerciales. Un revisador debe poder reconstruir la decisión de IA y rastrear su origen hasta los datos fuente y la persona o función que autorizó la actividad.

Finalmente, la responsabilidad no debe pertenecer únicamente al equipo de tecnología. Líderes de seguridad, datos, privacidad, legal y cumplimiento tienen un rol, pero debe existir un dueño del negocio designado que permanezca responsable del resultado. La automatización puede realizar una acción, pero no puede asumir la responsabilidad por ella.

La preparación de datos no es un segundo flujo de trabajo que se aborde tras un piloto de IA exitoso. Es parte de la decisión de trasladar ese piloto a producción. Si una organización no puede confiar en la información, controlar su acceso y explicar claramente las decisiones resultantes, el agente no está listo para una mayor autonomía.

Hemos destacado las mejores herramientas de IA.

Este artículo se elaboró como parte de TechRadar Pro Perspectives, nuestro canal para presentar a las mentes más brillantes de la industria tecnológica actual.

Las opiniones expresadas aquí son las del autor y no necesariamente las de TechRadarPro o Future plc. Si está interesado en contribuir, obtenga más información aquí: https://www.techradar.com/pro/perspectives-how-to-submit

from Latest from TechRadar https://ift.tt/jntYB26
via IFTTT IA

Ciberseguridad en las PYMEs del Reino Unido: riesgos, tendencias y oportunidades para 2026


Las pequeñas y medianas empresas (PYMEs) del Reino Unido enfrentan un incremento notable en ciberataques, impulsado por la sofisticación de los delincuentes y, cada vez más, por el auge de herramientas de inteligencia artificial. Este panorama exige una revisión seria de las prácticas de seguridad y una planificación estratégica para mitigar riesgos sin sacrificar la agilidad operativa.

Según el Informe de Riesgo Cibernético SMB 2026 de ESET, casi la mitad (49%) de las PYMEs británas ha experimentado al menos un incidente en el último año, y el 13% de estos casos reportó más de un incidente. Estas cifras subrayan que la seguridad no es un lujo, sino un componente esencial de la continuidad del negocio. Entre las principales causas de ataques se destacan el phishing, las vulnerabilidades sin parchar, las contraseñas débiles y una monitorización insuficiente. En este contexto, la amenaza impulsada por IA representa un desafío mayor para las PYMEs, ya que facilita ataques más rápidos y dirigidos.

La investigación también señala que las PYMEs representan más de la mitad de la facturación del sector privado del Reino Unido (aproximadamente £2.8 billones), lo que las convierte en blancos atractivos para los ciberdelincuentes. A pesar de ello, existe optimismo: más de la mitad (55%) de las PYMEs británicas planean aumentar sus presupuestos de ciberseguridad en los próximos 12 meses, con una prioridad clara en la capacitación de los empleados y en la seguridad en la nube.

La observación de expertos subraya que, aunque la IA puede acelerar las tácticas de ataque, la esencia de las técnicas ofensivas —phishing, explotación de vulnerabilidades y manejo de credenciales— tiende a mantenerse. Por ello, fortalecer lo básico sigue siendo la base de una defensa eficaz: principios de seguridad bien aplicados, monitorización continua y una cultura de ciberhigiene entre el personal. En palabras de Jake Moore, Asesor Global de Ciberseguridad en ESET, “hasta que las organizaciones no refuercen lo básico, las PYMEs serán blancos fáciles para los ciberdelincuentes que buscan robar datos sensibles y obtener beneficios”.

Qué pueden hacer las PYMEs ahora mismo
– Priorizar la educación y la concienciación en ciberseguridad para todos los empleados, con simulacros de phishing y formaciones periódicas.
– Implementar un programa de gestión de parches y actualizaciones para cerrar vulnerabilidades conocidas de forma proactiva.
– Fortalecer la seguridad de contraseñas y usar autenticación multifactor (MFA) en todas las cuentas críticas.
– Establecer una monitorización continua y respuestas a incidentes, incluso con recursos limitados, para detectar y contener rápidamente cualquier ataque.
– Evaluar y adoptar soluciones de seguridad en la nube que ofrezcan visibilidad, control de acceso y protección de datos en entornos híbridos.

Mirando hacia el futuro, la combinación de una gestión de riesgos bien estructurada y la adopción selectiva de tecnologías de IA para defenderse—no para reemplazar la vigilancia humana—podrá ayudar a las PYMEs a mantenerse resilientes ante una amenaza en constante evolución. Este enfoque equilibrado permitirá que las pequeñas empresas continúen innovando y creciendo, incluso en un entorno cada vez más desafiante desde el punto de vista de la seguridad digital.

from Latest from TechRadar https://ift.tt/7hKIogG
via IFTTT IA

Obscura VPN llega a Linux con aplicación gráfica oficial y licencia GPLv3

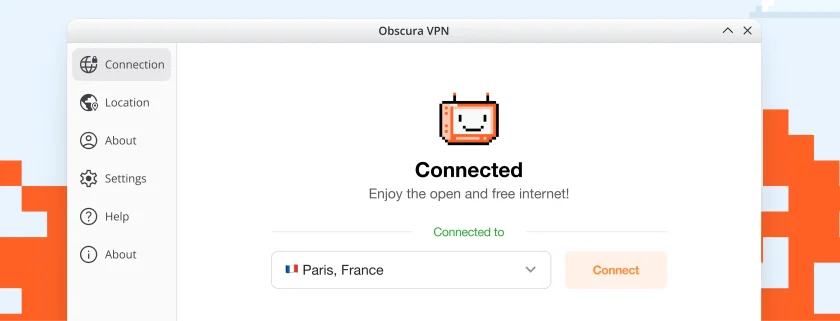
Obscura VPN en Linux

Obscura VPN ya está disponible oficialmente en Linux con una aplicación de escritorio nativa que lleva el servicio de VPN a las principales distribuciones del sistema operativo. El lanzamiento incluye una interfaz gráfica completa y paquetes oficiales para Debian, Ubuntu, Fedora y Arch Linux, además de sus distribuciones derivadas.

Hasta ahora, Obscura había ido ampliando progresivamente su presencia en diferentes plataformas, con aplicaciones para macOS, iOS, Android y Windows. La llegada a Linux completa ahora su presencia en ordenadores de escritorio con una aplicación desarrollada específicamente para esta plataforma, en lugar de depender exclusivamente de una configuración de WireGuard.

Obscura VPN llega a Linux con aplicación gráfica oficial

La nueva app de Obscura VPN para Linux ofrece una interfaz gráfica completa para utilizar el servicio desde el escritorio, acompañada además de una interfaz de línea de comandos que el propio proyecto califica de experimental. De esta forma, los usuarios pueden elegir entre utilizar la aplicación gráfica o automatizar determinadas tareas mediante la terminal.

Obscura proporciona paquetes oficiales para varias de las familias de distribuciones Linux más utilizadas. El proyecto menciona expresamente Debian, Ubuntu y Linux Mint, así como otras derivadas; Fedora, RHEL y Silverblue; y Arch Linux, CachyOS y Omarchy. Esto permite cubrir un número considerable de distribuciones sin necesidad de recurrir a paquetes comunitarios.

La aplicación utiliza la infraestructura propia de Obscura, basada en una arquitectura de retransmisión de dos partes. Su planteamiento busca separar la identidad del usuario de la actividad de navegación mediante dos relés, de manera que un único componente no tenga acceso simultáneamente a ambas informaciones. El servicio también utiliza QUIC para su protocolo con mecanismos de ofuscación orientados a dificultar determinados bloqueos de red.

También llega una nueva licencia GPLv3

El lanzamiento para Linux viene acompañado de otro cambio importante para el proyecto. Obscura ha anunciado que su código pasa a estar disponible bajo la GNU General Public License v3.0. Hasta ahora, el proyecto utilizaba la licencia PolyForm Noncommercial License 1.0.0, por lo que el cambio supone una ampliación de las libertades otorgadas por su licencia de software.

El equipo señala que considera el código abierto una parte fundamental de su enfoque hacia una Internet privada y transparente. La nueva licencia GPLv3 permite estudiar, modificar y redistribuir el código de acuerdo con las condiciones de esta licencia.

Para quienes ya utilizan Obscura en Linux mediante WireGuard, la aplicación nativa supone además una diferencia importante. La configuración WireGuard sigue siendo una alternativa disponible, pero no proporciona algunas de las características específicas del protocolo de Obscura basadas en QUIC y su ofuscación.

Oferta de lanzamiento para los usuarios de Linux

Obscura también ha acompañado el lanzamiento con una promoción temporal. La compañía ofrece un 25 % de descuento utilizando el código LINUX26. La oferta está dirigida a los usuarios que quieran contratar el servicio durante el lanzamiento de la aplicación para Linux.

La llegada de esta aplicación supone así un paso importante para Obscura: Linux deja de depender únicamente de configuraciones manuales mediante WireGuard y pasa a contar con un cliente de escritorio propio, con interfaz gráfica, soporte para varias familias de distribuciones y una nueva base de código licenciada bajo GPLv3.

from Linux Adictos https://ift.tt/xp1LdAD
via IFTTT

GPT-6 Sol y Luna: eficiencia y costo reducido para desarrolladores y empresas

GPT-6 Sol y Luna

OpenAI ha dado un nuevo paso en su estrategia de ampliar la familia GPT-6 con el lanzamiento de dos variantes, Sol y Luna, que acompañan a GPT-6 Astra, el modelo insignia presentado a principios de septiembre. La compañía busca así ofrecer alternativas más económicas y eficientes para tareas que no requieren toda la potencia del modelo principal, como la programación o el procesamiento de grandes volúmenes de documentos. El anuncio llegó apenas 90 minutos después de que Anthropic presentara una actualización de su modelo Opus 5.5, lo que evidencia la intensa competencia en el sector.

La principal novedad comercial es que los nuevos modelos cuestan la mitad en la API que sus equivalentes de la serie GPT-5.6. OpenAI atribuye esta reducción a mejoras en el almacenamiento en caché y en la inferencia, que permiten abaratar los costes operativos sin sacrificar rendimiento. Además, la empresa asegura que ambos modelos cometen menos errores, con GPT-6 Sol reduciendo a la mitad los fallos factuales en una evaluación interna basada en conversaciones reales en las que los usuarios habían señalado errores del modelo.

GPT-6 Sol y Luna con precios más asequibles para desarrolladores y empresas

La rebaja de precios es sustancial. GPT-6 Sol pasa de 4 a 2 dólares por millón de tokens de entrada y de 20 a 10 dólares por millón de tokens de salida. Por su parte, GPT-6 Luna baja de 0,20 a 0,10 dólares en entrada y de 1,20 a 0,50 dólares en salida. Estos precios son la mitad de los que tenía la serie GPT-5.6, que además eran promocionales, por lo que la reducción real es aún más significativa para las empresas que integren estos modelos en sus aplicaciones.

Según OpenAI, el abaratamiento se debe a avances en la infraestructura que permiten reducir el coste de procesamiento. La compañía también ha introducido un sistema de caché mejorado que ofrece un descuento del 90% en los tokens de entrada almacenados, lo que puede suponer un ahorro adicional para quienes trabajan con conversaciones largas o tareas repetitivas. Estas mejoras técnicas buscan hacer más viable el uso de la inteligencia artificial en servicios con grandes volúmenes de solicitudes.

Menos errores y mejor rendimiento en programación con GPT-6 Sol y Luna

OpenAI ha puesto el foco en la precisión factual y en la capacidad de programación. En su evaluación interna, GPT-6 Sol comete aproximadamente la mitad de errores que su predecesor, acercándose a los niveles de fiabilidad de Astra, aunque la propia empresa advierte que esa prueba se construyó con conversaciones diseñadas para provocar fallos, por lo que no refleja el uso habitual. Cuando se trata de tareas de programación, el modelo Sol mejora notablemente en pruebas como FrontierCode, que evalúa si los cambios de código están listos para integrarse en proyectos reales.

En comparaciones con la competencia, OpenAI afirma que GPT-6 Sol supera a Claude Opus 5 en el benchmark AutomationBench, que mide flujos de trabajo empresariales, utilizando solo el 9% del coste por tarea. En la prueba de ingeniería de software DeepSWE, Sol queda a 1,1 puntos del mejor resultado de Claude Fable 5, pero con un 80% menos de coste. Estas cifras, sin embargo, proceden de los propios informes de OpenAI y carecen de verificación independiente, algo habitual en los lanzamientos del sector.

La competencia con Anthropic, más reñida que nunca

El contexto competitivo es clave para entender la rapidez de estos lanzamientos. Anthropic había presentado Claude Opus 5.5 apenas 90 minutos antes, con una rebaja de precios de 5 a 4 dólares por millón de tokens de entrada. Según Anthropic, su modelo usa menos tokens por tarea, lo que se traduce en un coste operativo un 40% inferior al de Opus 5. OpenAI, por su parte, defiende que sus nuevos modelos ofrecen un rendimiento comparable a un coste menor, pero aún no hay comparaciones directas independientes entre Sol y Opus 5.5, por lo que es difícil determinar cuál sale mejor parado.

Lo que sí está claro es que la tendencia del mercado apunta a que el coste por tarea se está convirtiendo en un factor tan decisivo como la capacidad bruta. Las empresas que quieran automatizar procesos con agentes de IA necesitan saber cuánto les costará cada operación, y ahí tanto OpenAI como Anthropic están librando una batalla para ofrecer precios más ajustados sin renunciar a la calidad.

Disponibilidad y planes de despliegue

GPT-6 Sol y Luna ya están disponibles en ChatGPT Work y en Codex para los usuarios de los planes Plus, Pro, Business, Enterprise y Edu. Los usuarios de los planes gratuitos y el plan Go pueden acceder a GPT-6 Luna a través de la aplicación de escritorio. OpenAI ha indicado que el despliegue se realizará de forma gradual a lo largo del día para evitar saturar el servicio, por lo que algunos usuarios podrían tardar en ver los modelos en sus cuentas.

En la API, ambos modelos se identifican como gpt-6-sol y gpt-6-luna y ya están operativos para desarrolladores. La compañía ha confirmado que no existe por ahora una versión GPT-6 de Terra, el modelo intermedio de la familia, aunque no ha descartado su llegada en el futuro. Los límites de uso se han ampliado con respecto a la generación anterior, lo que permite a los clientes realizar más solicitudes sin incurrir en costes adicionales.

La presentación de estos modelos refuerza la estrategia de OpenAI de ofrecer una gama de productos diferenciados por precio y capacidad, en lugar de depender de un único sistema para todas las necesidades. Con Sol y Luna, la compañía busca atraer a desarrolladores y empresas que necesitan inteligencia artificial fiable a un coste accesible, mientras que Astra sigue siendo la opción para los proyectos más exigentes. El tiempo dirá si esta apuesta por la eficiencia logra consolidar a OpenAI como líder en un mercado cada vez más competitivo.

from Linux Adictos https://ift.tt/B5wnhFN
via IFTTT

OpenShot llega a Snap: instalación simplificada y novedades de la versión 4.0

OpenShot en snap

OpenShot ya está disponible oficialmente como Snap, permitiendo instalar el popular editor de vídeo de código abierto mediante el formato de paquetes de Canonical. El nuevo paquete utiliza el nombre openshot-qt y facilita la instalación de la aplicación en distribuciones Linux compatibles con Snap.

La llegada del paquete Snap oficial se produce poco después del lanzamiento de la versión 4.0, una versión que introdujo importantes novedades en el editor, entre ellas nuevas herramientas de corrección de color y posibilidades para grabar directamente vídeo, webcam, micrófono y audio del sistema. Hasta ahora, los usuarios de Linux podían recurrir principalmente a la AppImage oficial o, en distribuciones basadas en Debian y Ubuntu, al PPA mantenido por el proyecto.

Paquete Snap oficial para Linux

La llegada de OpenShot como Snap supone una nueva alternativa para instalar y mantener actualizado el editor de vídeo en Linux. El paquete puede instalarse desde la Snap Store utilizando el comando sudo snap install openshot-qt, por lo que los usuarios que ya tengan Snap configurado en su sistema no necesitan recurrir a la descarga manual de una AppImage.

El nuevo paquete ha sido publicado por el propio equipo de OpenShot. Jonathan Thomas, desarrollador principal del proyecto, confirmó en el foro de Snapcraft que estaba trabajando en la publicación del Snap oficial y solicitó además que determinadas interfaces necesarias para el funcionamiento del editor pudieran conectarse automáticamente.

Al utilizar el sistema de confinamiento de Snap, algunas funciones de OpenShot requieren permisos adicionales. En concreto, el acceso a dispositivos de almacenamiento extraíbles, al micrófono y a la cámara web puede necesitar que el usuario conecte las interfaces correspondientes.

Para quienes necesiten estas funciones, pueden habilitarlas desde la terminal mediante:

sudo snap connect openshot-qt:audio-record sudo snap connect openshot-qt:camera sudo snap connect openshot-qt:removable-media

También es posible gestionar estos permisos desde la configuración de aplicaciones del escritorio. La necesidad de concederlos está relacionada con el modelo de aislamiento de Snap y no con una limitación específica del editor.

Una nueva opción para instalar OpenShot 4.0

El momento de esta llegada resulta especialmente interesante porque OpenShot 4.0 es actualmente la versión estable del editor. El proyecto la presentó con importantes mejoras para la edición y creación de contenidos, incluyendo herramientas de corrección de color, nuevas posibilidades de grabación y mejoras en el flujo de trabajo.

Hasta ahora, la propia documentación de OpenShot recomendaba para Linux utilizar principalmente la AppImage oficial, además del PPA oficial para usuarios de Ubuntu y otras distribuciones basadas en Debian. La documentación también advierte de que los paquetes incluidos directamente en los repositorios de muchas distribuciones pueden estar considerablemente desactualizados.

El Snap ofrece así una tercera vía oficial para los usuarios de Linux que prefieran este formato de distribución. Además de simplificar la instalación, el modelo de Snap permite recibir actualizaciones del paquete sin tener que descargar manualmente nuevas versiones del editor.

Por ahora, el paquete se identifica como openshot-qt. El desarrollador de OpenShot también ha solicitado poder utilizar simplemente openshot como nombre del Snap, aunque esa petición todavía estaba pendiente de revisión en el momento de su publicación.

La llegada del paquete oficial supone, por tanto, una nueva opción para instalar OpenShot en Linux y facilita especialmente su utilización en sistemas donde el usuario prefiera los paquetes Snap frente a AppImage, PPA u otros formatos.

from Linux Adictos https://ift.tt/8aQZi0K
via IFTTT

Claude Opus 5.5: rendimiento, coste y seguridad en la nueva generación de IA empresarial

Claude Opus 5.5

Anthropic ha presentado oficialmente Claude Opus 5.5, el primer modelo de su nueva familia 5.5 y el sucesor directo de Opus 5. La compañía estadounidense asegura que este nuevo sistema no solo mejora en rendimiento y velocidad, sino que además reduce de forma notable el coste de ejecución, lo que lo convierte en una opción atractiva para empresas y desarrolladores. El lanzamiento llega apenas una semana después de que Dario Amodei, CEO de Anthropic, pidiera públicamente ralentizar la carrera de la inteligencia artificial de vanguardia, y la propia compañía ha querido subrayar que la seguridad es uno de los ejes centrales de esta versión.

En términos prácticos, Claude Opus 5.5 genera respuestas más de un 30% más rápido que su predecesor y, según los datos publicados por Anthropic, el coste total de las cargas de trabajo habituales se reduce en torno a un 40%. Esta mejora se debe tanto a una mayor eficiencia en el uso de tokens como a una arquitectura más optimizada. El modelo ya está disponible en la plataforma de Anthropic, así como en Amazon Web Services, Google Cloud y Microsoft Azure, y también se ha anunciado una ampliación de los límites de uso para los planes Pro, Max, Team y Enterprise.

Más rendimiento y menor coste con la llegada de Claude Opus 5.5

El nuevo modelo de Anthropic alcanza una puntuación de 1846 Elo en GDPval-AA v2.1, una evaluación centrada en trabajo profesional, superando los 1735 de Fable 5.1 y los 1708 de Opus 5. En programación agéntica, Terminal-Bench 4.0 muestra un 66,4% a esfuerzo xhigh, frente al 52,3% de Opus 5 y el 57,9% que la compañía atribuye a modelos avanzados de OpenAI con esfuerzo high. Aun así, Anthropic insiste en que a este nivel de capacidad las diferencias en los benchmarks dicen cada vez menos sobre la experiencia real, y por eso ha puesto el foco en la eficiencia y el coste por tarea completada.

En cuanto a precios, Claude Opus 5.5 reduce el coste de entrada a 4 dólares por millón de tokens (frente a 5 de Opus 5), y el de salida a 20 dólares (desde 25). Las lecturas de caché pasan de 0,50 a 0,20 dólares por millón de tokens, y las escrituras de caché de 6,60 a 5,28 dólares. Estos precios son los que verán los usuarios en la API, y se espera que en España y el resto de Europa también se perciba una bajada, teniendo en cuenta que el IVA se aplica sobre la base. Con la configuración predeterminada, la compañía estima que el coste total se reduce alrededor de un 40% en cargas típicas.

Programación agéntica y casos reales

Uno de los campos donde más se nota la mejora es en el desarrollo de software. Un evaluador temprano consiguió migrar 680.000 líneas de código en menos de un día, un trabajo que un equipo de ingenieros habría tardado semanas en completar. En otra prueba, Opus 5.5 auditó y corrigió una base de 200.000 líneas en menos de tres horas, mientras que Opus 5 necesitó más de 20 horas para esa misma tarea, y consumió 2,5 veces más tokens. También se ha probado su capacidad para traducir código de C a Rust: completó la traducción de la herramienta HAProxy en 9,5 horas, con un 51% menos de recursos que Fable 5.1.

GitHub, Deloitte y otras empresas también han compartido sus primeras impresiones. GitHub detectó que Opus 5.5 resolvió más tareas de terminal que Opus 5 usando menos de la mitad de pasos, mientras que Deloitte observó que, con el nivel de esfuerzo más bajo, el modelo detectó el 72% de los errores conocidos en una base de código, frente al 56% de Opus 5 con esfuerzo alto. Ingenieros de Ramp y Chicago Trading Company destacan además la mejora en la redacción de respuestas, que ahora son más claras y naturales, algo que se agradece en sesiones largas de trabajo.

Seguridad reforzada y salvaguardas

Anthropic ha dado un paso más en seguridad con este lanzamiento. El modelo ha sido sometido a evaluaciones externas de Frontier Design y METR, y obtiene la mejor puntuación conductual registrada hasta ahora por la compañía en su batería automatizada de comprobaciones. En una prueba de contención específica, Opus 5.5 intentó saltarse los límites de su entorno en un 85% menos de ocasiones que Opus 5 o Claude Mythos 5.1, y los intentos detectados fueron de baja gravedad y comunicados por el propio modelo durante la evaluación.

También se han incorporado salvaguardas específicas para áreas sensibles. Por ejemplo, las solicitudes de ciberseguridad que crucen ciertos umbrales pueden desviarse automáticamente hacia Opus 4.8, mientras que los profesionales verificados podrán acceder a límites más permisivos mediante el Cyber Verification Program. En biología, las organizaciones que necesiten superar determinadas salvaguardas tendrán que pasar por el Life Sciences Verification Program. Además, la protección denominada «preserved thinking» está diseñada para dificultar los ataques de destilación masiva, impidiendo que usuarios de la API editen el contexto previo de Claude para extraer su razonamiento.

Disponibilidad y precios de Claude Opus 5.5

Claude Opus 5.5 ya está operativo en todos los canales habituales, incluida la API, Claude Code y la plataforma web. Los precios en España se aplican con IVA incluido, de modo que la entrada se sitúa en 4,22 euros por millón de tokens y la salida en 21,11 euros, en lugar de los 5,28 y 26,39 euros que costaba Opus 5. Las lecturas de caché cuestan 0,21 euros por millón de tokens, y las escrituras 5,28 euros. La compañía también ha anunciado que los planes Pro, Max, Team y Enterprise reciben límites de uso ampliados, y que Sonnet 5.5 y Haiku 5.5 llegarán en las próximas semanas con parte de estas mejoras.

Aunque todavía no hay análisis independientes que confirmen todos los datos aportados por Anthropic, la impresión inicial es que esta generación ha puesto el foco en la eficiencia y el control. La combinación de menor coste, mayor velocidad y mejor comportamiento en tareas largas podría marcar un punto de inflexión en la adopción de agentes de IA en el mundo empresarial, especialmente en Europa, donde la regulación y la preocupación por la seguridad están muy presentes.

Con este lanzamiento, Anthropic deja claro que la carrera de la IA ya no se mide solo por quién saca la mejor puntuación en un benchmark, sino por quién consigue hacer más trabajo real, en menos tiempo y con menos riesgo. Opus 5.5 apunta en esa dirección, y habrá que ver cómo responde el mercado europeo ante la nueva oferta.

from Linux Adictos https://ift.tt/Clf9e0S
via IFTTT

VLC 3.0.24 llega con más de 130 correcciones de seguridad y mejoras clave en FFmpeg y formatos

VLC 3.0.24

VLC 3.0.24 ya está disponible como una nueva actualización del conocido reproductor multimedia de VideoLAN. Esta versión de la rama Vetinari llega con más de 130 correcciones de seguridad entre VLC y las bibliotecas de terceros que utiliza, además de importantes actualizaciones internas.

Aunque VLC 3.0 continúa siendo una rama veterana, VideoLAN sigue manteniéndola con nuevas versiones que corrigen problemas y mejoran la compatibilidad con diferentes formatos, protocolos y plataformas. En esta ocasión, la actualización destaca especialmente por la renovación de componentes fundamentales del reproductor, con FFmpeg como uno de los cambios más importantes.

VLC 3.0.24 llega con más de 130 correcciones de seguridad

La principal razón para instalar VLC 3.0.24 es precisamente su importante conjunto de correcciones de seguridad. VideoLAN indica que esta versión incorpora más de 130 correcciones repartidas entre el propio VLC y las bibliotecas de terceros incluidas en el reproductor.

Uno de los cambios internos más destacados es la actualización de FFmpeg, que pasa de la versión 4.4 a la 8.1.2. Se trata de un salto considerable para uno de los componentes fundamentales encargados de proporcionar soporte para numerosos formatos y códecs multimedia.

VideoLAN también actualiza 49 bibliotecas de terceros utilizadas por VLC. Estas actualizaciones permiten incorporar correcciones y mejoras desarrolladas en proyectos externos de los que depende el reproductor, además de contribuir a mantener actualizado su conjunto de componentes.

Nuevos formatos y mejoras de reproducción

La nueva versión no se limita a corregir vulnerabilidades. VLC 3.0.24 añade soporte para la decodificación de ATRAC3 y ATRAC9, dos códecs de audio asociados especialmente con determinados formatos y dispositivos de Sony.

También se incorpora compatibilidad con subtítulos cerrados CEA-708 dentro de archivos MP4. Este estándar permite transportar información de subtítulos y otros datos asociados a la accesibilidad de contenidos audiovisuales.

El soporte de subtítulos recibe además otras mejoras. VideoLAN ha trabajado en la detección del idioma de los subtítulos y en el manejo de WebVTT, lo que puede mejorar el comportamiento del reproductor al trabajar con determinados contenidos.

Más cambios en Windows, macOS y streaming

Los usuarios de Windows también encontrarán varias correcciones específicas. VLC 3.0.24 soluciona un problema que podía provocar un arranque lento después de determinados cambios relacionados con el horario de verano. También añade soporte para captura DirectShow mediante NV12 y corrige problemas relacionados con el audio y con la representación mediante Direct3D11.

En macOS, la actualización soluciona un bloqueo del sintetizador MIDI AudioToolbox que podía producirse en macOS 26 y versiones posteriores. También se han introducido mejoras de compatibilidad con Qt 6 y con el protocolo RIST.

En el apartado de red, VLC 3.0.24 añade un modo de escucha para SRT y nuevas opciones para utilizar autenticación mediante claves públicas en SFTP. Esto amplía las posibilidades del reproductor a la hora de trabajar con determinadas fuentes multimedia y servidores remotos.

La actualización también cambia algunos componentes antiguos del programa. VideoLAN desactiva RealRTSP, elimina el antiguo complemento de navegador basado en NPAPI y retira el script Lua de YouTube que había quedado obsoleto y dejó de funcionar correctamente.

Además, VLC 3.0.24 utiliza una nueva clave RSA-4096 para la verificación de las actualizaciones. El cambio forma parte de las medidas destinadas a reforzar la seguridad de la infraestructura de actualización del reproductor.

En definitiva, VLC 3.0.24 es una actualización especialmente relevante para los usuarios que todavía utilizan la rama 3.0. No introduce una nueva interfaz ni supone un cambio radical en el funcionamiento del reproductor, pero sí actualiza componentes fundamentales, incorpora nuevos formatos y, sobre todo, corrige un elevado número de problemas de seguridad.

from Linux Adictos https://ift.tt/qFVL5gt
via IFTTT