Whoogle Search: un motor de búsqueda auto-alojado

Whoogle

Proporcionamos una serie de utilidades, incluyendo herramientas para aumentar su productividad, ayudarle a gestionar su flujo de trabajo y mucho más. La tabla al final de esta página enumera las utilidades de esta serie. Aunque Google controla el escritorio, sus productos y servicios están muy extendidos, no nos malinterpretes. Hace tiempo que somos fans de varios artículos y servicios de Google. A pesar de todas sus ventajas, confiar en una empresa concreta tiene sus desventajas. Las ofertas de Google suelen ser de gran calidad, sencillas de usar y «gratuitas», pero hay problemas con sus políticas de privacidad, los comportamientos de la empresa y su deseo de manipular todos nuestros datos en todo momento. Un ejemplo de preocupación con sus políticas de privacidad es que si quieres escapar del ecosistema de Google y avanzar hacia la libertad en línea, donde no serás continuamente rastreado, monetizado y conectado al ecosistema de Google, puede que quieras probar Whoogle Search. Tiene exactamente los mismos resultados que Google Search pero con mucha más privacidad.

Whoogle Search es un motor de búsqueda centrado en la privacidad. Muestra los mismos resultados que la Búsqueda de Google, pero sin anuncios/contenido patrocinado, JavaScript, cookies ni seguimiento.

Para poder probar este Whoogle Search, lo primero que hay que hacer es instalarlo, para ello debemos usar Docker, que deberás tener instalado en tu sistema previamente para que funcionen los siguientes comandos:

docker pull benbusby/whoogle-search

Después de esto, el siguiente comando que hay que ejecutar es:

docker run --publish 5000:5000 --detach --name whoogle-search benbusby/whoogle-search:latest

Una vez hecho esto, ya podremos probar en nuestro navegador web favorito cómo funciona Whoogle. Para ello, tan solo tienes que poner la siguiente URL en la barra de direcciones del navegador web:

http://localhost:5000

Entonces te aparecerá el logo del bsucador y la barra de búsqueda para comenzar a usarlo. También tienes varios ajustes como el idioma de la interfaz, idioma de búsqueda, etc.

Más información – Sitio de GitHub

from Linux Adictos https://ift.tt/ilm6DCu
via IFTTT
Pequeña historia de los superordenadores

Velocida

Los superordenadores superan largamente la velocidad de cálculo de los de escritorio.

Todos los años en Linux Adictos nos hacemos eco de la publicación de la lista de los 500 mayores superordenadores del mundo. Y, en un artículo anterior te conté sobre Frontier, el que en este momento no solo es el más rápido del mundo sino también el de mejor rendimiento del mundo.

Como siempre es interesante saber de qué forma llegamos hasta aquí, vamos con una breve historia de los superordenadores.

¿Qué es un superordenador?

Es un equipo capaz de ejecutar cálculos largos y complejos a una velocidad enorme.  El rendimiento de una supercomputadora se mide comúnmente en operaciones de punto flotante por segundo (FLOPS) en lugar de millones de instrucciones por segundo (MIPS).

Las supercomputadoras se utilizan en un amplio campo de actividades que necesitan un uso intensivo del cálculo como la mecánica cuántica, el pronóstico del tiempo, la investigación climática, la exploración de petróleo y gas, el modelado molecular (computar las estructuras y propiedades de compuestos químicos, macromoléculas biológicas, polímeros y cristales) y simulaciones de física teórica del tipo de las simulaciones de los primeros momentos del universo, aerodinámica de aviones y naves espaciales, detonación de armas nucleares y fusión nuclear. También en la creación y rompimiento de métodos de cifrados seguros.

Breve historia de los superordenadores

En 1956, un equipo de la Universidad de Manchester en el Reino Unido comenzó a desarrollar MUSE. Su objetivo era construir una computadora que pudiera operar a velocidades de procesamiento cercanas a un microsegundo por instrucción, es decir alrededor de un millón de instrucciones por segundo Póco tiempo después se cambió el nombre del proyecto por el de Atlas.

El primer Atlas se encargó oficialmente el 7 de diciembre de 1962 y fue considerado en el momento de su puesta en marcha como el ordenador más potente del mundo, El Atlas fue pionero en el uso de la memoria virtual y la paginación como una forma de ampliar su memoria de trabajo mediante la combinación de sus 16 384 palabras de memoria principal y 96 000 palabras adicionales de memoria de batería secundaria.

El primer ordenador que provino de una empresa privada fue de una compañía fundada en 1957 por un grupo de ingenieros en computación entre los que se encontraba Seymour Cray quién después se convertiría en una de las personalidades más destacadas de la industria. La empresa se llamó Control Data Corporation y produjo un ordenador llamado CDC 6000 que se componía de cuatrocientos mil transistores, cien millas de cableado, un novedoso sistema de enfriado y una potencia de cálculo record para la época de 3 megaFLOPS. Este ordenador apareció en 1964

El secreto de la velocidad del CDC 6600 estaba en su capacidad de compartir trabajo con los periféricos permitiendo que la CPU se dedicará únicamente al procesamiento de datos. El lenguaje de programación era FORTRAN.

En 1968, Cray produjo la CDC 7600 que también logró el título del ordenador más veloz del mundo. Funcionando a 36 MHz, el 7600 tenía 3,6 veces la velocidad de reloj del 6600, pero, no tuvo el éxito comercial esperado y Cray dejó CDC en 1972 para formar su propia empresa.

Sin su participación, CDC produjo el STAR-100 con una velocidad de 100 megaFLOPS, es decir tres veces más la velocidad de su antecesor. y utilizaba el llamado procesamiento vectorial, es decir que la CPU estaba diseñada para realizar múltiples cálculos matemáticos en forma simultánea.

Ya en su propia compañía, Seymour Cray produjo tres modelos

  • CRAY-1: Data de 1976 y se trató de una de las primeras supercomputadoras en usar circuitos integrados y trabajaba a una velocidad de 160 megaFLOPS.
  • CRAY X-MP: Apareció en 1982 agregando 4 procesadores y más ancho de banda de memoria al modelo anterior. Su capacidad de cálculo es de 800 megaFLOPS.
  • CRAY-2: Este equipo de 1985 contaba por enfriamiento por líquido y una velocidad de cálculo de 1,9 gigaFLOPS.

Como muchos otros pioneros, Cray no supo detectar el cambio de paradigma y su compañía presentó quiebra en 1995. Mientras tanto sus competidores abrazaban el actual modelo de computación paralela en el que una tarea se divide entre dos o más procesadores que se encargan de resolverla en forma simultánea.


from Linux Adictos https://ift.tt/bZWEFUr
via IFTTT

El ordenador más lento del mundo (Según Google)

Web del reloj del Largo Ahora

El ordenador más lento del mundo operará un reloj destinado a durar 10000 años

En un artículo anterior te contaba la historia del que hasta este momento es el ordenador más rápido del mundo. Ahora vamos a ver la historia del que según Google es más lenta que, curiosamente comparten un mismo pionero.

El ordenador más lento del mundo

La universidad de Tel Aviv entrega todos los años el premio Dan David que se reparte en tres categorías; pasado, presente y futuro. En la edición del año 2002, el galardonado en la categoría «Presente» fue para el doctor Daniel Hill, el primero en crear un ordenador utilizando la tecnología de procesamiento paralelo que hoy utilizan los superordenadores de todo el mundo. En los comienzos de la década del ochenta, Hill demostró que era posible que un ordenador funcionara con varios procesadores en paralelo.  Fue en 1985, mientras trabajaba en su doctorado, que construyó para una empresa privada uno que utilizaba 64000 procesadores.

Sin embargo, al momento de recibir el premio, Hill parecía haber perdido interés en el tema.

La informatización paralela se ha convertido en una forma muy común de informatización así que, en lo que a mí respecta, el tema se ha agotado.

Toda mi contribución a este campo fue para probar que la informatización paralela era bastante simple y no tan complicado como se pensaba anteriormente

El reloj de los 10000 años

En 1996 se creó el fondo Long Now destinado a financiar la construcción de un reloj de 20 metros en lo alto de la cumbre de la Montaña de la Serpiente en el Parque Nacional Great Basin en el desierto de Nevada. La montaña ya había sido adquirida por un fondo especial. establecido por Mitch Kapor, fundador de la desaparecida compañía de software Lotus, la la familia Jay Walker, creadores de Priceline y Bill Joy, fundador de Sun Microsystem. Esta montaña se eligió porque su cumbre se eleva a una altura de 3.000 metros y está rodeada de  un bosque de pinos centenarios, algunos de los cuales superan los 4.900 años.

En el momento de recibir el premio, Hill estaba construyendo un prototipo de dicho reloj, destinado a funcionar nada menos que por 10000 años.  Sus planes incluían construirlo completamente de bronce, un material que el hombre conoce hace miles de años. Este reloj será controlado por el ordenador más lento del mundo que puede trabajar con 5 dígitos (Recordemos que tiene que mostrar la fecha después del año 10000) y será operado por lo que se describe como un movimiento mecánico, enorme, voluminoso y preciso. El ordenador será responsable de una precisión de un día cada 20000 años.

Pero ¿Para qué sirve?

Forma parte de un proyecto de la Long Now Foundation, una entidad sinfines de lucro que busca fomentar el pensamiento a (Muy) largo plazo. A lo que ellos denominan a «escala de civilización».

El reloj, que todavía no fue terminado se llama «Reloj del largo ahora» y como dije más arriba, tendrá escala de monumento, estará construido dentro de una montaña y estará pensado para mantener la hora exacta durante los próximos diez milenios. Cuando esté funcionando requerirá un mantenimiento mínimo y funcionará con energía mecánica recolectada de la luz solar y de las personas que lo visiten.

El Reloj marcará el tiempo con pantallas astronómicas y calendáricas y un generador de campanas diseñado por el compositor Brian Eno que tocará más de 3,5 millones de secuencias únicas de campanadas, una por cada día que se visite el Reloj durante los próximos 10.000 años.

Diez mil años es aproximadamente la edad de la civilización moderna, por lo que el reloj medirá un futuro de civilización igual a su pasado. Esto supone que nuestra civilización está en medio de cualquier viaje en el que estemos, lo que los promotores del proyecto califican como una «muestra de optimismo»

De la web del proyecto

¿Por qué alguien construiría un reloj dentro de una montaña con la esperanza de que suene durante 10.000 años?

Parte de la respuesta: solo para que la gente haga esta pregunta, y habiéndola hecho, se inciten a conjurar con nociones de generaciones y milenios. Si tiene un reloj en marcha durante 10,000 años, ¿qué tipo de preguntas y proyectos a escala generacional sugerirá? Si un reloj puede seguir funcionando durante diez milenios, ¿no deberíamos asegurarnos de que nuestra civilización también lo haga? Si El Reloj sigue funcionando después de que llevamos mucho tiempo muertos, ¿por qué no intentar otros proyectos que requieren que las generaciones futuras terminen?

La pregunta más importante es, como preguntó una vez el virólogo Jonas Salk: «¿Estamos siendo buenos antepasados?»

from Linux Adictos https://ift.tt/4dDbgv3
via IFTTT

HTTP/3.0 recibió el estado de «Estándar propuesto»

HTTP3

Hace poco el IETF (Grupo de Trabajo de Ingeniería de Internet), que desarrolla los protocolos y la arquitectura de Internet, dio a conocer la noticia de que completó la formación del RFC para el protocolo HTTP/3.0 y publicó las especificaciones relacionadas bajo los identificadores RFC 9114 y RFC 9204.

La especificación HTTP/3.0 recibió el estado de «Estándar propuesto», después de lo cual se comenzará a trabajar para darle a RFC el estado de un borrador de estándar (Draft Standard), lo que en realidad significa una estabilización completa del protocolo y teniendo en cuenta todos los comentarios realizados.

El protocolo HTTP/3 define el uso del protocolo QUIC (Quick UDP Internet Connections) como transporte para HTTP/2. QUIC es un complemento del protocolo UDP que admite la multiplexación de varias conexiones y proporciona métodos de cifrado equivalentes a TLS/SSL.

El protocolo fue creado en 2013 por Google como una alternativa a TCP + TLS para la Web, resolviendo el problema de la configuración de conexión prolongada y el tiempo de negociación en TCP y eliminando las demoras debido a la pérdida de paquetes durante la transferencia de datos.

Actualmente, la compatibilidad con QUIC y HTTP/3.0 ya está implementada en todos los navegadores web populares. Del lado del servidor, las implementaciones de HTTP/3 están disponibles para nginx (en una rama separada y en forma de un módulo separado), Caddy , IIS y LiteSpeed. HTTP/3 también es compatible con la red de entrega de contenido de Cloudflare.

Características principales de QUIC:

  • Alta seguridad, similar a TLS (de hecho, QUIC brinda la capacidad de usar TLS sobre UDP)
  • Control de integridad de transmisión para evitar la pérdida de paquetes
  • La capacidad de establecer una conexión instantáneamente y garantizar demoras mínimas entre el envío de una solicitud y la recepción de una respuesta (RTT, tiempo de ida y vuelta)
  • Usar un número de secuencia diferente al retransmitir un paquete, lo que le permite evitar la ambigüedad al determinar los paquetes recibidos y deshacerse de los tiempos de espera
  • La pérdida de un paquete afecta la entrega de solo el flujo asociado con él y no detiene la entrega de datos en flujos transmitidos en paralelo a través de la conexión actual
  • Herramientas de corrección de errores que minimizan los retrasos debidos a la retransmisión de paquetes perdidos. Uso de códigos especiales de corrección de errores a nivel de paquete para reducir las situaciones que requieren la retransmisión de datos de paquetes perdidos.
  • Los límites de los bloques criptográficos están alineados con los límites de los paquetes QUIC, lo que reduce el impacto de la pérdida de paquetes en la decodificación del contenido de los siguientes paquetes
  • No hay problemas con el bloqueo de la cola TCP
  • Soporte de identificación de conexión para reducir el tiempo de reconexión para clientes móviles
  • Posibilidad de conectar mecanismos avanzados para control de sobrecarga de conexión
  • Usar técnicas de predicción de ancho de banda en cada dirección para garantizar tasas óptimas de envío de paquetes, evitando que se produzcan condiciones de congestión en las que se pierdan paquetes.
  • Aumentos notables de rendimiento y rendimiento sobre TCP . Para servicios de video como YouTube, se ha demostrado que QUIC reduce las operaciones de almacenamiento en búfer de video en un 30 %.

Ademas de ello, tambien al mismo tiempo, se publicaron versiones actualizadas de las especificaciones para los protocolos HTTP/1.1 (RFC 9112) y HTTP/2.0 (RFC 9113 ), así como documentos que definen la semántica de las solicitudes HTTP (RFC 9110) y los encabezados de control de almacenamiento en caché HTTP (RFC 9111).

De los cambios en la especificación HTTP/1.1, se puede notar la prohibición del uso separado del carácter de retorno de carro (CR) fuera del cuerpo con el contenido, es decir en elementos de protocolo, el carácter CR solo se puede utilizar junto con el carácter de nueva línea (CRLF).

El algoritmo de diseño de solicitudes fragmentadas se ha mejorado para simplificar la separación de campos adjuntos y secciones con encabezados. Se agregaron pautas para manejar contenido ambiguo para bloquear ataques de clase «Contrabando de solicitudes HTTP» que pueden entrometerse en el contenido de las solicitudes de otros usuarios en el flujo entre el frontend y el backend.

Una actualización de la especificación HTTP/2.0 define explícitamente la compatibilidad con TLS 1.3, se descartaron el esquema de priorización y los campos de encabezado relacionados y el mecanismo de actualización de conexión HTTP/1.1 obsoleto ha quedado obsoleto.

Finalmente si estás interesado en poder conocer más al respecto, puedes consultar los detalles en el siguiente enlace.

from Linux Adictos https://ift.tt/UjMEBbm
via IFTTT

Conoce más sobre Frontier, la computadora más rápida del mundo

Logo de Frontier

Frontier, de los Laboratorios Nacionales de Oak Ridge es la computadora más rápida del mundo

Hace unos días, mi compañero Darkcrizt te contaba sobre la lista de ordenadores más rápidos del mundo. En este artículo voy a contarte la característica del primer equipo de la lista, con el que Estados Unidos recupera el liderazgo de la industria de la computación.

Me refiero a Frontier, que oficialmente fue construida por los Laboratorios Nacionales de Oak Ridge para el Departamento de Energía de los Estados Unidos. Digo oficialmente solo porque sería raro que desaprovecharan el potencial de ese equipo para usos militares, pero no me hagan caso.  Hoy me puse el gorro de aluminio

Conoce más sobre  Frontier

Para entender lo que sigue del artículo comencemos definiendo algunos términos:

FLOPS: Acrónimo en inglés para operaciones de coma flotante por segundo.

Nombre       Abreviatura          Valor

KiloFLOPS      kFLOPS               103
MegaFLOPS    MFLOPS             106
GigaFLOPS     GFLOPS              109
TeraFLOPS     TFLOPS               1012
PetaFLOPS     PFLOPS               1015
ExaFLOPS      EFLOPS               1018
ZettaFLOPS    ZFLOPS               1021
YottaFLOPS    YFLOPS              1024

Como vemos, un exaflop equivale a un trillón de operaciones por segundo.

Lo que llevó al superordenador Frontier del Laboratorio Nacional Oak Ridge del Departamento de Energía a la clasificación más alta como el ordenador más veloz del mundo de la quincuagésima novena edición de la lista de los TOP500 fue su rendimiento de 1,1 exaflops. El sistema Frontier queda en la historia como el primero en alcanzar un nivel hasta ahora no logrado de rendimiento informático conocido como exaescala, Estamos hablando de un umbral de quintillones de cálculos por segundo.

Sin embargo, sus desarrolladores van más lejos. Frontier presenta un rendimiento máximo teórico de 2 exaflops, o dos quintillones de cálculos por segundo, lo que significa diez veces más poder de cálculo que el sistema Summit también desarrollador por los Laboratorios Nacionales de Oak Ridge. El sistema permitirá a los científicos desarrollar tecnologías aplicables en temas de seguridad energética, económica y nacional del país, ayudando a los investigadores a abordar problemas que eran imposibles de resolver hace solo cinco años.

En declaraciones a la prensa, Thomas Zacharia, director del ORNL no fue precisamente modesto:

Frontier está marcando el comienzo de una nueva era de computación a exaescala para resolver los mayores desafíos científicos del mundo.

Este hito ofrece solo una vista previa de la capacidad inigualable de Frontier como herramienta para el descubrimiento científico. Es el resultado de más de una década de colaboración entre los laboratorios nacionales, la academia y la industria privada, incluido el Proyecto de computación a exaescala del DOE (Departamento de Energía de Estados Unidos), que está implementando las aplicaciones, las tecnologías de software, el hardware y la integración necesarios para garantizar el impacto a exaescala.

Pero los logros de Frontier no se limitan al rendimiento.  También ocupó el puesto número uno en la lista Green500, que califica el uso de energía y la eficiencia de los sistemas de supercomputación disponibles comercialmente, con un rendimiento de 62,68 gigaflops por vatio. Frontier completó las clasificaciones bianuales con el primer puesto en una categoría más nueva, computación de precisión mixta, que califica el rendimiento en formatos comúnmente utilizados para la inteligencia artificial, con un rendimiento de 6,88 exaflops.

Puesta en marcha

El trabajo de entrega, instalación y prueba de Frontier comenzó durante la pandemia de COVID-19. Requirió de más de 100 personas del ámbito público y privados que debieron trabajar las 24 horas del día en tareas que van desde la obtención de millones de componentes hasta garantizar las entregas de piezas del sistema en el plazo establecido, pasando por la instalación y prueba cuidadosas de 74 gabinetes de supercomputadoras HPE Cray EX, que incluyen más de 9400 nodos con tecnología AMD y 90 millas de cables de red.

Los componentes de Frontier

  • Frontier tiene 74 gabinetes de supercomputadora HPE Cray EX, diseñados específicamente para admitir el rendimiento y la escala de la supercomputación de próxima generación.
  • Cada nodo contiene un procesador EPYC™ optimizado y cuatro aceleradores AMD Instinct™, para un total de más de 9400 CPU y más de 37 000 GPU en todo el sistema.
  • HPE Slingshot, el único tejido Ethernet de alto rendimiento del mundo diseñado para soluciones de IA y HPC de próxima generación, incluidas cargas de trabajo más grandes y con uso intensivo de datos, para abordar las demandas de mayor velocidad y control de congestión para que las aplicaciones funcionen sin problemas y mejoren el rendimiento.
  • Un subsistema de E/S de HPE. El subsistema de E/S presenta una capa de almacenamiento en el sistema y Orion, un sistema de archivos central mejorado basado en Lustre que también es el sistema de archivos paralelo único más grande y rápido del mundo.

from Linux Adictos https://ift.tt/hnlySoR
via IFTTT

Flatseal: un programa para la gestión de permisos de Flatpak

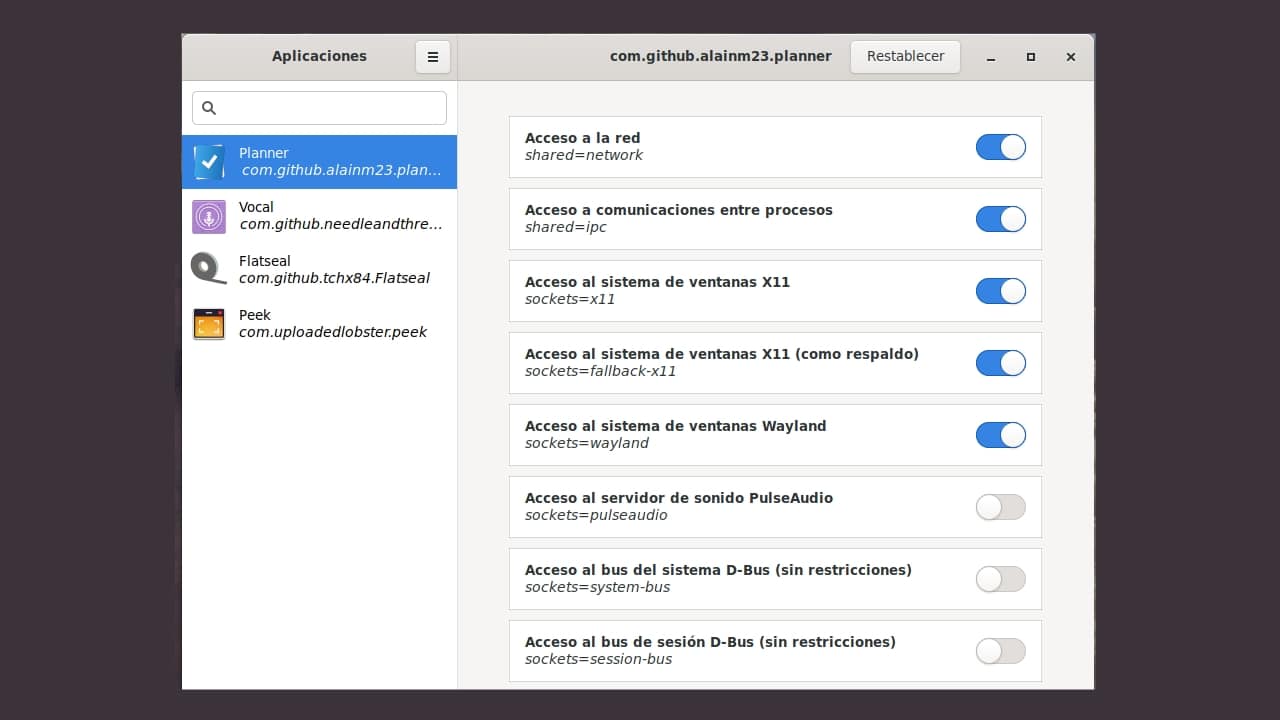
Flatseal

El creador de Flatseal, Martín Abente Lahaye, ha anunciado hoy que Flatseal 1.8 es la última versión estable de esta aplicación de código abierto para la gestión de permisos en distribuciones GNU/Linux. Los usuarios pueden ahora revisar y modificar las anulaciones globales con Flatseal 1.8. Las anulaciones globales se manejan ahora con precisión. Flaseeal ahora muestra todos los cambios de permisos de todas las fuentes, incluyendo las anulaciones globales, cuando se ven los permisos de una aplicación.

Además, Flatseal ahora muestra todos los permisos que el usuario o globalmente cambió. Cuando alguien mira los permisos de una aplicación, estas anulaciones globales deben ser consideradas y mostradas. Ahora se tienen en cuenta todos los permisos que se han modificado. «Con esta versión, lo que se ve es precisamente lo que una aplicación puede o no puede hacer», dice Martín Abente Lahaye en una entrada del blog.

Flatseal 1.8 incluye varias mejoras, como la capacidad de crear directorios «overrides» para aquellos que quieran instalar Flatseal como una aplicación Flatpak en lugar de una aplicación de repositorio de distro, soporte para nuevos esquemas de color a nivel de sistema en el escritorio GNOME, documentación y ventanas de acceso directo simplificadas, e interfaces modales simplificadas. Además de eliminar los permisos del sistema de archivos, Flatseal 1.8 añade soporte para los idiomas búlgaro, chino (China) y danés, corrige problemas menores y advierte a los usuarios de Flatpak sobre la inclusión del modo como parte de la anulación.

Los usuarios de Flatpak pueden descargar Flatseal 1.8 ahora mismo desde Flathub como aplicación de Flatpak para gestionar (conceder o eliminar) los permisos de las aplicaciones de Flatpak. Las próximas versiones de Flatseal introducirán finalmente un puerto GTK4 y libadwaita, así como modelos de backend revisados para eliminar algunas limitaciones más asociadas a la aplicación. Además, se añadirá una interfaz de usuario de anulaciones globales más pulida.

Más información – Sitio de descarga

from Linux Adictos https://ift.tt/3CGAtsq
via IFTTT

Top 5 nombres graciosos de proyectos de software de código abierto

nombres graciosos

En el mundo del software de código abierto hay todo tipo de nombres de proyectos. Están desde los que usan acrónimos, como GNU, hasta los que son totalmente inventados, otros que son como nombres de animales como puede ser cat, los que se componen de la fusión de varias palabras como Linux (Linus + x) o Debian (Debora + Ian), y un largo etc. Pero también vas a encontrar nombres graciosos entre estos programas y aquí he elegido un top 5 de ellos. Puede que no hayas reparado en ello cuando los has usado, pero si reflexionas un poco son bastante llamativos.

Pues allá vamos con la selección de 5 nombres graciosos de proyectos de código abierto que seguro conocerás, pero tal vez no has reparado en su significado:

  • Snort: como sabes es un sistema de detección de intrusos en red, libre y gratuito. Su peculiar logo es un cerdo que no parece haber tenido un buen día, pero hace justicia a la traducción de esta palabra, ya que snort en inglés significa esnifada o bufido.
  • Roundup: es un sistema de seguimiento de problemas fácil de usar. Pero seguro que muchos no han reparado en que también es una marca comercial de un herbicida (glifosato). Sí, el famoso herbicida que tanta polémica ha generado y que patentó la empresa Monsanto (ahora propiedad de Bayer).
  • pip: seguro que lo has usado para instalar programas escritos en Python. Es el sistema de gestión de paquetes para Python, pero su traducción del inglés es pepita.
  • MAD: hay varios proyectos denominados así, como por ejemplo MAD Linux o MAD (MPEG Audio Decoder). Pues bien, si se hace la traducción de este nombre en inglés el resultado es rabioso, furioso, enojado, loco…
  • Python: este nombre, a parte de ser una serpiente (pitón), tiene su gracia, ya que no viene de este reptil sino que su creador se lo puso por el grupo cómico Monty Python.

Por favor, no olvides dejar tus comentarios con más nombres de software que te parezcan graciosos o raros… ¡Hay muchos más!

from Linux Adictos https://ift.tt/OUZ8Mny
via IFTTT

Top 5 nombres graciosos de proyectos de software de código abierto

nombres graciosos

En el mundo del software de código abierto hay todo tipo de nombres de proyectos. Están desde los que usan acrónimos, como GNU, hasta los que son totalmente inventados, otros que son como nombres de animales como puede ser cat, los que se componen de la fusión de varias palabras como Linux (Linus + x) o Debian (Debora + Ian), y un largo etc. Pero también vas a encontrar nombres graciosos entre estos programas y aquí he elegido un top 5 de ellos. Puede que no hayas reparado en ello cuando los has usado, pero si reflexionas un poco son bastante llamativos.

Pues allá vamos con la selección de 5 nombres graciosos de proyectos de código abierto que seguro conocerás, pero tal vez no has reparado en su significado:

  • Snort: como sabes es un sistema de detección de intrusos en red, libre y gratuito. Su peculiar logo es un cerdo que no parece haber tenido un buen día, pero hace justicia a la traducción de esta palabra, ya que snort en inglés significa esnifada o bufido.
  • Roundup: es un sistema de seguimiento de problemas fácil de usar. Pero seguro que muchos no han reparado en que también es una marca comercial de un herbicida (glifosato). Sí, el famoso herbicida que tanta polémica ha generado y que patentó la empresa Monsanto (ahora propiedad de Bayer).
  • pip: seguro que lo has usado para instalar programas escritos en Python. Es el sistema de gestión de paquetes para Python, pero su traducción del inglés es pepita.
  • MAD: hay varios proyectos denominados así, como por ejemplo MAD Linux o MAD (MPEG Audio Decoder). Pues bien, si se hace la traducción de este nombre en inglés el resultado es rabioso, furioso, enojado, loco…
  • Python: este nombre, a parte de ser una serpiente (pitón), tiene su gracia, ya que no viene de este reptil sino que su creador se lo puso por el grupo cómico Monty Python.

Por favor, no olvides dejar tus comentarios con más nombres de software que te parezcan graciosos o raros… ¡Hay muchos más!

from Linux Adictos https://ift.tt/OUZ8Mny
via IFTTT

CoreBoot 4.17 ya fue liberado y estas son sus novedades

Se ha publicado el lanzamiento del proyecto CoreBoot 4.17, dentro del cual se está desarrollando una alternativa libre al firmware propietario y BIOS.

Desde el lanzamiento de la versión 4.16, se realizaron más de 1300 confirmaciones nuevas de alrededor de 150 colaboradores. De esas personas, aproximadamente 15 eran contribuyentes por primera vez.

Principales novedades de CoreBoot 4.17

En esta nueva versión que se presenta, podremos encontrar que se agregaron funciones TIS (Especificación de interfaz TPM) específicas del proveedor para leer y escribir directamente desde los registros TPM (Módulo de plataforma confiable): tis_vendor_read() y tis_vendor_write().

Otro de los cambios que se destaca es que se agregó el soporte para interceptar desreferencias de puntero nulo a través de registros de depuración y que ademas se ha implementado la detección de dispositivos i2c para facilitar el trabajo con lacas equipadas con touchpads o pantallas táctiles de diferentes fabricantes.

Ademas de ello, se destaca que se agregó la capacidad de guardar datos de tiempo en un formato adecuado para generar gráficos FlameGraph que demuestran claramente cuánto tiempo se dedica a las diferentes etapas del lanzamiento.

Se agregó una opción a la utilidad cbmem para agregar tiempo desde el espacio del usuario a la tabla de «marca de tiempo» de cbmem, lo que hace posible reflejar eventos en cbmem en etapas ejecutadas después de CoreBoot.

Se ha implementado la capacidad integrada para generar tablas de páginas de memoria estáticas a partir de archivos ensambladores, sin necesidad de llamar a utilidades de terceros.

Por otra parte, tambien se destaca que se corrigió una vulnerabilidad (CVE-2022-29264) que se manifestó en las versiones de CoreBoot de la 4.13 a la 4.16 y permitía en los sistemas con AP (Application Processor) ejecutar código en el nivel SMM (System Management Mode), que tiene una prioridad más alta (Ring -2) que el modo hipervisor y el anillo de protección cero, y tener acceso ilimitado a toda la memoria. El problema se debe a una llamada incorrecta al controlador SMI en el módulo smm_module_loader.

De los demás cambios que se destacan de esta nueva versión:

  • Se permitió escribir información de depuración en la consola CBMEMC desde los controladores SMI cuando se usa DEBUG_SMI.
  • Se ha cambiado el sistema de manejadores de inicialización CBMEM, en lugar de manejadores *_CBMEM_INIT_HOOK vinculados a etapas, se proponen dos manejadores CBMEM_CREATION_HOOK (usado en la etapa inicial que crea cbmem) y CBMEM_READY_HOOK (usado en cualquier etapa donde ya se haya creado cbmem).
  • Se agregó soporte para PSB (Platform Secure Boot), activado por el PSP (Platform Security Processor) para verificar la integridad del BIOS mediante firma digital.
  • Se agregó una implementación propia del controlador de datos de depuración pasado desde FSP (FSP Debug Handler).
  • Se agregó soporte para 12 placas base, 5 de las cuales se usan en dispositivos Chrome OS o servidores de Google:
    Clevo L140MU / L141MU / L142MU
    Dell precisión T1650
    Estación de trabajo HP Z220 CMT
    Star Labs LabTop Mk III (i7-8550u), LabTop Mk IV (i3-10110U, i7-10710U), Lite Mk III (N5000) y Lite Mk IV (N5030).
  • Se eliminó el soporte para las placas base Google Deltan y Deltaur.
  • Se agregó una nueva carga útil coreDOOM , que le permite ejecutar un juego DOOM desde Coreboot.
  • El proyecto usa código doomgeneric portado a libpayload.
  • El framebuffer lineal de Coreboot se utiliza para la salida y los archivos WAD con recursos del juego se cargan desde CBFS.
  • Componentes de carga útil actualizados SeaBIOS 1.16.0 e iPXE 2022.1.
  • Se agregó el modo SeaGRUB (GRUB2 sobre SeaBIOS), que permite que GRUB2 use las devoluciones de llamada proporcionadas por SeaBIOS, por ejemplo, para acceder a equipos a los que la carga útil de GRUB2 no tiene acceso.
  • Se agregó protección contra el ataque SinkHole, que le permite ejecutar código en el nivel SMM (Modo de administración del sistema).

Adicionalmente, podemos señalar la publicación por parte de OSFF (Open-Source Firmware Foundation) de una carta abierta a Intel, en la que propone modularizar los paquetes de soporte de firmware (FSP, Firmware Support Package) y comenzar a publicar documentación relacionada con la inicialización de SoC Intel.

La falta de código FSP dificulta mucho la creación de firmware abierto y dificulta el progreso de los proyectos Coreboot, U-Boot y LinuxBoot en hardware Intel. Anteriormente, una iniciativa similar tuvo éxito e Intel abrió el código para el firmware PSE (Motor de servicios programables) solicitado por la comunidad.

Finalmente si estás interesado en poder conocer más al respecto, puedes consultar los detalles en el siguiente enlace.

from Linux Adictos https://ift.tt/EuSKnBm
via IFTTT

Tails 5.1 ya fue liberado y estas son sus novedades

Hace poco se dio a conocer el lanzamiento de la nueva versión de Tails 5.1 (The Amnesic Incognito Live System), basado en la base del paquete Debian y diseñado para el acceso anónimo a la red.

El nuevo lanzamiento estaba programado para ser lanzado el 31 de mayo, como estaba previsto, pero debido a algunos problemas en la publicación de una nueva versión del Tor Browser 11.0.14, apenas se dio a conocer la liberación.

Ademas el retraso ayudo a incluir arreglos para vulnerabilidades en el motor de Firefox. Oficialmente, aún no se ha anunciado la nueva versión de Tor Browser, pero las compilaciones ya están disponibles.

Para quienes desconocen de Tor El sistema Tor proporciona una salida anónima a Tails. Todas las conexiones, excepto el tráfico a través de la red Tor, están bloqueadas por defecto por el filtro de paquetes. El cifrado se utiliza para almacenar datos de usuario en el modo Guardar datos de usuario entre ejecuciones.

Principales novedades de Tails 5.1

Dentro de los principales cambios que se destacan de esta nueva version, podemos encontrar por ejemplo que se realizó una transición a una nueva rama estable de Tor 0.4.7 con la implementación del protocolo de control de congestión.

Con ello se han ampliado las capacidades del Asistente de conexión Tor, lo que hace posible conectarse desde redes censuradas a través de puertas de enlace puenteadas para evitar el bloqueo. Antes de conectarse a Tor, la hora en la computadora se ajusta automáticamente para que sea más fácil eludir los sistemas de censura en algunos países.

La información de tiempo se recupera directamente (antes de la conexión a Tor) del servicio de descubrimiento del portal cautivo del proyecto Fedora. La hora que se muestra en la barra superior ahora se muestra en función de la zona horaria seleccionada al ajustar el reloj. Se agregó información a la pantalla que se muestra después de establecer una conexión a Tor, ya sea que se usen o no nodos de puente para la conexión.

Otro de los cambios que se destaca es que se actualizó el kernel de Linux 5.10.113 y el cliente de correo Thunderbird 91.9 y que ademas el administrador de archivos ofrece la posibilidad de transferir archivos mediante la aplicación OnionShare.

Unsafe Browser, utilizado para acceder a recursos en la red local, por ejemplo, para autorización en una red inalámbrica con un portal cautivo, tiene una nueva página de inicio que se muestra en caso de conexión que no sea a través de la red Tor y simplifica la conexión a una red inalámbrica a través de un portal cautivo.
Proporcionó una advertencia sobre una posible pérdida de datos de la sesión al intentar reiniciar con el Navegador no seguro deshabilitado.

El administrador de archivos implementa una llamada al programa para administrar certificados Kleopatra al hacer clic en archivos OpenPGP (ahora basta con hacer doble clic para descifrar archivos *.gpg). Kleopatra también se ha añadido a la lista de aplicaciones recomendadas.

Los proveedores de búsqueda de «archivos», «calculadora» y «terminal» están deshabilitados en el modo de descripción general de GNOME.

Finalmente si estás interesado en conocer más al respecto de esta nueva versión de Tails, puedes consultar los detalles en el siguiente enlace.

Descargar Tails 5.1

Si quieres probar o instalar esta nueva versión de esta distribución de Linux en tu equipo, puedes obtener la imagen del sistema la cual ya está disponible desde su página web oficial en su sección de descargas, en enlace es este.

La imagen que se obtiene desde la sección de descargas es una imagen ISO de 1.GB capaz de funcionar en modo en vivo.

¿Cómo actualizar a la nueva versión de Tails 5.1?

Para aquellos usuarios que tengan instalada una versión anterior de Tails y quieren realizar la actualización a esta nueva versión, pueden realizar directamente siguiendo las instrucciones de este enlace.

Para ello podrán hacer uso de su dispositivo USB que utilizaron para instalar Tails, pueden consultar la información para llevar este movimiento en su ordenador en el siguiente enlace. 

from Linux Adictos https://ift.tt/bZ9fdeI
via IFTTT