Sourcegraph, abandona el open source en favor de una licencia propietaria

Sourcegraph

Sourcegraph se utiliza para buscar, explorar y comprender el código

El proyecto Sourcegraph, que desarrolla un motor para navegar a través de código fuente, refactorizar y buscar en código, a partir de la versión 5.1, abandonó el desarrollo bajo la licencia Apache 2.0 en favor de una licencia propietaria que prohíbe la replicación y venta, pero permite copiar y cambiar durante desarrollo y pruebas.

Para quienes desconocen de Sourcegraph, deben saber que esta es una herramienta de búsqueda de código e inteligencia de código que es compatible con todos los principales lenguajes de programación que indexa y analiza semánticamente grandes bases de código para que puedan buscarse en repositorios comerciales, de código abierto, locales y basados ​​en la nube Sourcegraph.

La búsqueda se puede implementar en varios repositorios y plataformas de alojamiento de código. La búsqueda puede ser literal, expresión regular o estructural. La sintaxis de búsqueda estructural tiene en cuenta el idioma y maneja las expresiones anidadas y las declaraciones de varias líneas mejor que las expresiones regulares.

Sourcegraph cambia de licencia

Originalmente, en las notas de la versión de Sourcegraph 5.1 indicaban que la edición abierta de Sourcegraph se había elsiminado a favor de la licencia de Sourcegraph Enterprise. Desde entonces, el texto ha cambiado para indicar que se han eliminado algunos de los productos de Sourcegraph y se han actualizado las licencias de los componentes relacionados con la búsqueda.

A partir de 5.1.0, el subconjunto de OSS limitado de Sourcegraph se eliminó y el código OSS de búsqueda de código se volvió a licenciar

Al mismo tiempo, componentes tales como complementos con entornos de desarrollo integrados y Cody AI Assistant quedaron en el repositorio bajo la licencia Apache 2.0, y su desarrollo continuó bajo una licencia abierta como parte del repositorio principal del proyecto propietario.

Sourcegraph también prometió publicar una publicación de blog explicando los motivos del cambio de licencia, citando la respuesta de un colaborador en su sistema de seguimiento de errores antes de esa publicación.

Cabe mencionar que el modelo de licencias de Sourcegraph seguirá centrándose en vender productos a empresas y ofrecer herramientas de código abierto a desarrolladores individuales. La edición de comunidad abierta de Sourcegraph no fue bien adoptada entre los desarrolladores, y el 99,9 % de las veces, los usuarios usaban una versión diferente de Sourcegraph Enterprise.

Ademas de que el mantenimiento en paralelo de dos productos relacionados, uno de los cuales no tiene demanda, se reconoce como inconveniente y un desperdicio de los recursos de los desarrolladores. Después de la renovación de la licencia, el código permaneció disponible públicamente (pero bajo una licencia propietaria), al igual que el proceso de desarrollo.

Los desarrolladores de Sourcegraph también seguirán involucrados en el desarrollo del motor de búsqueda de código abierto Zoekt y continuarán impulsando cambios en este proyecto. Como antes, las versiones gratuitas de Sourcegraph Enterprise están disponibles para desarrolladores individuales: con proyectos abiertos, puede usar el servicio en la nube sourcegraph.com de forma gratuita, y para trabajar con código cerrado, puede instalar Sourcegraph Enterprise en su servidor utilizando un plan de tarifas gratuito.

La edición comunitaria del asistente Cody AI, que ha sido solicitada por la comunidad, permanecerá bajo la licencia Apache 2.0. En su forma actual, el código de Cody permanece en el repositorio principal de Sourcegraph por ahora, pero pronto se moverá a un repositorio separado. El cambio también se puede considerar como la división de Sourcegraph en dos productos separados: un motor de búsqueda de código patentado y un asistente de codificación y codificación inteligente de código abierto (Cody).

El motor de Sourcegraph se puede utilizar como plataforma para revisar y navegar por el código fuente alojado en los repositorios de Git. Puede analizar llamadas a funciones arbitrarias y saltar a donde están definidas, ver otras llamadas a estas funciones en el código, ver el historial de cambios, discusiones relacionadas con funciones, documentación y mensajes de error. Sourcegraph también proporciona búsquedas de enlaces flexibles e información sobre herramientas para usar varios objetos.

Finalmente si estás interesado en poder conocer más al respecto, puedes consultar los detalles en el siguiente enlace.

from Linux Adictos https://ift.tt/gFdnOao
via IFTTT

Servidores Nginx aun siguen siendo vulnerables a «Alias ​​​​Traversal»

Nginx Alias ​​​​Traversal

Nginx Alias ​​​​Traversal sigue siendo un problema critico para muchos proyectos

Hace poco se dio a conocer la noticia de que algunos servidores con nginx siguen siendo vulnerables a la técnica «Nginx Alias ​​​​Traversal», que se propuso en la conferencia Blackhat en 2018 y permite el acceso a archivos y directorios ubicados fuera del directorio raíz especificado en la directiva «alias».

La esencia del problema es que los archivos para bloques con la directiva de alias se proporcionan adjuntando la ruta solicitada, después de hacerla coincidir con la máscara de la directiva de ubicación y cortando la parte de la ruta especificada en esta máscara.

El problema aparece solo en configuraciones con una directiva «alias», ya que en la configuración de Nginx, hay una directiva llamada ‘location’ que puede describir cómo se debe manejar el acceso a una URL en particular, y se usa a menudo para asignar direcciones URL a archivos en el servidor.

En el patrón que usa esta ubicación en combinación con el alias, es crítico cuando se cumplen las dos condiciones de ‘no poner una barra al final de la URL especificada por la ubicación’ y ‘poner una barra al final de la ruta especificada por el alias ‘ se cumplan. Se dice que la vulnerabilidad ocurrirá.

En la conferencia BlackHat 2018, Orange Tsai presentó su investigación sobre la ruptura de analizadores de URL. Entre otros hallazgos impresionantes, demostró una técnica descubierta en un desafío CTF de 2016 de HCTF, creado por @iaklis.

Para que la técnica sea aplicable, se deben cumplir las siguientes condiciones:

La locationdirectiva no debe tener una barra inclinada en su camino;
Una aliasdirectiva debe estar presente dentro del contexto de ubicación y debe terminar con una barra inclinada.

Para el ejemplo de una configuración vulnerable que se muestra arriba, un atacante puede solicitar el archivo «/img../test.txt» y esta solicitud coincidirá con la máscara especificada en la ubicación «/img», después de lo cual la cola restante «../ test.txt» se adjuntará a la ruta de la directiva de alias «/var/images/» y como resultado se solicitará el archivo «/var/images/../test.txt».

Por lo tanto, los atacantes pueden acceder a cualquier archivo en el directorio «/var», no solo a los archivos en «/var/images/», por ejemplo, para descargar el registro de nginx, puede enviar la solicitud «/img../log/nginx /acceso.log».

Un análisis de los repositorios en GitHub mostró que los errores en la configuración de nginx que conducen al problema aún se encuentran en proyectos reales.

Por ejemplo, se detectó la existencia de un problema en el backend del administrador de contraseñas de Bitwarden y podría usarse para acceder a todos los archivos en el directorio /etc/bitwarden (las solicitudes de /archivos adjuntos se emitieron desde /etc/bitwarden/attachments/), incluyendo la base de datos almacenada allí con contraseñas «vault.db», certificado y registros, para lo cual fue suficiente enviar solicitudes «vault.db», «identity.pfx», «api.log», etc.

Se menciona que la gravedad de esta vulnerabilidad puede fluctuar significativamente según el proyecto, desde un impacto insignificante hasta uno crítico. El grado de sus repercusiones está determinado principalmente por si el directorio expuesto contiene datos confidenciales que pueden facilitar ataques adicionales o resultar en la divulgación de información privada.

Como punto de partida en nuestra búsqueda de esta vulnerabilidad, elegimos explorar los repositorios populares de GitHub que mostraban este problema. Identificar esta vulnerabilidad específica en entornos con acceso al código fuente se vuelve significativamente más factible, principalmente debido a dos factores principales:

Detección: el uso de herramientas de análisis de código sencillas, como búsquedas de expresiones regulares, nos permite identificar de manera efectiva los archivos de configuración de Nginx potencialmente vulnerables dentro de estos proyectos.
Explotación: tener conocimiento del directorio de destino exacto al que se le ha asignado un alias nos permite configurar una instancia local, examinar los directorios con alias usando un shell local y determinar a qué archivos se puede acceder a través de la vulnerabilidad.

Cabe mencionar que el método también funcionó con Google HPC Toolkit, donde las solicitudes se redirigieron al directorio de interes para obtener una base de datos con una clave privada y credenciales, un atacante podría enviar consultas «secret_key» y «db.sqlite3».

Finalmente si estas interesado en poder conocer mas al respecto, puedes consultar los detalles en el siguiente enlace.

from Linux Adictos https://ift.tt/ypaCJwL
via IFTTT

Cómo hacer copias de seguridad con Timeshift

Timeshift

Aquí en LXA tenemos algunos artículos sobre Timeshift, una herramienta que sirve para hacer copias de seguridad de nuestro sistema operativo basado en Linux. En uno de ellos se explica qué es, y en otro cómo instalarlo en Linux. Ambos son artículos que podríamos etiquetar como de archivo, estando más actualizado el que nos habla del software y algo más obsoleto el de su instalación. Lo que no tenemos es un artículo que explique cómo usar el programa.

Como ya dijo mi compañero Isaac en su día, lo cierto es que Timeshift es un programa muy sencillo que básicamente es ir siempre hacia adelante, pero es comprensible hasta cierto punto ese temor que tienen algunos usuarios de zambullirse en cualquier charco que no conozcan. Por ese motivo, y porque acaban de publicar cómo actualizar a una nueva versión de Linux Mint y usar Timeshift es uno de los pasos recomendados, me he decidido a escribir este artículo.

Podría seguir el artículo hablando sobre cómo instalar Timeshift, pero me pasaría como a Joaquín y es probable que, pasados unos meses/años, ese apartado sólo sirva para confundir porque las cosas son diferentes. Yo sí puedo decir que en la actualidad está en los repositorios oficiales de Ubuntu o Manjaro, que ahora es parte del software de Linux Mint (es una XApp) y es el proyecto que lidera Clem Lefebvre quien se encarga de su mantenimiento. Si una distribución no ofrece el software en sus repositorios, la página de GitHub es esta, en la que se menciona que es una XApp. Los sistemas basados en Arch lo tienen en AUR.

Cómo usar Timeshift

Cómo hemos explicado, el uso de Timeshift es más bien ir hacia adelante una vez ya está instalado.

1- Introducir contraseña para iniciar

Siempre que lo abramos nos pedirá la contraseña, y tras introducirla podremos configurar cómo queremos que se hagan las copias.

2- Elegir sistema de archivos

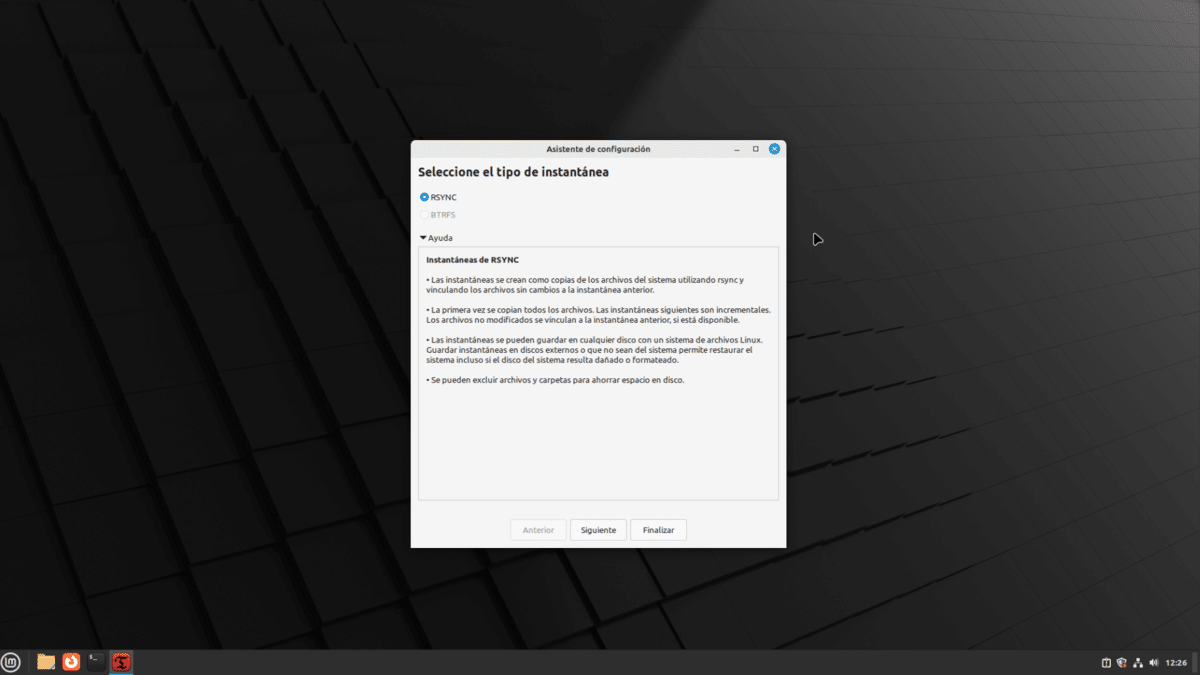
Lo primero que veremos será el tipo de instantánea que queremos hacer. Haciendo clic en «Ayuda» veremos cómo es cada una. Tenemos que elegir lo que mejor se ajuste a nuestras necesidades. Leyendo como funciona cada una, parece que la opción BTRFS es más potente, pero tiene que usarse en una unidad formateada con ese formato.

3- Ir a configuración de Timeshift

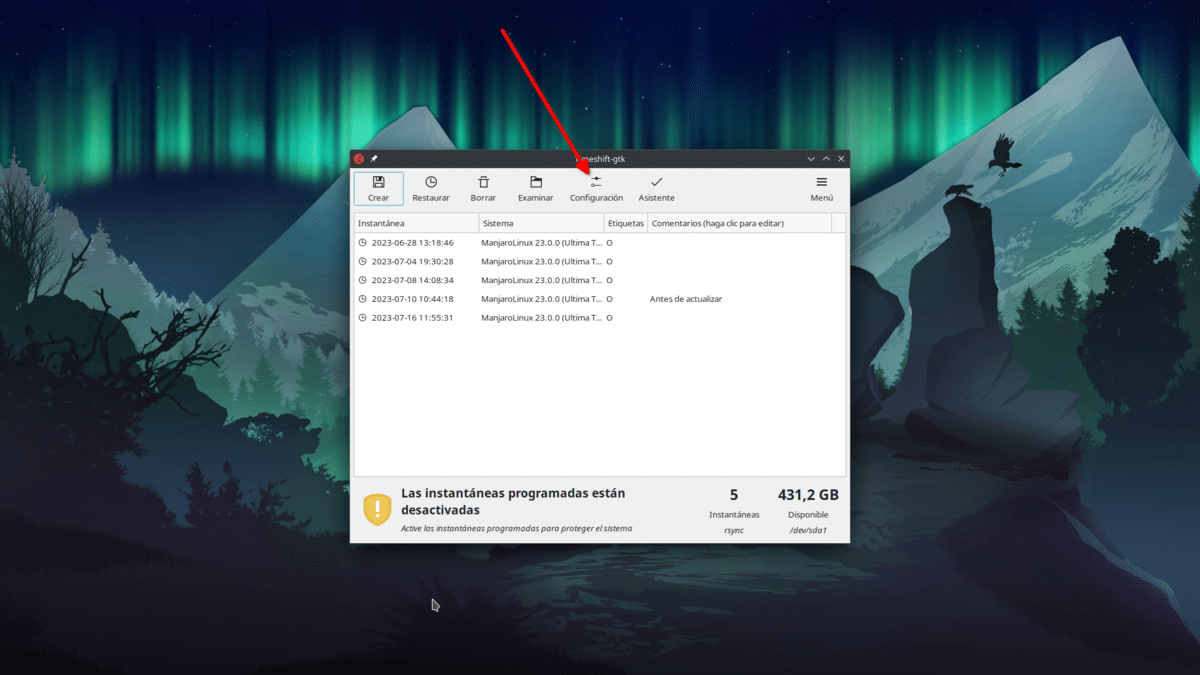
Una vez dentro se verá algo como lo anterior, pero sin ninguna instantánea. El fondo de pantalla no os cambiará, tranquilos. A mí me ha cambiado porque he empezado con Linux Mint (para iniciar de cero) y luego he seguido en mi Manjaro. Para realizar la configuración haremos clic en su botón. Veremos algo como lo siguiente:

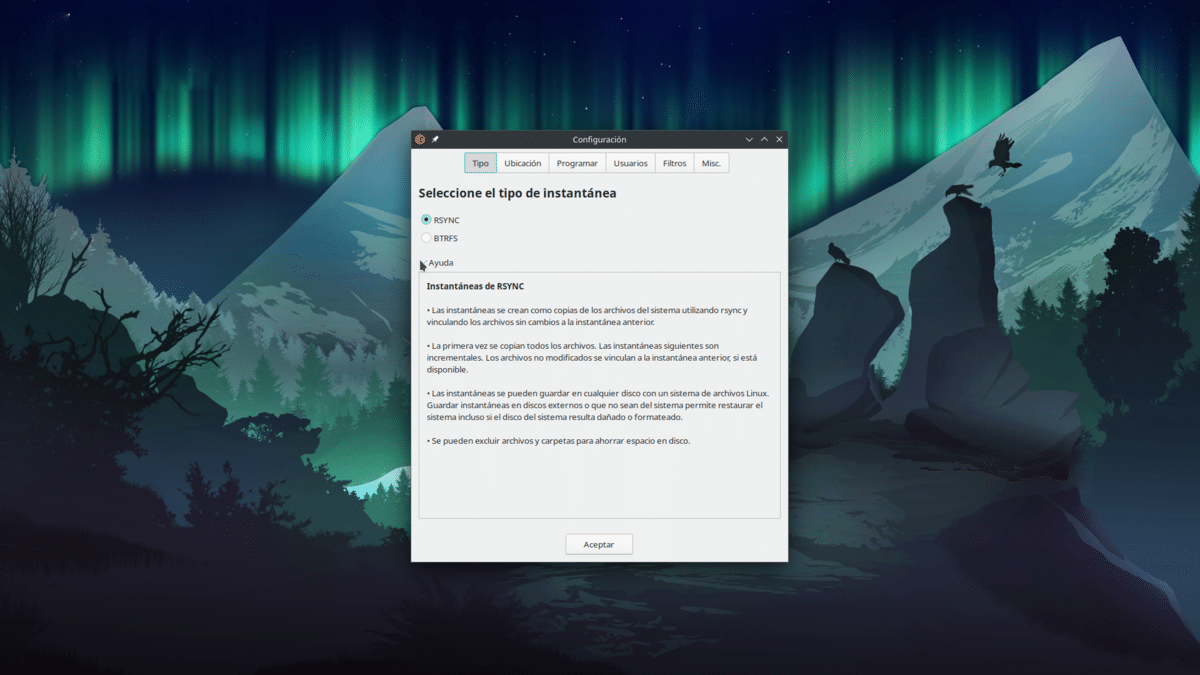
4-Tipo de instantánea

La primera pestaña es la del tipo de instantánea y es igual que la anterior, con la diferencia de que en esta ventana de configuración también podemos acceder al resto de parámetros.

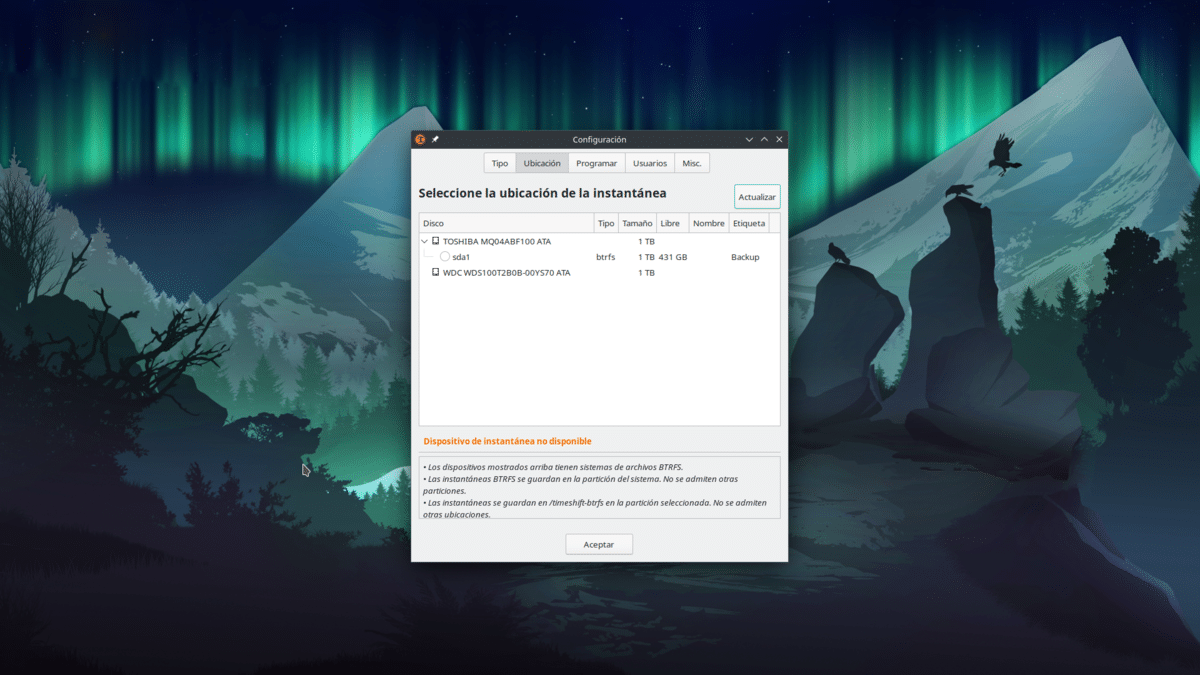
5- Ubicación de las copias

La siguiente pestaña es la de la ubicación, es decir, dónde se harán las copias de seguridad. Seleccionamos la unidad en donde queremos las copias.

6-Programación de copias de Timeshift

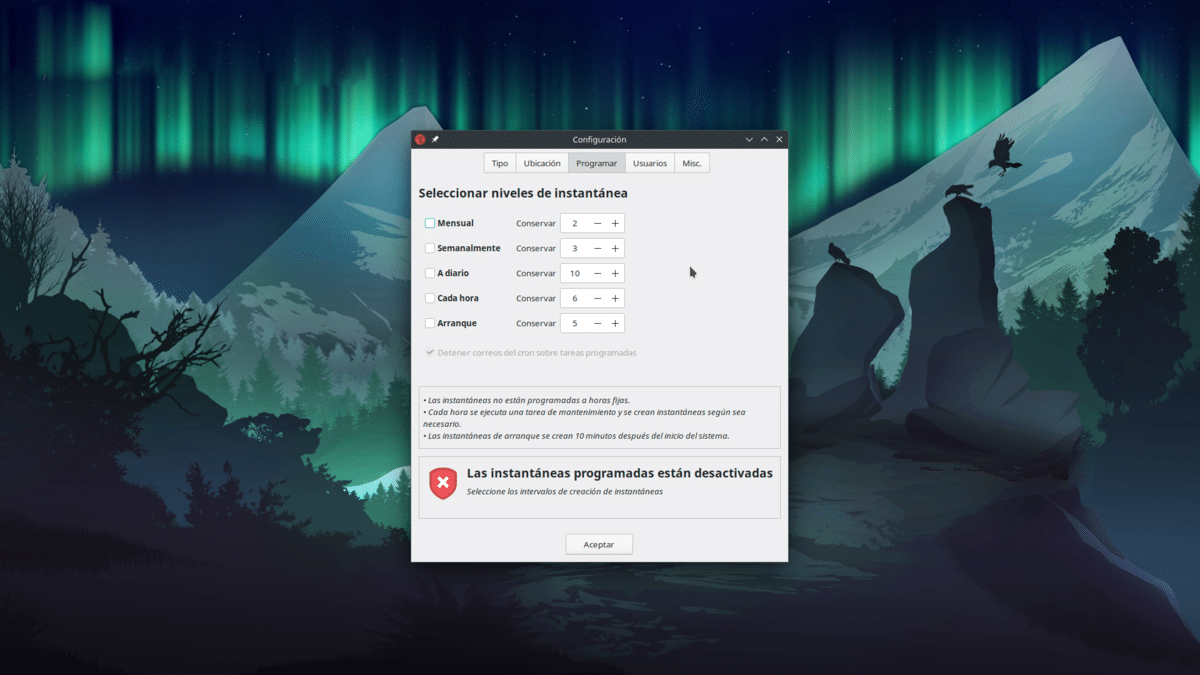
Desde la pestaña «Programar» programaremos las copias automáticas. Podemos elegir entre mensual, semanal, diaria, a cada hora o al iniciar el sistema operativo, y no son excluyentes. También podemos indicar el número que debe guardar de cada tipo de copia. Si ponemos que almacene 5 y se llega a ese tope, irá eliminando las más antiguas.

7-Usuarios

Desde Usuarios podremos indicar si se incluye en las copias el subvolumen @home.

8-Formato de la fecha de Timeshift

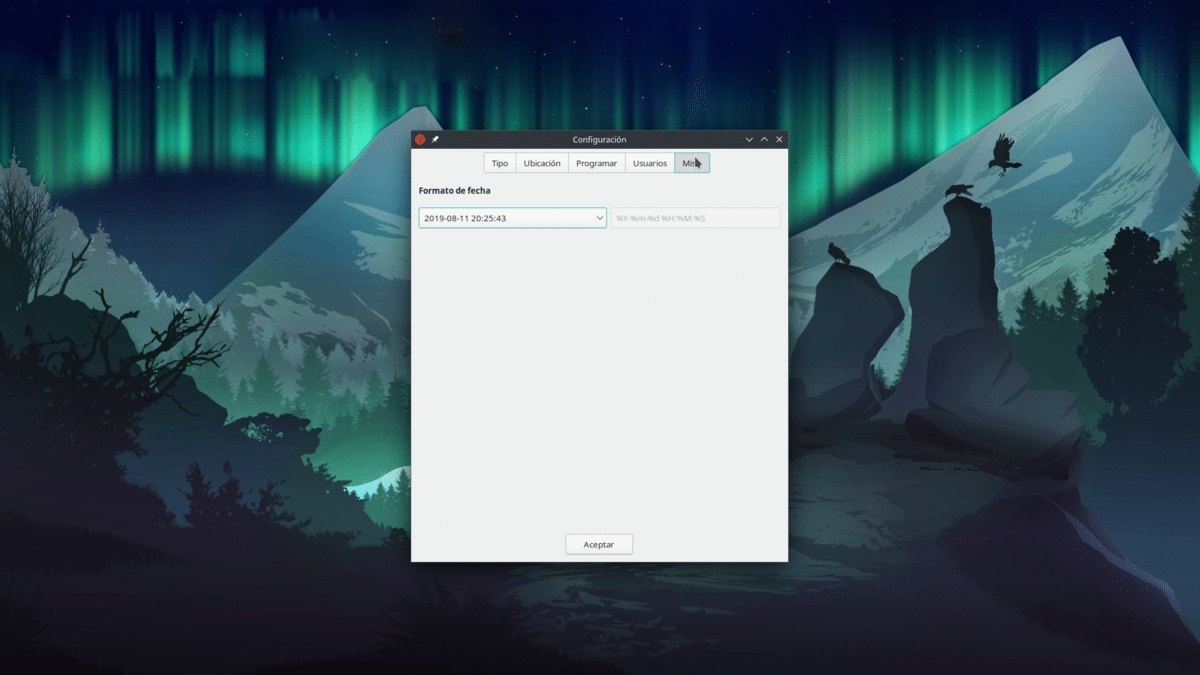
Y por último, en Misc., en el momento de escribir este artículo podemos indicar cómo se muestra la fecha y la hora. Al hacer clic en Aceptar ya estará todo preparado. Si hemos indicado que haga copias automáticas, las hará como le hayamos indicado.

Botones de la pestaña principal

En la ventana principal tenemos los botones de:

  • Crear: podemos crear una copia de seguridad manual cuando queramos.
  • Restaurar: nos permitirá restaurar una copia de seguridad.
  • Borrar: podremos borrar manualmente una copia.
  • Examinar: nos abrirá un gestor de archivos para que podamos navegar por todo lo que contienen las diferentes copias.
  • Configuración: es lo que hemos explicado más arriba.
  • Asistente: iniciará el asistente de configuración.

Aunque todo es bastante sencillo, sí me gustaría explicar algo: las copias de seguridad se hacen iniciando un proceso, y en ocasiones no podremos, por ejemplo, apagar el equipo hasta que finalice o el mismo Timeshift haga lo necesario para parar la copia de seguridad. Puede que nunca lo notemos, pero es una posibilidad. Por otra parte, si no se hacen muchos cambios, las nuevas copias se hacen a partir de las anteriores, y examinar los cambios y añadirlos a una nueva copia puede ser cuestión de segundos.

Se use el software que se use, merece la pena tener siempre una copia de seguridad de nuestros archivos más importantes, y Timeshift es una de las opciones más sencillas y eficaces.

from Linux Adictos https://ift.tt/7IEv8fo
via IFTTT

Ya se puede actualizar a Linux Mint 21.2 «Victoria». Esta es la manera

Actualizar a Linux Mint 21.2

Linux Mint 21.2 «Victoria» se puede descargar desde el pasado domingo. Para ser fieles a la verdad, se puede desde pocos días antes, pero el día 16 es cuando se hizo pública su disponibilidad. Cuando Clem Lefebvre o alguien de su equipo dice que hay disponible una nueva versión de Linux Mint, lo que está pasando es que ya se pueden descargar las nueva ISOs, pero aún no se puede actualizar. Ese momento llega días después.

Cuando he empezado a escribir este artículo aún no hacía ni una hora desde que la cuenta oficial de Linux Mint en Twitter había publicado el artículo con las instrucciones necesarias para actualizar a Linux Mint 21.2 «Victoria» desde versiones anteriores. El enlace es este, pero nosotros vamos a publicar la guía a nuestra manera y con capturas y texto en español; WordPress hará lo suyo y, como siempre, traducirá el artículo a otros muchos idiomas.

Cómo actualizar a Linux Mint 21.2

La siguiente guía no es más que un reflejo de la original. Hay pasos que se pueden omitir, pero todo lo explicado aquí es lo recomendado.

  1. Crear una copia de seguridad. El proyecto recomienda usar Timeshift, herramienta que adoptaron hace unos años y que sirve justamente para hacer «snapshots» de nuestro sistema operativo. Para el que no entienda la palabra en inglés, son instantáneas o copias de seguridad, aunque si no usan «backup» es porque las «snapshot» no son exactamente lo mismo que un simple «respaldo». En este enlace explicamos cómo hacer copias con Timeshift.
  2. Preparamos la actualización. Este paso es básicamente aplicar todas las actualizaciones que tengamos pendientes. Se puede hacer desde el centro de software o desde el terminal. Siendo una distro basada en Ubuntu, se puede usar sudo apt update && sudo apt upgrade. Finalizado el proceso, reiniciamos.
  3. Actualizamos el sistema operativo. Esta parte, que es la importante, consta de algunos pasos propios.
    1. Si no salta automáticamente, vamos al menú de inicio, buscamos «gestor de actualizaciones» y hacemos clic en su icono del menú de inicio.

Gestor de actualizaciones de Linux Mint

    1. Dentro del Gestor de actualizaciones, hacemos clic en «Recargar». Si aparece lo mismo que en la siguiente captura es porque nunca se había abierto el gestor; sólo hay que hacer clic en aceptar. No debe haber nada por actualizar. Si aparece algún paquete, lo actualizamos.

Recargar

    1. Vamos al menú «Editar» y dentro a «Actualizar a Linux Mint 21.2 Victoria».

Actualizar a Linux Mint 21.2

    1. Seguimos las instrucciones que aparecen en pantalla: en la primera ventana veremos un mensaje de introducción y sólo tenemos que hacer clic en «Siguiente»; en el segundo veremos las notas de esta versión; en el tercero hay un enlace para ver las novedades; en el cuarto hay una caja de verificación o checkbox que hay que marcar para poder continuar. Es el típico de que aceptamos los riesgos. Al hacer clic en «Aplicar» hay que poner la contraseña. Descargará los paquetes y los instalará; por último veremos lo que en la lista aparece como «Resumen», que básicamente es que el proceso ha finalizado con éxito.

1-Introducción
2- notas de la versión
3- Características nuevas en Linux Mint 21.2
4- Aceptar los riesgos


5- Descargando paquetes

    1. Reiniciamos para que todo surta efecto.

Reiniciar para entrar en Linux Mint 21.2

Disponible para 21 y 21.1

La primera frase de la guía indica que «ahora es posible actualizar Linux Mint 21 y 21.1 a 21.2«, por lo tanto, sólo están soportadas las versiones que empiecen por el número 21. Los usuarios que están en Linux Mint 20 o anteriores deben realizar el proceso tantas veces como sea necesario. Por ejemplo, los de Linux Mint 20 que quieran subir a 21.2 deben subir primero a la versión 21 que muestre el gestor de actualizaciones y luego a 21.2.

Lo recomendable sería subir a saltos lo más pequeños posibles, o dicho de otro modo actualizar cada seis meses. En el caso de que alguien prefiera quedarse más tiempo en una versión anterior, posible porque son todas LTS, lo único que hay que hacer es actualizar sólo los nuevos paquetes, olvidándose de la opción de Editar/Actualizar a Linux Mint X.

Para nuevas instalaciones, en nuestro artículo sobre la disponibilidad de Linux Mint 21.2 «Victoria» tenemos los enlaces para descargar las ISO, que recordamos que hay opciones Cinnamon, MATE y Xfce.

from Linux Adictos https://ift.tt/ulEzONx
via IFTTT

Kubuntu: cuatro opciones de software diferentes para cualquier tipo de usuario (válido para Ubuntu Studio y Lubuntu)

Kubuntu y sus diferentes opciones

Ubuntu y todos sus sabores oficiales están disponibles en dos opciones: las normales o «interim» (provisionales) son las de ciclo normal, las que están soportadas durante 9 meses y se actualizan cada 6. Luego tenemos las LTS, que salen los abriles de los años pares, se actualizan cada dos años y están soportadas durante 5 o 3, dependiendo del sabor. Algo diferente pasa con Kubuntu, que las diferentes combinaciones nos permiten tener hasta 4 opciones diferentes.

Me gustaría explicar algo antes de seguir: aunque en este artículo vamos a hablar de Kubuntu, lo explicado aquí vale en su mayoría también para Ubuntu Studio y Lubuntu. Ubuntu Studio usa Plasma desde hace algunas versiones, y Lubuntu hace poco que ha creado su propio repositorio backports. A quien le interese más alguna de esas ediciones, a partir de aquí casi que podría sustituir la palabra Kubuntu por Lubuntu/Ubuntu Studio. Explicado esto, hay un Kubuntu para cada tipo de usuario.

Otra cosa que quisiera decir es que en el momento de escribir este artículo KDE lanza unas 3 versiones de Plasma al año, pero pronto lanzará 2, más o menos al mismo tiempo que GNOME y justo antes de las nuevas versiones de Ubuntu y Fedora.

Kubuntu LTS

La primera de las cuatro opciones es Kubuntu LTS. Es la opción más conservadora, la opción para los que prefieren software más probado y que recibirá más actualizaciones de mantenimiento. Salen cada dos años, y suelen usar una versión LTS de Plasma. No incluirá las últimas funciones, ni las últimas versiones de algunas aplicaciones, pero todo lo que hace lo hace de manera fiable.

LTS + Backports

Esta opción es un poco un unicornio, o bueno, no tanto, pero es que no es habitual. Hay ocasiones en las que KDE añade un repositorio backports especial para una versión LTS de Kubuntu concreta, y puede subir Plasma, Frameworks y Gear. Salvando las distancias, que pueden llegar a ser muchas, esto sería similar a lo que ofrece KDE neon: base LTS y el último software de KDE. Pero, insisto, no es normal que ofrezcan esta posibilidad ya que lo lógico es pensar que el que se queda en una versión LTS es porque no busca lo último de lo último.

Kubuntu Interim (ciclo normal)

Canonical se refiere a sus lanzamientos de ciclo normal como «interim», que se traduce al español como «provisional». Hay uno cada seis meses, en abril y octubre, y su soporte son esos seis meses más 3 de cortesía, para que nos dé tiempo a subir a la siguiente. En total, nueve meses de soporte.

Las versiones de ciclo normal llegan con el software de KDE que está disponible en el momento de la congelación de funciones, y suele usar, por ejemplo, las aplicaciones de diciembre más las tres actualizaciones correctivas en el lanzamiento de abril. El Plasma y Frameworks que incluyen es el que ha llegado a tiempo de la congelación, y no se actualiza aunque se haya lanzado una actualización de punto de la misma serie. Si se quiere software más nuevo, hay que esperar a la siguiente versión del sistema operativo.

Aquí me gustaría explicar algo sobre el cambio de ciclo de lanzamientos que llegará en cuanto Plasma 6 se estabilice. KDE lanzará esas dos versiones de Plasma al año, por lo que Kubuntu siempre tendrá la última versión del entorno gráfico de KDE, pero seguirá sin recibir actualizaciones de punto, a no ser que en Canonical cambien su filosofía. Es un dato importante porque hasta ese momento sí era habitual tener una versión de Plasma «pasada».

Interim + Backports

La última de las opciones es usar la última versión de Kubuntu y añadirle el repositorio backports. Es algo que se ha podido hacer desde ¿siempre?, pero esos dos lanzamientos de Plasma por año cambiarán un poco bastante las cosas. Si añadimos el backports ppa a una edición provisional de Kubuntu mientras KDE lanza tres versiones de Plasma al año y lanzan una nueva, Plasma dará un salto de versión, y esto no siempre puede dar el mejor de los resultados. Sin embargo, si ya estamos en la misma serie, lo único que se aplicará al entorno gráfico serán correcciones, por lo que es difícil que se experimenten fallos.

Por otra parte, y como antes de esos 2/año, Frameworks y Gear (apps) se actualizarán una vez al mes. Esta opción será la más actualizada de todas, superando al KDE neon propio del «equipo K», ya que usará el software más nuevo de KDE y la última base de Ubuntu, y seguiremos teniendo a Canonical detrás, para lo bueno y para lo malo. Esto último, lo del software más nuevo, podría no cumplirse siempre.

¿Cuál es tu opción preferida? ¿Prefieres la estabilidad de Kubuntu/Lubuntu/Ubuntu Studio LTS, la última versión con todo lo nuevo o algún punto intermedio?

from Linux Adictos https://ift.tt/IiYtG3S
via IFTTT

Linux Mint 21.2 «Victoria» mejora la interfaz de usuario y el soporte para aplicaciones no nativas, entre otras novedades

Linux Mint 21.2

Disponible desde el 21 de junio en forma de beta y en el servidor del proyecto desde hace unos días, ya se ha hecho oficial el lanzamiento de Linux Mint 21.2, que lleva el nombre en clave de «Victoria». Muchas de las novedades llegan de la mano de las nuevas versiones de los entornos gráficos en los que está disponible, mientras que otras tantas son compartidas por las tres ediciones, como su base y hasta cuándo estarán soportadas.

Linux Mint 21.2 continúa basándose en Ubuntu 22.04 LTS, y usa el kernel Linux 5.15 también LTS. «Victoria» estará soportada hasta 2027 y a continuación tenéis la lista de novedades compartidas entre las tres ediciones. Para conocer más sobre las que están relacionadas con los escritorios, podéis ir a nuestros artículos publicados en el momento de su lanzamiento: Cinnamon 5.8, Xfce 4.18 y MATE 1.26.

Novedades en Linux Mint 21.2 «Victoria»

Slick Greeter es el software que se encarga de mostrar la pantalla de inicio de sesión, y ha recibido soporte para múltiples capas de teclado. Podemos ver las diferentes capas y cuál tenemos seleccionada desde el indicador que está arriba a la derecha. En esta pantalla también se ha mejorado el soporte para el panel táctil, y la opción de tocar para hacer clic es detectada y activada automáticamente desde la pantalla de login.

El centro de software ha recibido mejoras visuales en al interfaz de usuario. La lista de aplicaciones destacadas se ha actualizado y ahora incluye flatpaks. El sistema de puntuación también se ha mejorado para dar más visibilidad a las nuevas apps de moda.

Pix es la herramienta de fotos, y ahora está basada en gThumb 3.12.2, lo que le ha permitido adoptar las últimas mejoras visuales. Entre otras cosas, usan barras de encabezado y botones en vez de barras de herramientas y de menú. Pix 3.0 llega con 168 nuevas funciones, y merece la pena leer una de las tres notas de lanzamiento (Cinnamon, Xfce o MATE) para ver una lista de las más destacadas.

Mejoras en la UI y UX

Linux Mint 21.2 ha introducido mejoras en la interfaz de usuario (UI) y en la experiencia (UX). Los iconos de las carpetas ya no muestran una línea. En su lugar, cada color ha recibido iconos de dos tonos (ver artículo relacionado anterior). Las variantes de los colores se introdujeron pensando en los colores populares, como los de Yaru.

Por otra parte, los mensajes de información o tooltips se veían diferentes dependiendo de donde provenían (GTK2, GTK3 o Cinnamon). También incluían un borde gris que no se veía bien sobre el amarillo de fondo. Todas estas inconsistencias se han arreglado. El equipo de desarrolladores que lidera Clement Lefebvre se basó en Adwaita e hizo estos mensajes de información más grandes, más redondeados y con márgenes de mayor tamaño.

Entre otros retoques visuales, las barras de título se han realineado y los iconos son monocromáticos. Una vez más, os remitimos al anterior artículo relacionado para ver algunas capturas, o a uno de los enlaces oficiales (aquí el de Cinnamon).

Linux Mint 21.2 soporta XDG Desktop Portal en XApp

Se ha añadido soporte para XDG Desktop Portal en XApp para las tres ediciones en las que está disponible. Esto mejora la compatibilidad entre diferentes entornos gráficos y aplicaciones no-nativas como las flatpak o apps de GNOME. Entre otras cosas, esto permite que estas apps puedan tomar capturas de pantalla y soporten el modo oscuro.

Otro soporte que se ha mejorado ha sido el de los gestos. Ahora se pueden gestionar con gestos del panel táctil las ventanas, los espacios de trabajo, el apilado y los controles multimedia. Entre el resto de mejoras, el menú principal ahora se puede redimensionar y se puede desactivar la notificación del nivel bajo de batería en dispositivos conectados.

Linux Mint 21.2 se puede descargar desde los diferentes espejos que hay disponibles en la página web oficial. Si lo preferís, también se pueden descargar haciendo clic en uno de los tres botones que tenéis a continuación. Pronto publicaremos otro artículo que recogerá la manera oficial de actualizar desde versiones anteriores.

.botones {display: inline-block; margin: 5px; justify-content: center;} .botones input {color: white; background-color: gray; padding: 20px; font-size: 2rem; text-decoration: none; border-radius: 10px; position: relative; top: 15px; border: 4px solid #555} .botones input:hover{box-shadow:1px 1px 2.5px black}

from Linux Adictos https://ift.tt/C3LFuZb
via IFTTT

Primera demanda contra un buscador basado en Inteligencia Artificial

Segunda demanda contra la IA

Ayer Pablinux nos advertía sobre el cuidado que hay que tener con las respuestas que de Bard, la herramienta de Inteligencia Artificial de Google. Parece que, por el lado de Microsoft, su buscador Bing y ChatGPT la cosa no va mucho mejor ya que son los protagonistas de la primera demanda contra un buscador basado en Inteligencia Artificial.

Los buscadores ya han sido denunciados en diversos países por los resultados que mostraban. En algunos casos los tribunales los absolvieron y en otros los hicieron responsables de indexar material publicado por terceros. Pero, ahora nos enfrentamos a una situación para la que no existen precedentes.

La primera demanda contra un buscador basado en Inteligencia Artificial

Todo empezó cuando a alguien se le ocurrió buscar en Bing, el buscador de Microsoft que utiliza la tecnología detrás de ChatGPT a  Jeffery Battle. El tema es que hay dos lo suficientemente importante para aparecer en los buscadores.

Uno es un respetable dirigente de empresa y profesor universitario retirado con honores de la fuerza aérea de Estados Unidos, el segundo, que además tiene el segundo nombre de Leon está preso por querer unirse a terroristas islámicos.

Para Bing, sin embargo, es el buen profesor el que está preso por querer unirse al talibán. Y, lo de «sin embargo» es literal. Se trata de la transición elegida por la IA para unir las dos biografías dando a entender de manera inequívoca que se trata de la misma persona.

El profesor Battle presentó la demanda por difamación y está tan seguro de su éxito que decidió prescindir de abogado, algo que la legislación de ese país permite.  Aunque, los analistas no están tan convencidos de las posibilidades.

De acuerdo con la legislación estadounidense:

Ningún proveedor o usuario de un servicio informático interactivo será tratado como editor o altavoz de cualquier información proporcionada por otro proveedor de contenidos de información»

Pero, el demandante argumenta que no solo informó a Microsoft del problema, al procesar la información pierde la inmunidad de cita para convertirse en emisor.

Esta es la segunda demanda contra una herramienta de Inteligencia Artificial, La primera, dirigida contra OpenAI es por proporcionar información falsa sobre una demanda.

El acusado al que nadie acusó

Fred Riehl es un periodista que decidió suscribirse a ChatGPT para hacer más fácil su trabajo.  Un día decidió pedirle a la herramienta que le hiciera un resumen sobre una demanda y le suministró el enlace donde podía encontrarla, estamos hablando del enlace oficial del demandante.

La respuesta fue que la demanda consistía en acusar a un ex-director financiero (Al que nombra) por malversación de fondos. El problema es que esa persona jamás ocupó ese cargo y la demanda no tiene nada que ver con malversación de fondos.

Riehl, que supongo que sabía de qué trataba la demanda, le pidió que citara el párrafo correspondiente en el que se acusaba a Walters, cosa que para su sorpresa ChatGPT hizo.

Cuando el periodista le pidió que mostrara la demanda completa, ChatGPT produjo un texto que nada tiene que ver con la original, ni siquiera el número de caso coincidía.

De todas formas, según los expertos la posibilidad de que el señor Walters gane la demanda es dudosa. El delito de difamación requiere que:

  • El demandante puede demostrar que el demandado actuó a sabiendas de que la declaración era falsa, o sabía que la declaración podía ser falsa, pero por negligencia omitió actuar en base a este conocimiento.
  • El demandante puede probar que se vio perjudicado por la declaración. Ejemplos de esto sería pérdida de trabajo, pérdida de relaciones familiares o comerciales.

En la web de ChatGPT, al menos en su versión gratuita se advierte de que los resultados pueden tener errores. Si OpenAI está enterada de la magnitud que pueden tener esos errores deberá probarse.  Lo que es seguro es que por el momento no pienso cambiar a mi abogado por una IA, ChatGPT no parece capaz de evitar que la demanden.

from Linux Adictos https://ift.tt/jiRDm9Z
via IFTTT

La niñera y la macro de Excel

El uso de Inteligencia Artificial en la creación de contenidos puede no ser una buena idea.
Hemos comentado en este respetable blog la forma en que la realidad interna y externa se combinan para sugerir el tema del artículo. Es el caso de la niñera y la macro. La niñera en cuestión es la actriz Fran Drescher ahora en su rol de presidenta del sindicato de actores y la macro es una macro de Excel que, a pesar de todas las seguridades de ChatGPT de que lo haría correctamente.

¿Cuál es el punto en común? La viabilidad de la Inteligencia Artificial para reemplazar al trabajo humano

La idea de que una tecnología sea capaz de reemplazar al trabajo humano no es nueva.  Personalmente he visto en revistas de principios del siglo pasado artículos asegurando que el cine sería el reemplazo de los maestros. Lo mismo se dijo de la televisión, los vídeos y los ordenadores. Estoy seguro de que en alguna parte de los archivos del Vaticano debe haber algún informe firmado por un Cardenal calculando cuánto se van a ahorrar en monjes copistas gracias a la imprenta.

Hasta el momento eso nunca resultó, al menos en términos de reducción de costos. Las nuevas tecnologías necesitaron de profesionales especializados que terminaron cobrando mucho más.

La niñera y la macro

Fran Drescher, la histórica protagonista de la serie The Nanny, es la presidenta de SAG-AFTRA. Del otro lado está la AMTP que involucra a ls principales productoras de contenido para cine, televisión y streaming. Ambas entidades estaban en negociaciones, por un lado, por un tema que ya lleva tiempo entre nosotros, cómo repartir las ganancias de los servicios de streaming. Por el otro, uno nuevo. La forma en que la Inteligencia Artificial puede impactar en el trabajo de los actores.

Los estudios proponen que, si un actor trabaja un día, ellos pueden escanear y usar la imagen de un actor por toda la eternidad.

A los guionistas por su lado no les gusta la idea de ser reemplazados por una máquina que sea entrenada con sus trabajos previos.

No faltó el chistoso que dijo que los próximos en ser reemplazados por la Inteligencia Artificial son los ejecutivos de los estudios y los espectadores.

La macro que se negó a funcionar

Me tocó comparar dos hojas Excel con más de un millón de filas cada una. Ninguna de las alternativas para Linux puede trabajar bien con ellas y, mi intento anterior de usar pandas con Python fracasó. Por lo tanto, decidí usar Excel y pedirle a ChatGPT que me escribiera una macro en Visual Basic que comparara cada valor de una determinada columna de la primera hoja con una determinada columna de la segunda hoja y, en caso de no encontrar coincidencia, pegara la fila completa en la tercera hoja.

Por más que lo intenté de múltiples maneras posibles fui incapaz de hacerle entender que la comparación debía hacerse con toda la columna de la segunda hoja y no solo con los valores de la misma fila.

Finalmente, copie cada columna en un archivo de texto, creé un script en Pyhton para que hiciera la comparación y guardara el resultado en otro archivo de texto. Finalmente copié el resultado del archivo de texto en Excel y logré hacerle entender a ChatGPT que escribiera una macro que buscara los valores y copiara las filas correspondientes.

Tuve un profesor que decía que su gran habilidad profesional era en que parte de la biblioteca buscar la respuesta. Algo parecido siento con las herramientas de Inteligencia Artificial.  Si tengo conocimiento de lo que le estoy preguntando obtengo respuestas útiles, pero, si voy a ciegas me cuesta encontrar respuestas que sean aprovechables.

Mi impresión es que las películas escritas y protagonizadas por Inteligencia Artificial van a ser malísimas y van a fracasar. No solo por sus repetitivos y chatos argumentos sino porque los costos de los ordenadores y el software utilizado para generarlas (Mayormente privativo) superará al de las producciones tradicionales.

La Inteligencia Artificial podría aportar mucho al mundo del espectáculo, pero como complemento, no cómo reemplazo del talento humano.

from Linux Adictos https://ift.tt/8Blb5qL
via IFTTT

Google Bard aprende español en su última actualización, pero mucho cuidado con sus respuestas

Google Bard en español

«Bard puede mostrar información poco precisa u ofensiva que no represente el punto de vista de Google«, pero a eso volveremos más adelante. Google Bard se ha actualizado y entre sus novedades tenemos que ha aprendido español. Para que podamos usarlo desde la unión europea, Google ha tenido que mejorar el apartado de la privacidad, motivo por el cual hemos tenido que esperar tres meses para poder usar el chatbot de la compañía del buscador más usado del mundo.

Las otras lenguas de la Comunidad Europea tendrán que seguir esperando. Le he preguntado a Bard qué tanto por cien de estadounidenses habla español y me ha dicho que «Según el Censo de los Estados Unidos de 2020, el 18,5% de la población estadounidense habla español en el hogar. Esto es equivalente a unos 62 millones de personas. El español es el segundo idioma más hablado en los Estados Unidos, después del inglés.» en lo que sin lugar a dudas es el motivo por el que somos los primeros europeos en tenerlo en nuestro idioma.

Novedades de Bard

Debajo de la caja de texto del chat hay un nuevo apartado Política de Privacidad, y esta novedad, junto a un centro de ayuda de privacidad, es lo que ha permitido que este chatbot aterrice en Europa. OpenAI también tuvo que hacer cambios en este sentido, pero después de estar disponible. De no haberlos hecho, la CE amenazaba con prohibir su uso en este territorio. También contamos con una página de actividad desde donde podremos borrar los datos almacenados y programar una eliminación automática.

Eliminar datos del chatbot

En cuanto a novedades en forma de funciones, ahora hay un icono con forma de altavoz a la derecha de las respuestas que nos permite escuchar las mismas; hay nuevas maneras de mostrar la información, pero yo no las he podido activar en español; posibilidad de organizar y anclar conversaciones; posibilidad de exportar el código a servicios como Google Colab o Replit; Integración con Google Lens; y posibilidad de compartir las conversaciones.

Poca precisión, incluso si intentas corregirle

Cómo habíamos explicado al principio, Bard avisa de que puede mostrar información poco precisa, y eso es algo que hay que tener en cuenta si nos estamos planteando usar el chatbot como sustituto de los buscadores. Como ejemplo, lo que ha pasado en la captura de pantalla (no sé si se podrá leer bien): muspy me ha informado esta mañana de que Metalite lanza un nuevo disco en 2024, por lo que pregunto «¿cuándo sale el próximo disco de Metalite?» y me responde que el 27 de enero de 2024. Empezamos mal. Sale el 19.

Le pregunto por la próxima carrera de F1 y me dice que el 31 de julio en Hungaroring. Como no lo tenía claro se la he dejado pasar, pero he mirado el calendario y no, es el día 21 en el mismo circuito. Así que le pregunto por algo que tenía más claro, por cómo quedó Alcaraz ayer, partido que vi, y me ha dicho que perdió en el torneo de ¿Queens?. Le corrijo, que ayer jugó Wimbledon, y me da la razón, pero me dice que perdió contra Rune, le digo que ganó y luego me dice que no, que «Carlos Alcaraz perdió ante Jannik Sinner en los cuartos de final de Wimbledon 2023 por 6-3, 6-1, 6-4. Alcaraz hizo un buen esfuerzo, pero Sinner fue demasiado fuerte«. ¿Sinner?

Se esperan mejoras

Así que cuidado. La prueba anterior era para comparar a Bard con ChatGPT, quien tiene información limitada a partir de septiembre de 2021. Es una limitación importante que impide hacer consultas de temas de actualidad, pero Bing y Bard no deberían tenerla. Las propuestas de Microsoft y Google deberían poder responder a cuestiones como cuándo va a salir un disco de música, pero la falta de precisión hacen que en la actualidad no podamos confiar en ellas; merece la pena buscar en medios especializados.

Esto cambiará en el futuro, pero ahora mismo lo que tenemos son más «cuñados» que otra cosa. Es relativamente preocupante la autoridad con la que responden: si no dominamos un tema, nos la pueden liar. Pero a partir de hoy ya nos la liarán en español.

Enlace al chatbot de Google.

from Linux Adictos https://ift.tt/HjWMugQ
via IFTTT

¿A qué está jugando IBM?

Nos preguntamos a qué juega IBM

En los últimos tiempos, CentOS, Red Hat y Fedora han sido noticia por medidas que tomaron o piensan tomar. Tanto nosotros como el resto de los blogs las hemos comentado. Sin embargo, creo que estamos concentrándonos demasiado en las marionetas y olvidándonos del titiritero. Buen momento para preguntarse ¿A qué está jugando IBM?

Voy a jugar limpio con ustedes advirtiendo que este post tiene más preguntas que respuestas. Si fuera al revés no estaría escribiendo en Linux Adictos sino ganando fortunas en el Nasdaq.

Hablemos del elefante en los repositorios

Hay una vieja parábola que algunos rastrean hasta la antigua Persia o India que cuenta los siguiente:

Seis sabios no videntes quisieron vivir por sí mismos la experiencia de tratar con un elefante valiéndose de su sentido del tacto. El primero, como no sabía a qué distancia estaba y chocó con el animal concluyendo que este era como una pared.  El segundo extendió la mano, tocó el colmillo duro, agudo y afilado y concluyó que era como una lanza.  El tercero palpó la trompa y a partir de ese momento asumió que los paquidermos eran como una serpiente.  Notando la fortaleza y el grosor de su pata el cuarto decidió que era como el tronco del árbol. Al quinto, la oreja le sugirió la semejanza con un abanico mientras que el sexto palpando la cola entendió que el elefante tenía forma de soga.

La moraleja de esto es que, si olvidamos que Red Hat es propiedad de IBM, y que CentOS y Fedora son proyectos financiados y controlados directa o indirectamente por personal de Red Hat (Al igual que la Fundación GNOME, el servidor gráfico Wayland y el formato de paquetes Flatpak) estamos procediendo como los ciegos.

Las partes del elefante

Algunas de las decisiones posibles o futuras de las que hablamos son:

  • Incluir telemetría en Fedora: Existe una propuesta para que a partir de la versión de escritorio de Fedora 40 se recojan datos en forma anónima para «Lograr objetivos específicos de mejora». En la propuesta se habla mucho de garantizar la privacidad del usuario evitando construir perfiles de uso o la filtración a las empresas que lucren con ellos.  Los datos recogidos solo se procesarán en la infraestructura de Fedora (Nota mía: ¿A qué no adivinan quién provee la infraestructura? Todavía no se sabe que información se recopilará, pero se especula con que podría ser el entorno de escritorio, tipo de hardware, ubicación geográfica e impacto de las recomendaciones del Centro de software. Por defecto, la opción de envío de datos estaría activada.
  • CentOS: La primera y más polémica medida después de la compra de Red Hat fue transformar CentOS de una versión sin soporte comercial de Red Hat Enterprise Linux (Lo que lo transformaba en la opción preferida de muchos proveedores de alojamiento web y servicios en la nube) en un banco de pruebas de lo que posteriormente se convertirá en la distribución de pago. Cuando aparecieron muchos forks, la empresa del sombrero rojo optó por liberalizar las condiciones en que su distribución se puede usar en forma gratuita. Para hacerle la cosa más difícil a sus competidores, acaba de restringir el acceso al código fuente de RHEL a sus clientes y asociados.
  • Adios a LibreOffice: Red Hat Enterprise Linux no incluirá en un futuro a la suite ofimática de código abierto. Esto se debe a que ya no tienen a quién se ocupe de crear los paquetes necesarios. (Eso se debe a que lo despidieron, cosa que olvidaron mencionar en el comunicado).

¿A qué está jugando IBM?

Todas estas medidas no son necesariamente malas. Ubuntu incluye telemetría y yo la tengo activada, claro que Canonical no tiene las conexiones políticas ni depende tanto de su relación con los gobiernos como IBM, Lo de CentOS es solo ponerles las cosas más difíciles a los competidores, particularmente Oracle, pero, como ya fueron cubriendo mis compañeros, no se trata de obstáculos insalvables.

Podríamos ponernos conspirativos y recordar que cuando fue la división del proyecto, IBM apoyó decididamente al grupo remanente en OpenOffice.  Pero, creo que la razón es más en concentrar los esfuerzos en aquellas actividades que generan valor para sus clientes.

La respuesta a la pregunta del título es que IBM compró Red Hat para ganar dinero y, todas las decisiones que tomen Red Hat, CentOS y Fedora van en ese sentido.  No es necesariamente perjudicial para los usuarios. Tenemos dos distribuciones de calidad y no tenemos que pagar las facturas.

from Linux Adictos https://ift.tt/qGLnUiR
via IFTTT