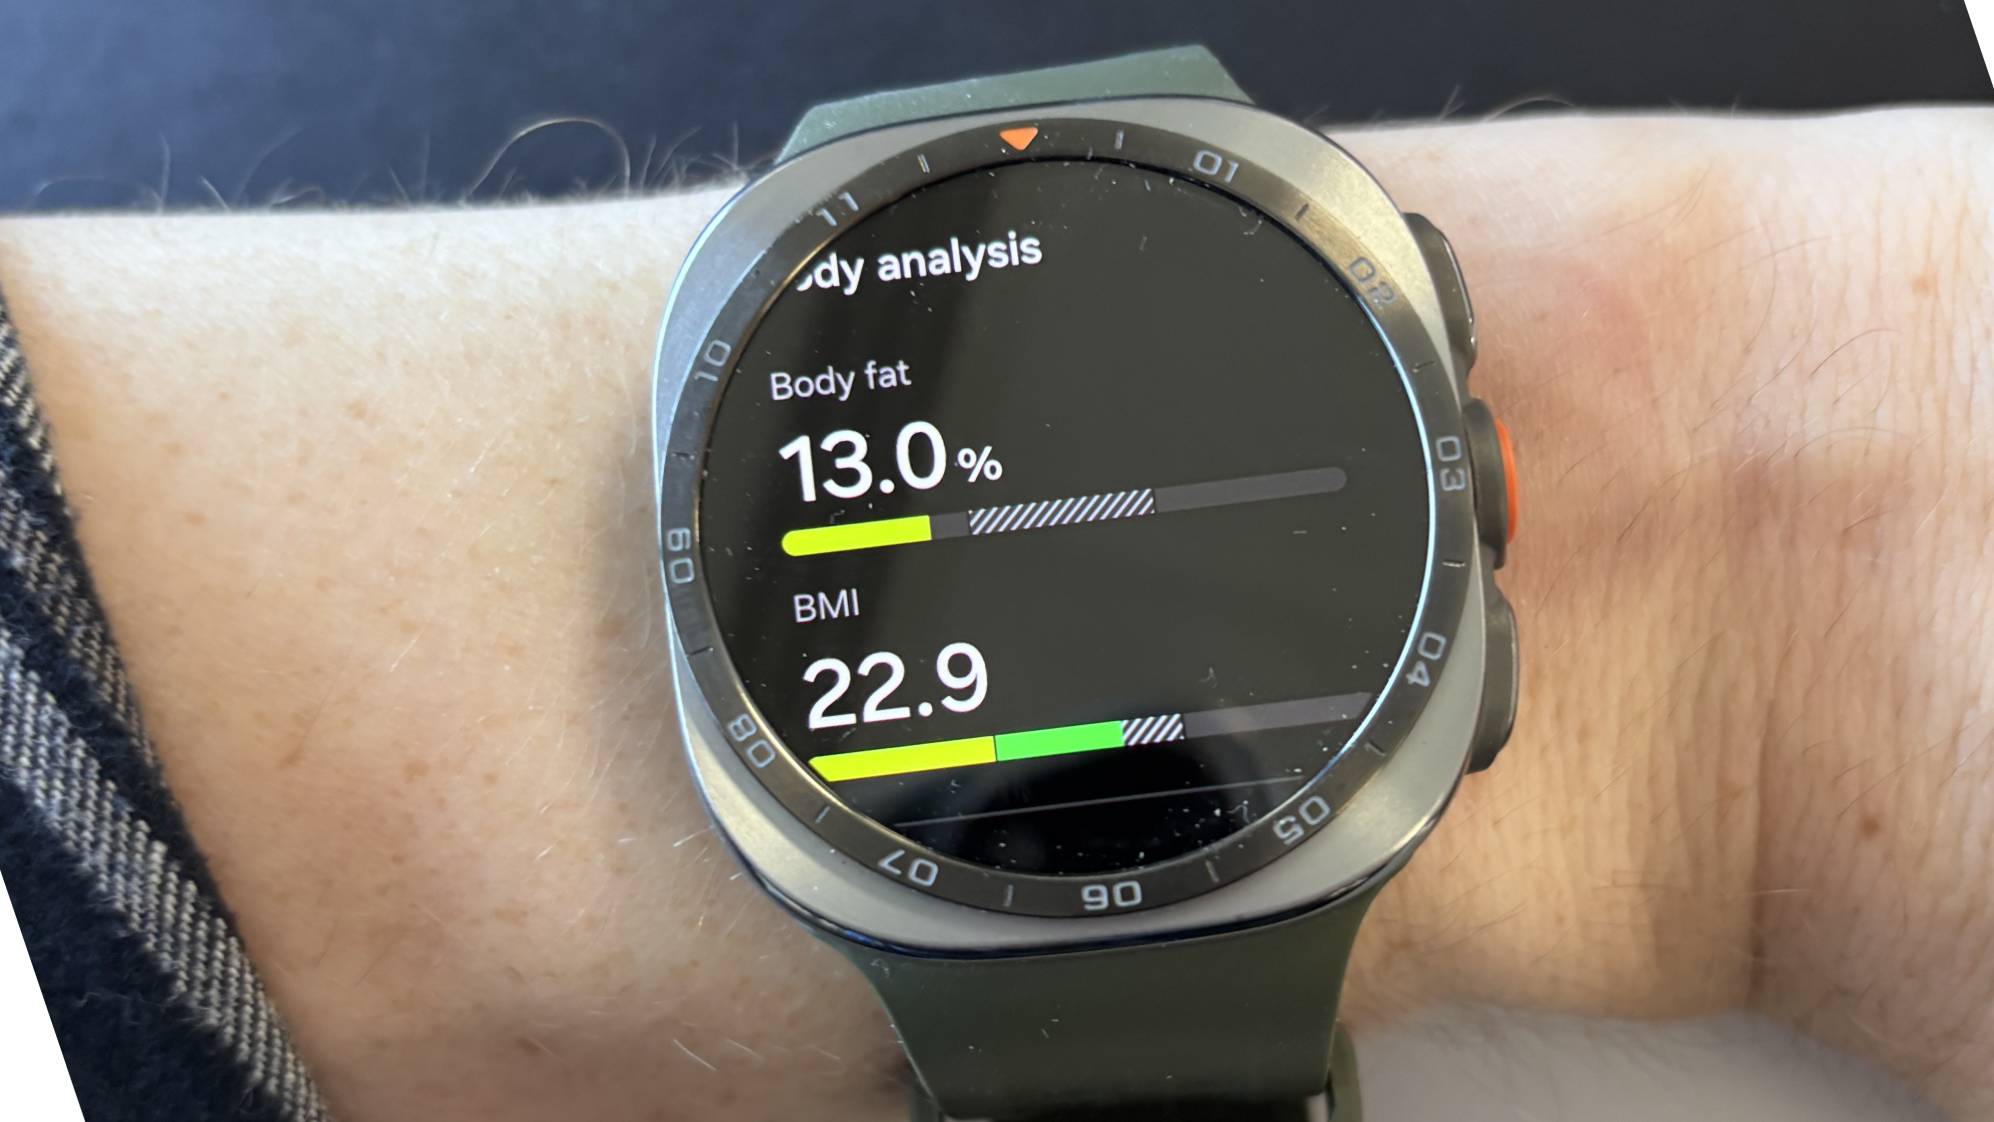
La RunStar 4E Body Scale llega como una balanza inteligente asequible que ofrece un conjunto impresionante de métricas por un precio muy razonable. Con más de 20 métricas de composición corporal reportadas, su valor relativo aumenta al compararlo con modelos más costosos. Sin embargo, como era de esperarse a este rango de precio, presenta limitaciones notables en la precisión de algunas mediciones, especialmente cuando se trata de desglosar grasa frente a músculo.
Diseño y uso: la experiencia de configuración y uso es fluida y directa. La conectividad Bluetooth es robusta, y la opción de crear múltiples perfiles dentro de la app es especialmente útil para familias. En la práctica, la balanza mide el peso con una desviación moderada (aproximadamente 0.4%) respecto a modelos más caros como la RunStar 8E SmartScan Pro, una variación que, para la mayoría de usuarios, no resulta determinante. El método de medición corporativo se basa en bioimpedancia eléctrica (BIA) a través de cuatro sensores metálicos en la tapa superior.
Precisión y métricas: mientras que el índice de masa corporal (IMC) tiende a ser bastante estable y cercano al valor obtenido por modelos más caros, la mayoría de las demás métricas presenta desviaciones que oscilan entre el 3% y el 30%. Por ello, no es la mejor opción para quienes buscan un análisis detallado de grasa, músculo y distribución en el cuerpo. Aun así, para quienes desean un recuento rápido de peso y una estimación de IMC, la RunStar 4E cumple con creces.
Especificaciones y diseño: la balanza, de vidrio templado de 6 mm, es compacta (11.02 x 11.02 x 0.78 pulgadas) y ligera (aprox. 3.17 libras). Su display LCD ofrece gráficos en color y muestra seis métricas clave de forma cíclica: peso, grasa corporal, IMC, masa muscular, agua corporal y masa ósea. Aunque no es posible seleccionar un metric específico desde el propio equipo, la app Starfit RunStar presenta la lista completa.
Batería y conectividad: funciona con 3 pilas AAA y ofrece conectividad Bluetooth para sincronización con la app. Si bien la carga USB-C sería una mejora ecológica, el consumo de la balanza es bajo y las pilas no requieren cambios frecuentes.
Rendimiento y experiencia de la app: el rendimiento en la app es rápido; la recopilación de datos y la presentación de resultados es ágil tanto en el dispositivo como en la app. No obstante, hay métricas muy específicas (p. ej., grasa visceral, composición muscular detallada) que muestran variabilidad entre lecturas y frente a equipos más caros.
Precio y disponibilidad: en torno a 33,54 USD / 31,00 GBP, la RunStar 4E es una opción excepcionalmente asequible. No está disponible en Australia. En el ecosistema de escalas, existen alternativas como la Vitafit Smart Bathroom Scale (precio similar) o la RunStar 8E SmartScan Pro, que ofrece más métricas y un desgloses más detallados, pero a mayor costo.
Conclusión: ¿deberías comprarla? Sí, si buscas una balanza inteligente de bajo costo que ofrezca un conjunto sólido de métricas y una buena experiencia de usuario, especialmente para vigilar el peso y obtener un IMC razonablemente preciso. No la recomendaría si tu prioridad es un análisis detallado con alta precisión en métricas como grasa visceral o masa muscular específica. Para usuarios que requieren un ecosistema de salud más amplio, quizá convenga evaluar opciones dentro de un rango de precio mayor.
Notas para el comprador: considera las alternativas más completas si tu objetivo es un análisis corporal más exhaustivo; la RunStar 4E funciona como una buena herramienta de monitoreo diario de peso y de variaciones en IMC, con la conveniencia de múltiples perfiles para familias.
En el mundo de las tarjetas gráficas de alto rendimiento, la preocupación por posibles fallas en el conector 12VHPWR ha estado presente desde hace tiempo. Recientemente, un desarrollador ha creado una utilidad de código abierto para Windows destinada a las tarjetas Asus Astral RTX 5090 y 5080, cuyo objetivo es monitorizar el consumo por pin y apagar la PC si algún pin mantiene un exceso de corriente durante un periodo prolongado. El resultado es una herramienta ligera y autónoma que actúa como una última línea de defensa ante posibles sobrecargas que podrían derivar en daños en el conector.
El creador, Humza Khalid, explica que la utilidad lee la corriente 12VHPWR directamente desde el sensor de la propia tarjeta y que, de detectarse que un pin supera los 9.5 A durante 15 segundos, se fuerza un apagado seguro del sistema para evitar desastres. Además, el objetivo es que la aplicación sea fácil de usar y no requiera cambios complejos en el sistema. En futuras versiones, se planea sustituir el apagado por una reducción del límite de potencia a través de la API de gestión de Nvidia, para obtener una respuesta más rápida.
Importa destacar varias consideraciones importantes: este enfoque solo funciona con las tarjetas Asus Astral 5080/5090, ya que son las únicas que disponen de sensores por pin; está disponible solo para Windows y requiere Python; y no reemplaza una instalación correcta del conector ni el uso adecuado del hardware. Se presenta como una medida adicional, no como la primera línea de defensa.
La herramienta ha suscitado debates sobre el nivel de preocupación entre los usuarios de GPUs Nvidia de alto rendimiento. En los comentarios de la publicación, algunos usuarios señalan que la tarjeta podría ser objeto de paranoia, mientras otros comparten experiencias con incidentes de sobrecalentamiento o desastres respecto al conector. Si bien gran parte de estas historias son anecdóticas, destacan la atención que estas cuestiones generan en la comunidad.
Como siempre, antes de instalar software de terceros de orígenes no verificados, es prudente evaluar riesgos y beneficios. Aunque la herramienta es de código abierto, lo que aporta transparencia sobre sus operaciones, la responsabilidad de la instalación recae en el usuario. En particular, se recomienda preferir soluciones respaldadas por los fabricantes y, cuando se trate de herramientas no oficiales, proceder con cautela y consultar experiencias de otros usuarios.
En resumen, la existencia de esta utilidad subraya una preocupación real entre los usuarios de GPUs de alta gama. Mientras algunos ven en ella una capa adicional de seguridad, otros advierten sobre la necesidad de soluciones de hardware y prácticas de ensamblaje adecuadas para evitar incidentes de manera proactiva. La conversación continúa y refleja la diversidad de enfoques que la comunidad adopta ante la compleja interacción entre potencia, conectores y rendimiento.
Imagine asistir a una manifestación pacífica, solo para que cámaras ocultas escaneen su rostro, igualen su identidad y registren sus datos en una base policial en cuestión de segundos. Este escenario se sitúa en el centro de un debate que se reavivó en Italia la semana pasada, evidenciando un choque de alto riesgo entre seguridad pública y privacidad personal.
Desde Londres y París hasta Ámsterdam y Berlín, las fuerzas de seguridad de democracias europeas están pilotando cada vez más el reconocimiento facial impulsado por IA en espacios públicos y en protestas políticas.
Aunque los líderes europeos enmarcan la tecnología como una herramienta necesaria para combatir el crimen, defensores de la privacidad advierten que el reconocimiento facial genera un efecto disuasorio sobre el derecho a la reunión pacífica y la libre expresión. Y el riesgo a largo plazo podría ser aún más inquietante: una vez normalizada la tecnología, ampliar su alcance podría convertirse en el siguiente paso natural.
Cómo usan la policía en Europa el reconocimiento facial en protestas
La tecnología de reconocimiento facial (FRT) es una herramienta biométrica que utiliza IA para identificar personas analizando su geometría facial —como la distancia entre los ojos o la silueta de la mandíbula— contra una base de datos. Este software crea una firma digital única, a menudo llamada “faceprint”, que puede integrarse directamente en redes de CCTV, drones, aplicaciones y unidades móviles policiales.
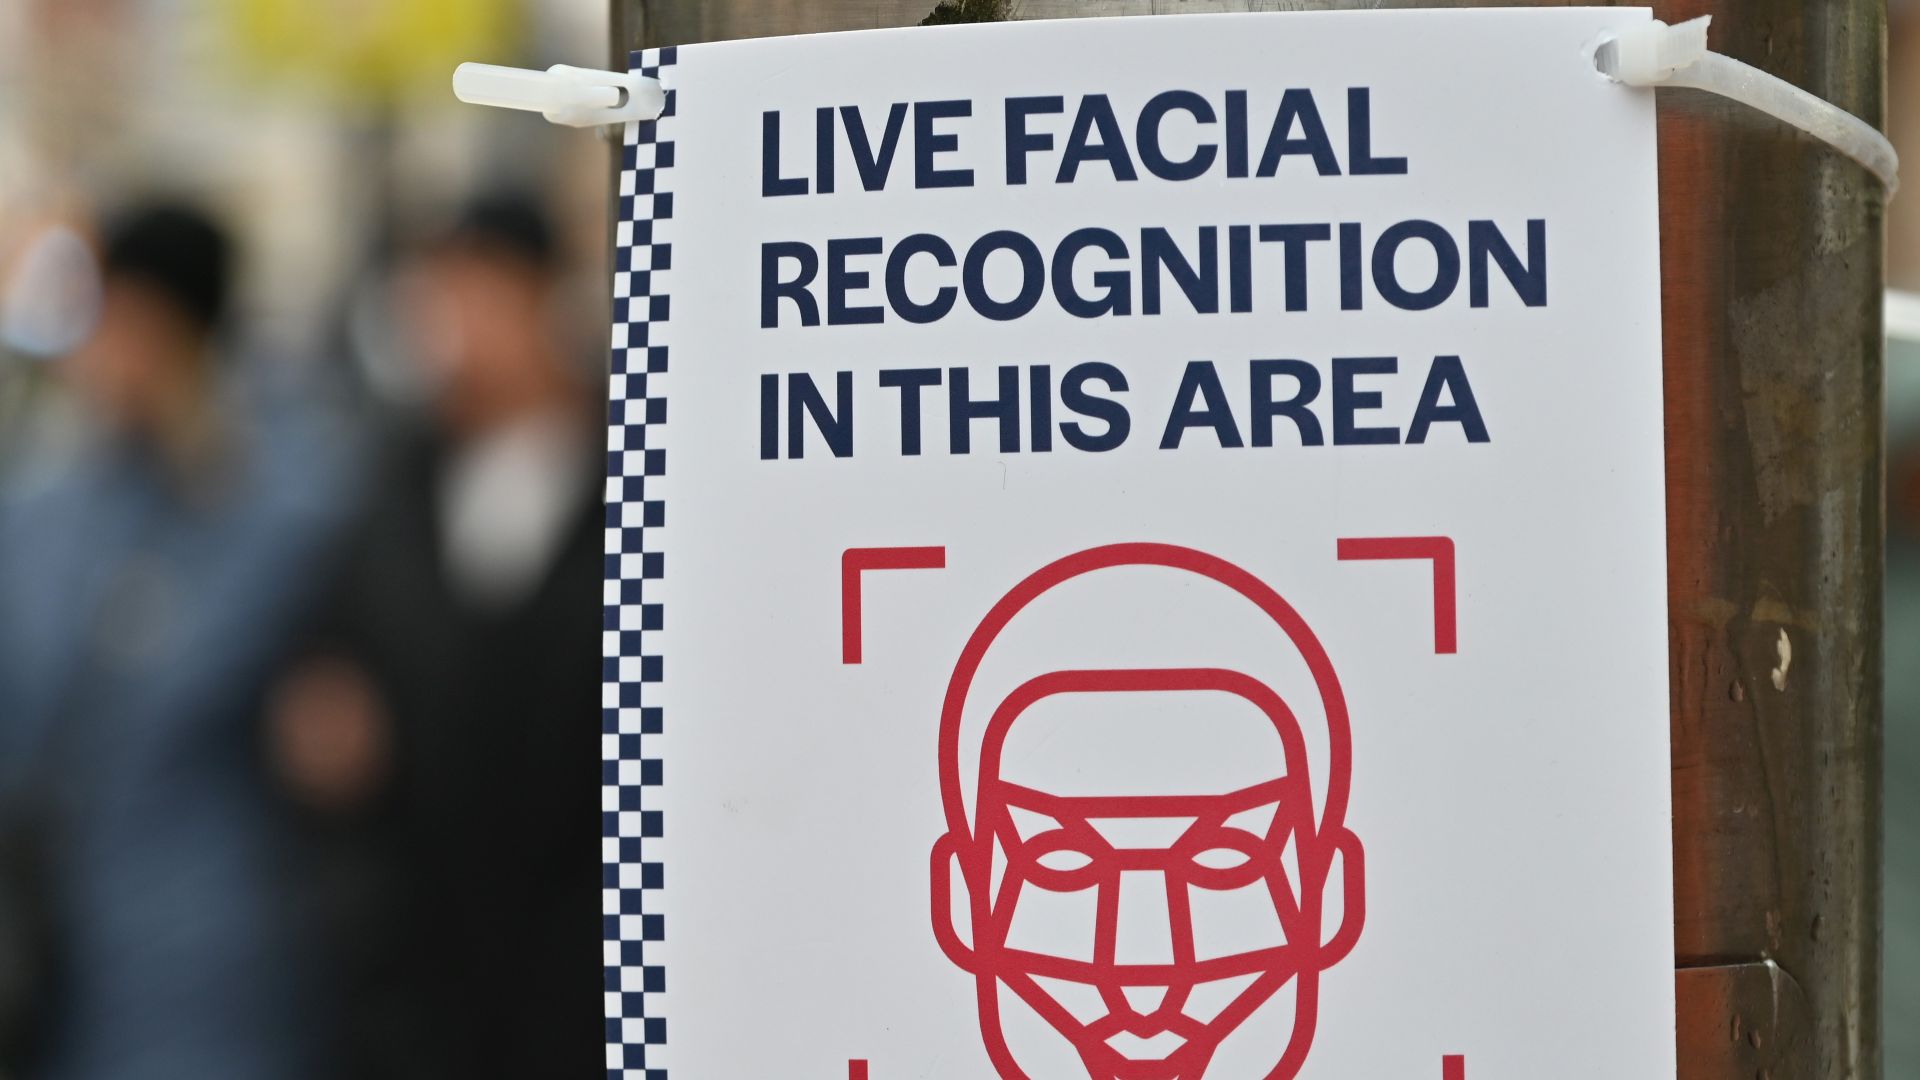
La seguridad despliega la FRT de varias formas, siendo el reconocimiento facial en tiempo real (LFR) la más controvertida. El LFR escanea feeds de vídeo en tiempo real para cruzar referencias con listas de vigilancia policial casi instantáneamente.
De manera similar, las autoridades húngaras usaron escaneo biométrico para vigilar a los participantes durante la Marcha del Orgullo de Budapest en 2025.
(Image credit: Photo by John Keeble/Getty Images)
En contraste, el reconocimiento facial retrospectivo (RFR) funciona más como una huella dactilar tradicional. En lugar de escanear multitudes en vivo, la policía analiza imágenes grabadas o fotografías tras un evento para identificar posibles sospechosos.
Esta es la tecnología que los legisladores italianos intentaron regular la semana pasada, aunque fuerzas policiales de Reino Unido, Francia, Países Bajos y otras naciones europeas ya lo utilizan de manera rutinaria.
A primera vista, el RFR podría parecer menos intrusivo —simplemente otra herramienta de investigación para usar cuando sea necesario. Sin embargo, expertos en derechos humanos consideran que la distinción es engañosa.
Según Chloé Berthélémy, consejera principal de políticas en la red europea de derechos digitales EDRi, la diferencia entre el reconocimiento en tiempo real y el escaneo posterior es “en gran medida una distinción procesal.”
Berthélémy advierte también sobre el surgimiento de la Vigilancia de Video Algorítmica (AVS) —un sistema que etiqueta comportamientos sospechosos o peligrosos en tiempo real—, el cual describe como “fundamentalmente poco confiable.” A diferencia del reconocimiento facial, la AVS no registra rasgos faciales; se entrena para detectar anomalías conductuales y señales físicas, como aumentos repentinos de multitudes, equipaje desatendido, armas, incendios o caídas de individuos.
Los Juegos Olímpicos de París 2024 sirvieron como campo de pruebas de esta tecnología, convirtiendo a Francia en el primer estado miembro de la UE en legalizar la analítica de vídeo con IA.
Qué dice la ley europea sobre el reconocimiento facial y nuestro derecho a la privacidad
Aunque la tecnología de reconocimiento facial supone un riesgo para la privacidad, los marcos legales explícitos que regulan su uso siguen siendo escasos.
A pesar de casi una década de pruebas policiales, el Reino Unido aún carece de legislación específica sobre el reconocimiento facial —un vacío legal que advierte Jasleen Chaggar, responsable legal y de políticas en Big Brother Watch, como un “vacío legal real.”
Chaggar explicó aTechRadar que las fuerzas policiales británicas se apoyan en una mezcla de precedente jurídico común, leyes de protección de datos existentes y legislación de derechos humanos más amplia.
Aunque el Comité de Derechos Humanos de las Naciones Unidas instó al Reino Unido a terminar con la vigilancia facial policial en protestas, Chaggar señala que los gobiernos han resistido la regulación estatutaria, citando “independencia operativa” de la policía.
“Esto ha otorgado efectivamente a la policía una cuerda muy larga para experimentar con estas tecnologías,” dijo Chaggar a TechRadar. “Y ahora estamos en un punto de inflexión donde se expandirá por todo el país, y hay una necesidad real de que existan marcos legales.”
❌We don’t consent to biometric ID checksPolice will be using live facial recognition at @boardmasters festivalThis tech doesn’t just record what you do, your face becomes a barcode in the same way as your fingerprint or DNA#StopFacialRecognition⤵️https://t.co/9do8SIF81t pic.twitter.com/VSgXMTuX1YAugust 6, 2026
En contraste, el Código de la IA de la Unión Europea establece un marco legislativo vinculante en todos los estados miembros. Aunque ofrece mayor claridad legal que el enfoque del Reino Unido, los defensores de derechos digitales lo interpretan como una victoria parcial.
Dr. Matt Mahmoudi, líder de campaña de la iniciativa ‘Ban the Scan’ de Amnistía Internacional, advierte que no promulgar una prohibición total de la vigilancia biométrica en espacios públicos crea excepciones de seguridad nacional amplias que amenazan derechos fundamentales.
“Y no es solo el derecho a la privacidad. No es solo el derecho a protestar y a la libertad de asamblea y expresión. También es el derecho a la igualdad y a no discriminación,” declaró Mahmoudi a TechRadar.
¿El fin del dissenso anónimo?
Antes de desplegar la tecnología de reconocimiento facial en espacios públicos, los ciudadanos que asistían a manifestaciones podían contar con un grado de anonimato práctico. la biometría transforma fundamentalmente esa expectativa.
Expertos en derechos digitales coinciden en que este nivel de intrusión erosiona gradualmente el espacio cívico. El conocimiento de que su cara está siendo escaneada y cruzada con una lista de vigilancia policial disuade a las personas de asistir a manifestaciones.
“Puede decidir no ejercer sus derechos democráticos por miedo a cómo podría percibirse por las autoridades,” explicó Jasleen Chaggar de Big Brother Watch.
Sin embargo, este efecto disuasorio se extiende más allá de las cámaras desplegadas en una protesta concreta. La tecnología de reconocimiento facial no opera aislada: depende de una extensa recopilación de datos, a menudo encubierta. Para construir listas de vigilancia, las autoridades agregan imágenes de diversas fuentes, que incluyen perfiles de redes sociales, bases de datos de identidad gubernamentales, fotos de detención policial, archivos de CCTV y bases de datos biométricas comerciales.
(Image credit: HQuality / Shutterstock)
Como explica el Dr. Mahmoudi de Amnistía Internacional, la agregación extensa de datos transforma rastros digitales cotidianos en una red de vigilancia omnipresente.
“La reconocimiento facial no es una simple tecnología, sino un sistema que efectivamente arma tu vida diaria,” afirmó Mahmoudi a TechRadar.
Aparte de las preocupaciones de privacidad básicas, la tecnología subyacente sigue mostrando sesgos. Durante ocho pruebas piloto llevadas a cabo por la Metropolitan Police entre 2016 y 2018, el 96% de las alertas iniciales fueron falsas.
Investigaciones académicas y auditorías independientes muestran de forma consistente que estas inexactitudes algorítmicas afectan desproporcionadamente a personas no blancas, mujeres y minorías étnicas.
El coste humano de estos errores algorítmicos quedó claro en 2024, cuando oficiales de la Metropolitan Police detuvieron a Sean Thompson —un activista negro contra la violencia armada— tras que la herramienta de reconocimiento facial en vivo coincidiera falsamente con una persona de la lista de vigilancia.
Aunque los algoritmos han avanzado, los defensores de la privacidad subrayan que las limitaciones inherentes siguen ahí. Como destaca Chaggar, dado que el reconocimiento facial se basa en emparejamientos probabilísticos —calculated similarity scores— no puede ser completamente libre de errores.
Más allá de las caras: la evolución de la vigilancia biométrica
Aun cuando los legisladores luchan por regular el reconocimiento facial, el apetito de la seguridad por la vigilancia pública continúa creciendo.
En el Reino Unido, el crecimiento está reforzado por leyes de protesta más estrictas como la Ley de Orden Público de 2023, con Netpol advirtiendo que la aplicación dependerá inevitablemente de un mayor uso del reconocimiento facial en manifestaciones.
Los Conservadores también han pedido un mayor uso de la tecnología para investigar crímenes, mientras que la policía de Devon y Cornwall ya ha confirmado su uso durante el Boardmasters Festival.
El peligro inmediato es que eliminar el dissenso anónimo podría reconfigurar permanentemente la participación democrática. Sin embargo, los defensores de la privacidad advierten de una amenaza aún mayor: la vigilancia biométrica expandiéndose más allá de la identificación simple hacia la clasificación conductual.
Las autoridades de control fronterizo ya experimentan con combinar el reconocimiento facial con detección de emociones y análisis de la forma de andar —el seguimiento automatizado de la forma de caminar—, herramientas que los defensores dicen podrían usarse para dirigir manifestaciones políticas.
El Dr. Mahmoudi de Amnistía Internacional afirma que normalizar el reconocimiento facial allana el camino para otras herramientas especulativas que podrían “erosionar fundamentalmente la presunción de inocencia.”
Esta rápida expansión tecnológica plantea una pregunta fundamental a las sociedades democráticas: ¿cuánta libertad están dispuestas a intercambiar los ciudadanos por seguridad? Cuando escanear una multitud se vuelve una práctica rutinaria de la policía, las plazas públicas corren el riesgo de transformarse de espacios de libre expresión a escenarios de vigilancia perpetua — donde la cara es solo un primer dato.
En la conversación reciente sobre el rumbo de Samsung, una sesión de Reddit AMA con Annika Bizon, VP de Producto y Marketing para Mobile Experience en Samsung Electronics UK & Ireland, dejó claro que la compañía está evaluando el equilibrio entre hardware, software e inteligencia artificial. A medida que el mercado recibe la inédita línea de plegables y wearables, las respuestas destacan una visión centrada en el usuario y en necesidades reales, como la salud y la personalización de la experiencia.
Tras el lanzamiento de la Galaxy Z Fold 8, Z Fold 8 Ultra y Z Flip 8, Bizon compartió en Reddit su lectura sobre la innovación: la clave está en cómo la IA permite repensar lo que los teléfonos y wearables pueden hacer por cada persona. No se trata solo de hardware, sino de una experiencia que evoluciona a partir de un mayor entendimiento de las necesidades del usuario.
Un punto destacado fue la atención a la salud como área de innovación futura. Bizon señaló que la tecnología ya está acompañando a las personas de formas más preventivas y personalizadas, gracias a sensores mejorados y funciones enfocadas en el bienestar. En particular, la Galaxy Watch Ultra 2 y la nueva generación de sensores en el Galaxy Watch 9 abren la puerta a mediciones como la temperatura de la piel y la monitorización nocturna, con alertas que apuntan a cambios significativos para anticipar posibles enfermedades.
Además, características como Vitals, latency de sueño y alertas de nutrición demuestran una visión de salud integrada en la vida diaria, que va más allá de métricas genéricas para convertirse en recomendaciones personalizadas para cada usuario. Este enfoque, según Bizon, representa la dirección hacia la que evolucionan los dispositivos móviles: más personal, más contextual y, sobre todo, más útil.
En el ámbito de la IA, el AMA dejó claro que la tecnología que entiende lo que necesitas será central. Aunque algunas respuestas en la conversación subrayaron la resistencia a la IA, la postura de Samsung es de oferta personalizable: si la IA no es de uso obligatorio, los usuarios pueden desactivarla a través de opciones de consentimiento y configuración. La invitación, sin embargo, es experimentar con pequeñas funciones que ahorren tiempo y mejoren la experiencia.
La respuesta de Bizon a las críticas no evita los debates éticos, pero propone un enfoque pragmático: empezar con una función pequeña y observar su impacto. Si resulta útil, se expande; si no, se mantiene la elección de desactivarla. Este enfoque de opt-in y personalización podría marcar el ritmo de la adopción de IA en dispositivos móviles en los próximos años.
Más allá de la IA, la conversación también apuntó a la innovación en forma de producto. El énfasis en pantallas más grandes y versátiles en la línea plegable responde a una demanda de explorar más profundamente el contenido y la productividad. En paralelo, la promesa de tecnología que “comprende lo que necesitas” abre la puerta a avances en interfaces, sensores y experiencias que se adaptan dinámicamente al usuario.
Mirando hacia el futuro, la expectativa es que Samsung continúe su patrón de experimentación basado en lo que los usuarios dicen que quieren. La próxima serie Galaxy S27 podría ofrecer indicios tempranos de si esa promesa de innovación sostenida se traduce en nuevas etapas de hardware y software que realmente cambien la forma en que interactuamos con nuestros dispositivos a diario.
Un enfoque claro en la salud
The Samsung Galaxy Watch Ultra 2 (Image credit: Future)
La conversación sugiere que la salud no es solo una función más, sino un eje estratégico para el desarrollo de dispositivos. Con sensores mejorados y algoritmos que transforman datos en recomendaciones prácticas, Samsung busca convertir la tecnología en un compañero de vida que ayuda a prevenir y gestionar retos de salud, desde patrones del sueño hasta la hidratación y la condición física.
Este rumbo, si se mantiene, podría redefinir la manera en que la gente piensa sobre sus dispositivos. No se trata solamente de tener sensores más precisos, sino de convertir esa información en acciones simples y útiles en la vida cotidiana.
En definitiva, el AMA de Annika Bizon ofrece una radiografía de un Samsung que quiere ir más allá de las innovaciones puntuales: busca una experiencia más humana, donde la salud y la comprensión de las necesidades del usuario sean motores centrales de diseño y desarrollo. Si se mantiene esa trayectoria, veremos un año próximo lleno de dispositivos que no solo hacen lo que prometen, sino que entienden mejor lo que cada persona realmente necesita.
Meta ha recibido una multa significativa en Nuevo México, con una cantidad de 567 millones de dólares, y el juez la ha calificado como una responsabilidad que afecta no solo a los usuarios, sino a comunidades enteras que incluyen escuelas, hospitales y servicios de seguridad. Este fallo se suma a una serie de medidas que buscan mitigar los daños potenciales de las plataformas Instagram y Facebook en menores de edad.
El tribunal sostuvo que las aplicaciones de Meta pueden generar una carga social y daño para las familias y las instituciones afectadas, describiendo la situación con una analogía contundente: el daño se asemeja a la contaminación provocada por fábricas. En este marco, la sentencia ordena medidas que buscan proteger la salud mental y el bienestar de los jóvenes. Entre las medidas destacan la eliminación de cuentas y datos de usuarios menores de 13 años, y la restricción de notificaciones para menores de 18 años en ciertos horarios. Además, se propone que los nuevos perfiles de adolescentes sean privados por defecto.
La mayor parte de la penalidad, 420 millones de dólares, está destinada a apoyar servicios de salud mental comunitarios y familiares para los jóvenes de Nuevo México. El resto se destinará a programas de detección, prevención y derivación de casos. Es relevante señalar que estas decisiones se deben complementar con un proceso de apelación, ya que Meta ha anunciado su intención de impugnar la sentencia. Este recurso podría alargar el proceso judicial, pero no resta importancia al mensaje que transmite la resolución: existe un reconocimiento creciente de los riesgos que las redes sociales pueden representar para los menores.
El fallo también refuerza la idea de que las plataformas deben responder por su impacto social, incluso cuando las herramientas se introducen para conectar a las personas. En el debate público, las implicaciones para la industria de tecnología y las políticas de uso infantil serán objeto de análisis a medida que las autoridades evalúen nuevas salvaguardas y estándares de protección.
En resumen, se trata de un precedente importante en materia de seguridad digital para menores: además de las consecuencias financieras, la sentencia impulsa medidas prácticas orientadas a reducir la exposición de los adolescentes y a exigir mayor responsabilidad por parte de las plataformas en la gestión de datos y actividades de usuarios jóvenes.
En un informe reciente, expertos de Google Threat Intelligence señalan que un grupo anteriormente conocido como BlackFile, ahora denominado Redact, ha estado detrás de una campaña de robo de datos y extorsión dirigida a importantes fondos de cobertura y firmas de abogados en Estados Unidos. La operación combina ingeniería social, impersonación de personal de TI y páginas de inicio de sesión falsas para robar credenciales y tokens de autenticación, con el objetivo de infiltrarse en entornos SaaS empresariales y exfiltrar información sensible antes de exigir rescates.
Tácticas y alcance
– Modus operandi: el grupo contacta a empleados con acceso a sistemas SaaS, se hace pasar por personal de TI y dirige a las víctimas a páginas de inicio de sesión imitadas para capturar credenciales y tokens. Una vez dentro, acceden a entornos como Microsoft 365 y Okta, y emplean herramientas automatizadas para exfiltrar datos.
– Extorsión: tras la exfiltración, notifican a las víctimas y amenazan con filtrar los datos en la dark web si no se paga un rescate.
– Detección de objetivos: la táctica de dirigir a las víctimas hacia dominios falsificados también funciona como indicador para identificar posibles blancos. Un informe reciente de Google resume algunos de los nombres más prominentes del sector financiero que han sido objeto de estas intrusiones, entre ellos Blackstone, KKR & Co, Apollo Global Management e CME Group; también se mencionan firmas legales como Paul Hastings LLP y Greenberg Traurig LLP. No obstante, Greenberg Traurig negó haber sido objetivo y Reuters indicó que no estaban necesariamente comprometidos.
– Frecuencia de dominios de phishing: entre abril y mayo se registró un dominio de phishing nuevo cada 2,2 días, aumentando a uno cada 1,6 días en junio y julio, lo que sugiere una intensificación de la operación.
– Movimiento de fondos: Google vincula la actividad con 18 billeteras de criptoactivos donde se registraron aproximadamente 10,7 millones de dólares recibidos entre enero y mediados de mayo de 2026.
Implicaciones y recomendaciones
– Mayor riesgo para grandes firmas y corporaciones con infraestructuras SaaS expuestas y procesos de acceso a credenciales. La combinación de llamadas telefónicas de suplantación y sitios de inicio de sesión falsos incrementa la probabilidad de compromiso inicial y facilita la exfiltración de datos.
– Importancia de la verificación multifactor (MFA) robusta, controles de acceso condicional, y monitoreo de anomalías en entornos SaaS y en wallets asociadas a operaciones criptográficas.
– Fortalecimiento de la educación de usuarios para reconocer señales de ingeniería social, especialmente en comunicaciones que buscan dirigir a páginas de inicio de sesión imitadas.
Conclusión
La campaña liderada por Redact demuestra que los actores adversarios siguen escalando en sofisticación para apuntar a activos estratégicos en el sector financiero y legal. La combinación de tácticas de ingeniería social, phishing de dominios imitados y la exfiltración coordinada de datos resalta la necesidad de una defensa en profundidad, con énfasis en la autenticación fuerte, la supervisión de accesos y la respuesta rápida a incidentes para mitigar daños y pérdidas financieras.
En el mundo de la generación de texto asistida por IA, la mayoría de los consejos se centran en las palabras: pedir concisión, rimas o una traducción más profesional de un correo. Pero la apariencia también importa. ChatGPT permite explorar estilos tipográficos a través de Unicode para dotar de personalidad a las respuestas, sin necesidad de instalar fuentes externas.
Este enfoque no implica cambiar la calidad del contenido, sino la forma en que se presenta. Con indicaciones precisas, es posible generar textos decorativos para mensajes de cumpleaños, invitaciones a fiestas, saludos festivos y publicaciones en redes sociales, todo dentro de la misma conversación de chat.
Al aprender a solicitar estilos Unicode específicos en lugar de simplemente pedir una “fuente diferente”, se abre un abanico de posibilidades que se vuelve más útil de lo esperado.
Fuentes curiosas
No existe una configuración oculta ni una versión especial de ChatGPT que deba instalarse. Si puedes escribir una indicación, ya tienes lo necesario. Abro una nueva conversación y pido al modelo que escriba algo como, por ejemplo, “TechRadar Rules!” en distintos estilos de Unicode. En segundos obtengo varias versiones que difieren entre sí.
Cuanto más específico seas, más se acercará a la visión que tienes. Pide letras burbuja y obtendrás: Ⓣⓔⓒⓗⓡⓐⓓⓐⓡ Ⓡⓤⓛⓔⓢ!
Si buscas un aspecto gótico, obtendrás: 𝔗𝔢𝔠𝔥ℜ𝔞𝔡𝔞𝔯 ℜ𝔲𝔩𝔢𝔰!
Para un estética más digital y glitch, está el estilo Zalgo: T̷̘̑e̸̗̅c̵̄͜h̸͉̕R̶͍̍a̸͚̚d̶̻͐a̸͓̽r̷͖̈́ R̷̡̚u̵̟̅l̶̝͂e̷͓̒ș̵͝!
También existe un Unicode para texto al revés: ┴ǝɔɥᴚɐpɐɹ ᴚnlǝs¡
La capacidad de cambiar el tono de un texto mediante estas variaciones fontográficas convierte la experiencia en algo más que una curiosidad. Un anuncio de fiesta de Halloween en letra gótica genera una atmósfera distinta frente a las mismas palabras en burbuja alegre. Las invitaciones de cumpleaños, anuncios de baby shower y mensajes festivos ganan personalidad sin requerir habilidades de diseño gráfico.
Mensajes memorables
Sin embargo, hay límites. No todas las plataformas muestran todos los caracteres correctamente; algunas webs pueden dejar casillas vacías o sustituir símbolos. También, ciertos estilos pueden dificultar la legibilidad, especialmente para herramientas de accesibilidad como los lectores de pantalla.
Los textos decorativos con Unicode son útiles para títulos y usos puntuales, pero conviene evitar convertir textos extensos. ChatGPT puede transformar un ensayo completo en escritura medieval, pero quizá no sea lo más deseable para el lector.
No se espera que estas variaciones transformen radicalmente la productividad, pero sí pueden hacer que una publicación en redes sociales, un mensaje de cumpleaños o una invitación se destaquen. Ese toque distintivo puede ser justamente el detalle que mantenga a ChatGPT interesante y útil en la comunicación diaria.
La confianza en las políticas de no registro (no-logs) de las VPN se ha visto puesta a prueba por un incidente que, si bien aún genera debate, subraya límites importantes en las garantías que ofrecen estos servicios. Este artículo examina el caso de SplitVPN, una VPN con amplia adopción para eludir bloqueos en contextos de censura, y las implicaciones para usuarios que dependen de una política de no registro como principal salvaguarda de su privacidad.
Recientemente, SplitVPN fue objeto de acusaciones de incumplimiento de su política de no-logs. Un conjunto de documentos y datos supuestamente filtrados incluía una base de datos SQL de 17 GB que, según analistas, contenía granularidad sobre conexiones de usuarios, dispositivos y pagos. Aunque la empresa ha negado categóricamente que conserve registros de actividad, el episodio pone sobre la mesa una cuestión clave: ¿cuánto puede confiar un usuario en una promesa que, en la práctica, depende de mecanismos de auditoría y verificación externos?
Incluso entre las VPN más seguras, las políticas de no registro suelen basarse en la confianza y no en salvaguardas verificables por sí mismas. Esto significa que, por muy reputadas que sean, estas políticas pueden no ofrecer una visión clara de los riesgos a los que se exponen los usuarios ante una posible brecha de seguridad, especialmente en países donde el uso de VPNs puede estar sujeto a repercusiones legales o sanciones severas.
Una política de no-logs implica que una VPN se compromete a no recolectar ni compartir información de los usuarios, como consultas de búsqueda, sitios visitados, duración de las sesiones o descargas, mientras se está conectado a un servidor. Aun así, la verificación por parte del usuario es complicada. Por ello, los proveedores más exigentes suelen someterse a auditorías independientes y publicar informes de transparencia para demostrar que sus promesas son genuinas y no meros anuncios de marketing.
La presunta filtración de SplitVPN
El 21 de julio, un actor de amenazas en un foro de cibercriminalidad difundió una base de datos SQL de 17 GB alegando haber sido robada de SplitVPN, que supuestamente contenía una gran cantidad de logs de conexión, además de información de usuarios, dispositivos y pagos. Un equipo de investigación, entre ellos Mysterium VPN, analizó la base de datos y afirmó que parte de ella (conocida como ‘deviceproxy’) podría contener alrededor de 58 millones de logs de conexión. Aunque estos registros se presentaron como metadatos anonimizados, SplitVPN mantiene que no conserva dichos datos conforme a su política de no-logs.
La compañía indicó a TechRadar que, si bien la metadata filtrada —incluidas direcciones de correo, países de origen, estado de suscripción y datos de tarjetas enmascarados— es auténtica, la tabla deviceproxy es una fabricación ajena a su infraestructura. Según un portavoz, “el listado de terceros que afirma 58 millones de logs es una fabricación destinada a inflar el precio.” Añadieron que no generan ni almacenan mapeos de dispositivos a servidores y sellaron la vulnerabilidad, rotaron credenciales y claves de cifrado, y llamaron a auditores externos para revisar su infraestructura. Las operaciones se han normalizado desde entonces.
Independientemente de la veracidad de los registros de deviceproxy, el episodio plantea dilemas fundamentales. Si las afirmaciones son ciertas, la existencia de esos logs contradiría directamente la política de no-logs. En el mejor de los casos, con correlacionar direcciones IP de conexiones recientes y identificadores de hardware, podría ser posible reconstruir quién se conectó, desde dónde y a qué servidor, exponiendo a millones de usuarios en entornos con censura severa. Si, por otra parte, las afirmaciones fueran fabricadas, los usuarios siguen enfrentando la incertidumbre de declaraciones conflictivas, sin una verificación independiente clara y con posibles repercusiones para quienes operan en países donde el uso de VPNs está restringido.
Esta situación subraya la importancia de buscar evidencias claras: políticas de privacidad auditadas y características de seguridad avanzadas como kill switches, configuraciones de VPN en doble salto, y opciones de cifrado post-cuántico. Tecnologías como servidores con memoria RAM solo o criptografía avanzada pueden marcar la diferencia cuando la protección de datos está en juego. En última instancia, las palabras pueden cambiar, pero la pericia técnica y la verificación independiente son las que sostienen la confianza de los usuarios.
Para fortalecer la privacidad de los usuarios, se recomienda considerar proveedores que cuenten con auditorías de terceros, informes de transparencia actualizados y características de seguridad operativas robustas. La lección clave es que, incluso con las mejores políticas declaradas, la verificación externa y la implementación de controles técnicos son esenciales para garantizar que una promesa de no-logs no sea solo una imagen bien diseñada, sino una realidad comprobable.
Hasta ahora, la inteligencia artificial empresarial se ha desarrollado bajo una conversación familiar: qué modelos usar, dónde desplegar copilotos y agentes, y qué tan rápido avanzar de la experimentación a un valor tangible para el negocio.
Estos temas siguen siendo relevantes, pero a medida que los equipos avanzan en su recorrido con la IA, ya no son las preguntas prioritarias. La primera oleada de IA se centró en descubrir si la IA podía ayudar; se trató de un periodo de experimentación rápida con pruebas de concepto y pilotos en múltiples funciones para identificar dónde podría aportar valor.
Ahora la conversación ha cambiado. Los líderes empresariales no buscan nuevos casos de uso; la mayoría de las organizaciones ya cuenta con docenas. El verdadero reto es escalar de forma consistente: ya no se pregunta “Dónde podemos usar IA?”, sino “Cómo hacer que funcione de forma confiable en todo el negocio”.
Este cambio de enfoque ha puesto de manifiesto un problema que muchas organizaciones subestimaron: los datos.
La IA expone debilidades en las bases
En las etapas iniciales de desarrollo, muchas empresas se centraron en acceder a conjuntos de datos propietarios con el fin de personalizar modelos. Aunque este desafío persiste, hoy hay un tema mayor: la calidad, accesibilidad y gobernanza de los datos en toda la organización.
La IA es tan eficaz como la información y los procesos sobre los que opera. Lo complejo es que la IA tiende a exponer debilidades que ya existían en las organizaciones desde hace años. Y eso debe ser una llamada de atención para los líderes que invierten en IA ahora. Cuando los datos están fragmentados, los procesos son inconsistentes y la madurez operativa es deficiente, la IA no solucionará el problema; lo amplificará.
En ese marco, conviene entender la IA como un multiplicador de fuerza, no como un corrector de ineficiencias heredadas. Sin embargo, lo contrario también es cierto: cuando se tratan los datos como un producto de primera clase, la IA tiene potencial para multiplicar la calidad que se obtiene.
Esta es la diferencia clave entre implementar IA y estar realmente preparado para ella. Puedes tener un modelo sólido, pero si trabajas con datos fragmentados y no estructurados, tus resultados seguirán siendo inconsistentes. Lo he visto en primera persona.
Esto no es solo una anécdota. Gartner predice que hasta 2026, el 60% de los proyectos de IA se abandonarán porque no están respaldados por datos listos para IA, y el 63% de los responsables de gestión de datos dicen no contar con prácticas de gestión de datos que IA requiere.
Estos hallazgos fortalecen lo que muchas organizaciones descubren por sí mismas: el éxito de la IA está cada vez más determinado por la calidad de los datos subyacentes que por la sofisticación del modelo.
La trampa de los pilotos de datos
Muchos observaron resultados alentadores en sus pilotos iniciales de IA, lo cual no sorprende. En general, los pilotos se construyen sobre muestras de datos curadas, que son reales pero, hasta cierto punto, preseleccionadas o ligeramente sintéticas.
Con ese tipo de datos, es natural ver éxito porque la información ha sido escogida para demostrar el potencial tecnológico.
La verdadera prueba empieza cuando las organizaciones escalan IA y la liberan de los límites de esos pilotos hacia el entorno real de la empresa.
De pronto, los modelos acceden a muchos tipos diferentes de datos que deben trabajar juntos. Se enfrentan a años de registros duplicados, definiciones de negocio contradictorias, datos de clientes incompletos, documentación inconsistente y sistemas desconectados. La información que parecía fiable en un piloto se vuelve menos confiable en producción.
Ahí es donde los equipos de liderazgo suelen recibir la mayor sorpresa. Comprenden que el estado real de sus datos es peor de lo que esperaban. Lo que funcionó bien durante la prueba de concepto simplemente no funciona en el entorno de producción, no por menos capacidad de la IA, sino por la realidad de los datos a nivel empresarial.
Lamentablemente, esa experiencia es cada vez más común. Lo definitivo ahora es no demostrar que la IA funciona, sino asegurar que los datos detrás de ella estén preparados para el despliegue a escala.
Señales de que tus datos no están listos para IA
¿Cómo saber si tus datos están listos para IA? En muchos casos, la respuesta se hace evidente cuando los proyectos no entregan los resultados esperados. Pero, mucho antes, hay indicios de alerta.
Tu gobernanza de datos tiene lagunas: ¿sabes dónde reside cada dato, quién lo es dueño y si puede confiarse? Si cada análisis depende de conciliación manual, la IA simplemente escalará esas inconsistencias. Años de crecimiento orgánico suelen dejar datos en silos, definiciones conflictivas y gobernanza inconsistente. Antes de que IA pueda entregar resultados fiables, las organizaciones necesitan propiedad clara, estándares consistentes y pipelines de datos confiables.
Las iniciativas de IA se realizan de forma aislada: cuando diferentes equipos experimentan de manera independiente, es señal de que los datos subyacentes no están conectados. Y esto es más común de lo que parece: investigaciones señalan que menos del 30% de las organizaciones tienen su agenda de IA respaldada directamente por el CEO. La información valiosa queda atrapada en silos departamentales o sistemas heredados, dificultando obtener una visión completa del negocio.
En estas condiciones, IA tiende a quedarse en experimentación a nivel funcional y no en una transformación empresarial coordinada. IA rinde mejor cuando puede aprovechar datos integrados y confiables, no conjuntos fragmentados creados para funciones específicas.
Tus datos no están conectados a resultados de negocio: la IA crea valor al mejorar decisiones y procesos, no al analizar datos por sí mismos. Si no está claro cómo tus datos apoyan los resultados que buscas, las iniciativas de IA difícilmente producirán resultados significativos. Datos incompletos, desactualizados o mal mantenidos minarán la confianza en las salidas de IA, dificultando pasar de pilotos aislados a resultados concretos.
Pasas más tiempo eligiendo modelos que mejorando datos: Elegir un modelo base es importante, pero rara vez determina el éxito. Los mayores desafíos son preparar los datos empresariales, identificar casos de uso de alto valor, incorporar IA en flujos de trabajo existentes y fomentar la adopción en toda la empresa. Buscar siempre la última versión no brindará resultados tangibles; invertir en las bases de datos que harán que un modelo funcione sí.
El potencial solo se realizará con bases sólidas
Quizá el mayor cambio para los líderes empresariales es un cambio de mentalidad: pasar de centrarse en modelos avanzados a establecer bases sólidas. La investigación de McKinsey respalda esto, al indicar que la preparación organizacional explica el 48% de la diferencia entre empresas que capturan valor de la IA y las que no, lo que la convierte en un predictor más fuerte de éxito.
Para las empresas, la meta con IA no debe ser simplemente automatizar tareas existentes, sino replantear cómo opera el negocio. Eso implica rediseñar procesos en función de las capacidades de IA, en lugar de añadir IA a formas de trabajar ineficientes.
Para que eso ocurra, la calidad de los datos, la gobernanza y la propiedad clara ya no pueden tratarse como preocupaciones menores de back-office; deben reconocerse como prioridades estratégicas.
La oportunidad de la IA empresarial es enorme, pero sin datos de confianza sobre los que construir, su potencial seguirá siendo solo eso: potencial.
Este artículo forma parte de TechRadar Pro Perspectives, nuestra plataforma para presentar las ideas de las mentes más brillantes de la industria tecnológica.
Un incidente reciente ilustra cómo un ataque clásico de inyección SQL (SQLi) puede combinarse con trucos de base de datos para tomar el control total del sistema subyacente. En este caso, Huntress, investigando la incidencia, señaló que una aplicación pública con backend Oracle aceptó y ejecutó comandos SQL introducidos sin validación adecuada, permitiendo a los atacantes desplegar una toolkit residente en la base de datos, denominada khunt. Este enfoque combina técnicas discutidas desde hace años y, sin embargo, rara vez se observa en la práctica real.
Cómo defendemos
Qué ocurrió a continuación, según Huntress, fue aún más sorprendente: tras la inyección SQL, el atacante logró cargar una toolkit residente en la base de datos para post-explotación, denominada khunt. Esta técnica ha sido descrita en el pasado, incluida la descrita como oraexec, pero su uso en incidentes reales ha sido poco documentado hasta ahora.
La toolkit khunt otorgaba múltiples capacidades al atacante, entre ellas cargar cmd.exe en el sistema y ejecutar comandos del sistema operativo arbitrarios, robar nombres de usuario y contraseñas, listar, leer, buscar y verificar tamaños de archivos (es decir, explorar el sistema comprometido), descomprimir archivos y otras acciones. Entre las opciones más destacadas, los atacantes ejecutaron un comando de PowerShell e invocaron la herramienta de Registro de Windows, copiando las hives SAM, SECURITY y SYSTEM del registro. Más tarde podrían usar estas copias para extraer y decodificar hashes de contraseñas de cuentas locales en el sistema.
Para defenderse de este tipo de ataques, Huntress recomienda asegurar que los formularios no sean inyectables. Es crucial practicar una sanitización de entradas adecuada y la parametrización de consultas para cualquier dato de entrada. También es importante garantizar que los usuarios con la capacidad de ejecutar consultas no estén sobredimensionados en privilegios.
Incluso si alguien logra una inyección SQL, las cuentas de usuario no deberían tener permisos para crear fuentes Java, ejecutar procedimientos almacenados u otras operaciones poderosas.
Lecciones clave:
– Validación y saneamiento de entradas en todas las capas de la aplicación.
– Parametrización de consultas para evitar inyecciones.
– Principio de privilegios mínimos: limitar quién puede ejecutar consultas y operaciones sensibles.
– Controles de registro y monitoreo para detectar actividades de post-explotación y extracción de hives del registro.
– Gestión de credenciales y mecanismos de defensa en el nivel de la base de datos para evitar compromisos de hashes locales.
Este caso subraya la importancia de enfoques de defensa en profundidad que combinen buenas prácticas de desarrollo seguro, controles de acceso estrictos y monitorización continua para reducir la superficie de ataque y contener incidentes cuando ocurren.