[New Episodes] Staying at home doesn’t mean sitting still for energetic Bo and her little dragon friend Dezzy, who embark on amazing adventures through movement.
from New On Netflix USA https://ift.tt/q7nFgQ2
via IFTTT

[New Episodes] Staying at home doesn’t mean sitting still for energetic Bo and her little dragon friend Dezzy, who embark on amazing adventures through movement.
from New On Netflix USA https://ift.tt/q7nFgQ2
via IFTTT
A newlywed couple’s honeymoon in London turns into a hilariously chaotic trip when the pair’s clueless family crashes the romantic getaway.
from New On Netflix USA https://ift.tt/ZI6Xm5q
via IFTTT
When sinister forces threaten the peace of Britannia, a young prince embarks on a perilous journey to save his loved ones and discover his true powers.
from New On Netflix USA https://ift.tt/Ycr2Rev
via IFTTT
From the stylish Evercade to the old-school Sega Genesis Mini, these machines will have you bleeping, blooping, and blasting back to the good old days.
from Gear Latest https://ift.tt/oN9LKGq
via IFTTT
Analogue Pocket’s 21st-century handheld makes revisiting games from outdated mobile consoles more fun than ever.
from Gear Latest https://ift.tt/a0GNtQj
via IFTTT
(adsbygoogle = window.adsbygoogle || []).push({});
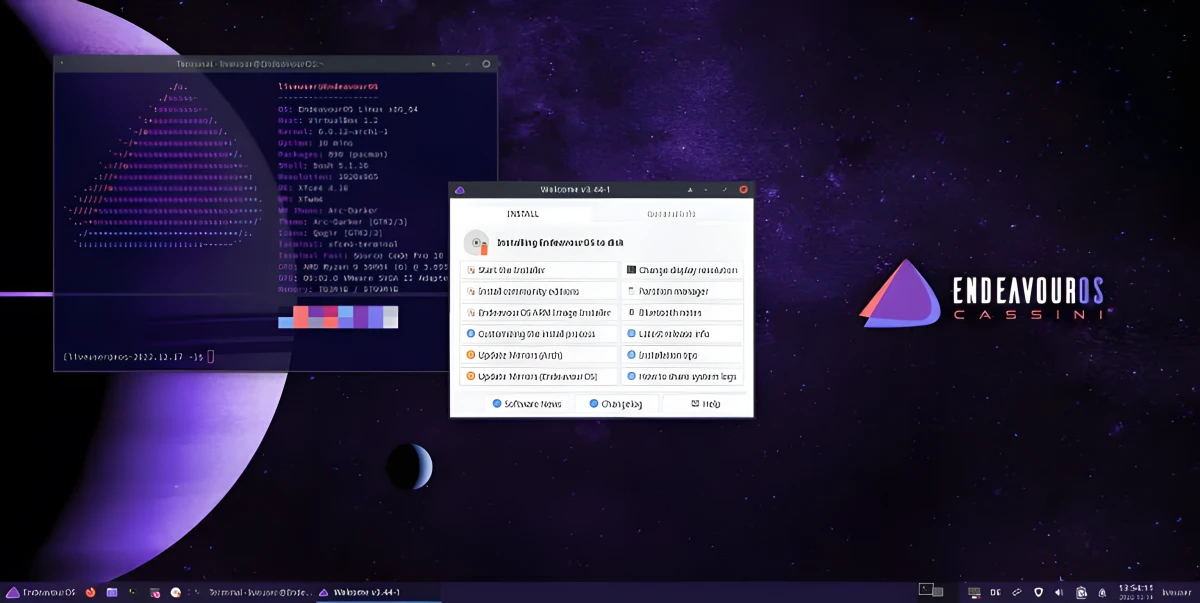
Empiezan a llegar los regalos de Navidad. Pronto se hará oficial el lanzamiento de Linux Mint 21.1, pero lo que ya hay disponible es una nueva versión de EndeavourOS. Entre sus novedades se puede destacar que usa el penúltimo kernel, aunque, tratándose de una distribución Rolling Release, pronto se podrá subir a la última versión. Hay que recordar que las nuevas imágenes son para instalaciones de cero, y que todas sus novedades ya han llegado a los usuarios existentes.
Esta nueva versión de EndeavourOS lleva el nombre en clave de Cassini, y sus desarrolladores dicen que, del mismo modo que la nasa «tuvo su buena ración de momentos para morderse las uñas, esta versión tuvo algunas pruebas para morderse las uñas porque llegar hasta aquí requirió una revisión importante en la forma en que construimos nuestra ISO«.
(adsbygoogle = window.adsbygoogle || []).push({});
Esta ISO ha llegado tres meses después de Artemis Nova, y ya se puede descargar desde este enlace. Tal y como hemos explicado, los usuarios existentes que hayan actualizado con frecuencia ya tendrán todos los paquetes en su sistema operativo.
from Linux Adictos https://ift.tt/9oSAQdl
via IFTTT
Xen es un hipervisor que proporciona aislamiento seguro, control de recursos, garantías de calidad de servicio y migración de máquinas virtuales
(adsbygoogle = window.adsbygoogle || []).push({});
Después de un año de desarrollo, se dio a conocer el lanzamiento de la nueva versión del hipervisor gratuito Xen 4.17, versión en la cual la formación de actualizaciones para la rama Xen 4.17 durará hasta el 12 de junio de 2024 y la publicación de correcciones de vulnerabilidades hasta el 12 de diciembre de 2025.
Cabe mencionar que empresas como Amazon, Arm, Bitdefender, Citrix, EPAM Systems y Xilinx (AMD) han contribuido al desarrollo de la nueva versión.
(adsbygoogle = window.adsbygoogle || []).push({});
En esta nueva versión que se presenta se destaca que se proporcionó la capacidad de definir una configuración estática de Xen para sistemas ARM que codifica por adelantado todos los recursos necesarios para iniciar los sistemas invitados. Todos los recursos, como la memoria compartida, los canales de notificación de eventos y el espacio de almacenamiento dinámico del hipervisor, se asignan previamente en el inicio del hipervisor en lugar de asignarse dinámicamente, lo que elimina la posibilidad de fallas debido a la falta de recursos.
Para los sistemas integrados basados en la arquitectura ARM, se ha implementado soporte experimental (tech preview) para la virtualización de E/S usando los protocolos VirtIO, virtio-mmio se utiliza para comunicarse con el dispositivo de E/S virtual, lo que permitió garantizar la compatibilidad con una amplia gama de dispositivos VirtIO. Tambien podremos encontrar la compatibilidad implementada para el frontend de Linux, con libxl/xl, el modo dom0less y los backends de espacio de usuario.
Otro de los cambios que se destaca es la compatibilidad mejorada con el modo dom0less, que permite evitar la implementación de un entorno dom0 al iniciar máquinas virtuales en una etapa temprana del arranque del servidor.
(adsbygoogle = window.adsbygoogle || []).push({});
Se proporciona la capacidad de definir grupos de CPU (CPUPOOL) en la etapa de arranque (a través del árbol de dispositivos), lo que permite usar grupos en configuraciones sin dom0, por ejemplo, para vincular diferentes tipos de núcleos de CPU en sistemas ARM basados en la arquitectura big.LITTLE, que combina núcleos potentes, pero que consumen energía, y núcleos menos productivos, pero más eficientes energéticamente. Además, dom0less brinda la capacidad de vincular el frontend/backend de paravirtualización a los invitados, lo que le permite iniciar a los invitados con los dispositivos paravirtualizados necesarios.
En los sistemas ARM, las estructuras de virtualización de memoria (P2M, físico a máquina) ahora se asignan desde el grupo de memoria creado cuando se crea un dominio, lo que permite un mejor aislamiento entre invitados cuando ocurren fallas relacionadas con la memoria.
En los sistemas x86, se admiten páginas IOMMU (superpágina) grandes para todos los tipos de sistemas invitados, lo que permite aumentar el rendimiento al reenviar dispositivos, PCI, ademas de que se agregó soporte para hosts con hasta 12 TB de RAM. En la etapa de arranque, se implementa la capacidad de establecer parámetros cpuid para dom0. Los parámetros VIRT_SSBD y MSR_SPEC_CTRL se proponen para controlar la protección a nivel de hipervisor contra ataques a la CPU en sistemas invitados.
De los demás cambios que se destacan:
(adsbygoogle = window.adsbygoogle || []).push({});
Por separado, se está desarrollando el transporte VirtIO-Grant, que difiere de VirtIO-MMIO en un mayor nivel de seguridad y la capacidad de ejecutar controladores en un dominio aislado separado para los controladores.
En lugar del mapeo de memoria directo, VirtIO-Grant utiliza la traducción de las direcciones físicas del huésped en enlaces de concesión, lo que permite el uso de áreas de memoria compartida previamente acordadas para el intercambio de datos entre el huésped y el backend de VirtIO, sin otorgarle al backend el derecho de realizar mapeo de memoria. La compatibilidad con VirtIO-Grant ya está implementada en el kernel de Linux, pero aún no está incluida en los backends de QEMU, virtio-vhost y toolkit (libxl/xl).
La iniciativa Hyperlaunch continúa desarrollándose para proporcionar herramientas flexibles para personalizar el lanzamiento de máquinas virtuales en el momento del arranque del sistema. Actualmente, el primer conjunto de parches ya está listo, lo que permite definir dominios PV y transferir sus imágenes al hipervisor al cargar. T
Finalmente si estás interesado en poder conocer más la respecto, puedes consultar los detalles en el siguiente enlace.
from Linux Adictos https://ift.tt/1k2Isxh
via IFTTT
Linux Kernel
(adsbygoogle = window.adsbygoogle || []).push({});
Se dio a conocer hace poco que fueron propuestas mejoras de Btrfs para su inclusión en el kernel de Linux 6.2 para solucionar el problema del «write hole» en la implementación de RAID 5/6.
La esencia del problema se reduce al hecho de que si se produce un bloqueo durante la grabación, inicialmente es imposible entender qué bloque en cuál de los dispositivos RAID se escribió correctamente y en cuál no se completó la grabación.
(adsbygoogle = window.adsbygoogle || []).push({});
Si se intenta reconstruir un RAID en esta situación, los bloques correspondientes a los bloques suscritos pueden dañarse porque el estado de los bloques RAID no está sincronizado. Este problema ocurre en cualquier arreglo RAID1/5/6 donde no se toman medidas especiales para combatir este efecto.
En una implementación de RAID como RAID1 en btrfs, este problema se resuelve mediante el uso de sumas de verificación en ambas copias, si hay una discrepancia, los datos simplemente se restauran desde la segunda copia. Este enfoque también funciona si algún dispositivo comienza a dar datos incorrectos en lugar de fallar por completo.
Sin embargo, en el caso de RAID5/6, el sistema de archivos no almacena sumas de verificación para bloques de paridad: en una situación normal, la corrección de los bloques se verifica por el hecho de que todos están equipados con una suma de verificación y el bloque de paridad puede recrearse a partir de los datos. Sin embargo, en el caso de grabación parcial, este enfoque puede no funcionar en ciertas situaciones. En este caso, al restaurar la matriz, es posible que los bloques que quedaron en el registro incompleto se restauren incorrectamente.
(adsbygoogle = window.adsbygoogle || []).push({});
En el caso de btrfs, este problema es más relevante si la escritura que se produce es más pequeña que la franja. En este caso, el sistema de archivos debe realizar una operación de lectura, modificación y escritura (RMW).
Si encuentra bloques de escritura en curso, la operación RMW puede causar daños que no se detectarán, independientemente de las sumas de verificación. Los desarrolladores han realizado cambios en los que la operación RMW verifica la suma de verificación de los bloques antes de realizar esta operación y, si es necesario, la recuperación de datos también realiza una verificación de suma de verificación después de escribir.
Desafortunadamente, en una situación en la que se escribe una franja incompleta (RMW), esto genera una sobrecarga adicional para calcular las sumas de verificación, pero aumenta significativamente la confiabilidad. Para RAID6, dicha lógica aún no está lista,
Además, podemos observar las recomendaciones sobre el uso de RAID5/6 de los desarrolladores, cuya esencia es que en Btrfs el perfil para almacenar metadatos y datos puede diferir. En este caso, puede utilizar el perfil RAID1 (espejo) o incluso RAID1C3 (3 copias) para metadatos, y RAID5 o RAID6 para datos.
Esto garantiza una protección fiable de los metadatos y la ausencia de un «agujero de escritura», por un lado, y un uso más eficiente del espacio, típico de RAID5/6, por el otro. Esto evita la corrupción en los metadatos y la corrupción de datos se puede corregir.
(adsbygoogle = window.adsbygoogle || []).push({});
También se puede señalar que para los SSD en Btrfs en el kernel 6.2, la ejecución asíncrona de la operación «discard» (marcar bloques liberados que ya no se pueden almacenar físicamente) estará activada por defecto.
La ventaja de este modo es el alto rendimiento debido a la agrupación eficiente de las operaciones de «discard» en una cola y el procesamiento posterior de la cola por parte de un controlador en segundo plano, por lo que las operaciones normales de FS no se ralentizan, como es el caso con el síncrono «discard» a medida que se liberan bloques, y el SSD puede tomar mejores decisiones. Por otro lado, ya no necesitará usar utilidades como fstrim, ya que todos los bloques disponibles se borrarán en el FS sin necesidad de escaneo adicional y sin ralentizar las operaciones.
Finalmente si estás interesado en poder conocer más al respecto, puedes consultar los detalles en el siguiente enlace.
from Linux Adictos https://ift.tt/TPJ5Z3i
via IFTTT
The US is offering four more at-home tests to every household. Here’s how to get yours.
from Gear Latest https://ift.tt/Nig8Znt
via IFTTT
A sudden tragedy brings the wife of an assemblyman out of her private life and forces her to confront family secrets and her own troubling past.
from New On Netflix USA https://ift.tt/tno5HzR
via IFTTT

