Raspberry Pi 4 sube hasta los 8GB de RAM, pero mantiene el resto de especificaciones

Raspberry Pi 4 con 8GB

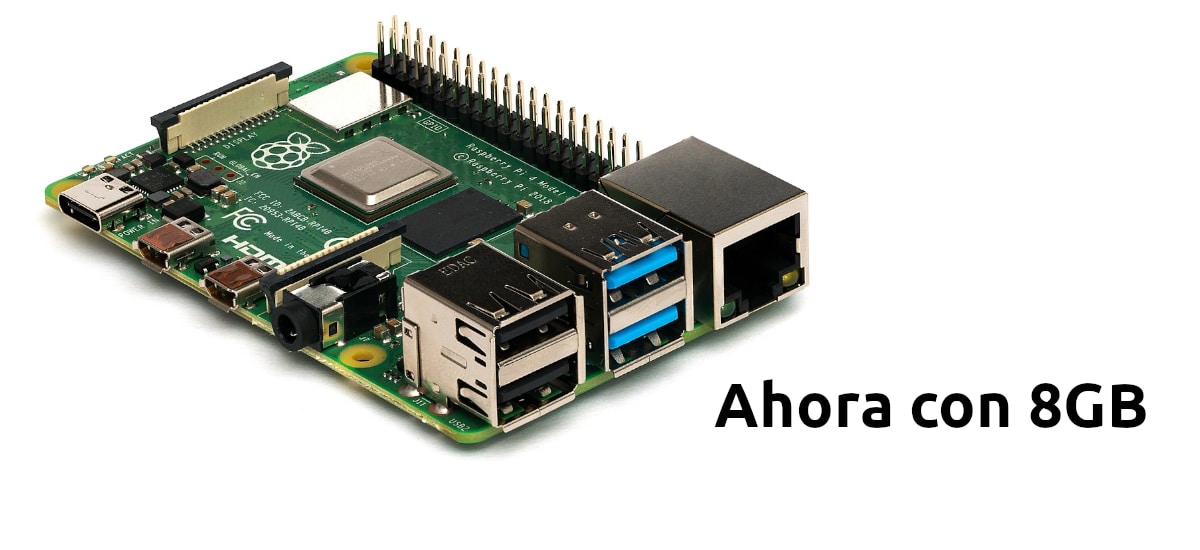
Hace menos de un año, la compañía de la frambuesa lanzó la Raspberry Pi 4 Model B. Fue una actualización importante que mejoró puntos como su conectividad, contando con, entre otras cosas, USB-C para la alimentación, 2 puertos micro HDMI, 2 puertos USB 2.0 y otros 2 puertos USB 3.0, además del Ethernet y Jack para audio. También aumentó su RAM, habiendo disponible un modelo superior con hasta 4GB de RAM. Si esto no es suficiente para ti, ahora han lanzado algo que quizá te interese.

El nuevo modelo de la Raspberry Pi 4 ha llegado con 8GB de RAM. Hasta ahora, las imágenes de sistemas operativos para la Raspberry usaban 32-bits, pero con extensiones LPAE para el kernel, permitiendo direccionar mayor cantidad de memoria como los nativos de 64-bit. La buena noticia es que la compañía ha lanzado una beta de su sistema operativo para sistemas de 64-bit nativos: Raspberry Pi OS. De este modo, parece que abandonarán el nombre de Raspbian, el sistema operativo desarrollado por la compañía para sus placas que está basado en Debian.

La nueva Raspberry Pi 4 sigue con arquitectura ARM

Aunque es cierto que los 8GB no es la única novedad que trae debajo del brazo la Raspberry Pi 4, sí lo es que cambia poco más. Esta versión incluye un nuevo empaquetado y algunos componentes nuevos, como switch e inductores para el suministro de energía. Por todo lo demás, se mantiene como la versión lanzada hace ahora 11 meses, con un talón de Aquiles muy importante para los que quieran usar la Raspberry como una especie de mini-ordenador de escritorio.

Tanto la nueva placa como Raspberry Pi OS siguen basándose en ARM, por lo que sólo podrá usar aplicaciones que estén desarrolladas para esta arquitectura. Por lo tanto, si estás pensando en usar las últimas versiones de Firefox o Chrome, no vas a poder hasta que no lancen una versión para esta arquitectura. De hecho, en Raspbian siempre se ha podido instalar sólo la versión ESR de Firefox.

Eso sí, al César lo que es del César, y con las nuevas versiones de la placa y el sistema operativo podremos aprovechar más RAM que hasta hace 24 horas, en donde sólo podíamos usar hasta 3GB por las restricciones de los 32-bits. Si estás interesado, puedes comprarla desde aquí por 82.95€.

from Linux Adictos https://ift.tt/3equUMz
via IFTTT

OpenSSH 8.3 ya esta aquí y estas son sus novedades

Después de tres meses de desarrollo, se presentó el lanzamiento de la nueva version de OpenSSH 8.3, en la cual se destaca una nueva protección añadida contra ataques scp, lo que permite al servidor transferir otros nombres de archivos que difieren de los solicitados (a diferencia de la vulnerabilidad anterior, el ataque no permite cambiar el directorio seleccionado por el usuario o la máscara global).

En SCP, el servidor decide qué archivos y directorios enviar al cliente y el cliente solo verifica la exactitud de los nombres de los objetos devueltos. La esencia del problema identificado es que si falla la llamada al sistema de tiempos, el contenido del archivo se interpreta como metadatos de archivo.

Cuando se conecta a un servidor controlado por un atacante, esta función se puede usar para guardar otros nombres de archivo y otros contenidos en el FS del usuario al copiar usando scp en configuraciones que provocan fallas en los tiempos. Por ejemplo, cuando los tiempos están deshabilitados por la política de SELinux o el filtro de llamadas del sistema.

Se estima que la probabilidad de ataques reales es mínima, ya que en configuraciones típicas la llamada de tiempo no falla. Además, el ataque no pasa desapercibido: cuando se llama a scp, se muestra un error de transmisión de datos.

Adiós a SHA-1

Además los desarrolladores de OpenSSH también advirtieron una vez más sobre la próxima transferencia a la categoría de algoritmos obsoletos que usan hash SHA-1, debido a un aumento en la eficiencia de los ataques de colisión con un prefijo dado (el costo de la selección de colisión se estima en alrededor de $ 45 mil).

En uno de los siguientes problemas, planean deshabilitar por defecto la capacidad de usar el algoritmo de firma digital de clave pública ssh-rsa, que se menciona en el RFC original para el protocolo SSH y sigue siendo generalizado en la práctica.

Posibles candidatos

Para facilitar la transición a nuevos algoritmos en OpenSSH en una de las próximas versiones, la configuración UpdateHostKeys se habilitará de manera predeterminada, lo que cambiará automáticamente a los clientes a algoritmos más confiables.

Entre los algoritmos recomendados para la migración están: rsa-sha2-256/512 basado en RFC8332 RSA SHA-2 (compatible con OpenSSH 7.2 y utilizado de forma predeterminada), ssh-ed25519 (compatible con OpenSSH 6.5) y ecdsa-sha2-nistp256 / 384/521 basado en RFC5656 ECDSA (compatible con OpenSSH 5.7).

Otros cambios

Desde el último número, «ssh-rsa» y «diffie-hellman-group14-sha1» se han eliminado de la lista CASignatureAlgorithms, que define los algoritmos válidos para firmar digitalmente nuevos certificados, ya que el uso de SHA-1 en los certificados conlleva un riesgo adicional debido a que el atacante tiene tiempo ilimitado para buscar colisiones para un certificado existente, mientras que el tiempo de ataque en las claves del host está limitado por el tiempo de espera de conexión (LoginGraceTime).

De los demas cambios que se destacan de esta nueva version son:

  • En sftp, el procesamiento «-1» se detiene, de forma similar a ssh y scp, que fue previamente aceptado pero ignorado.
  • En sshd cuando se usa IgnoreRhosts, ahora se proporcionan tres opciones: «yes» para ignorar rhosts/shosts, «no» para considerar rhosts/shosts y «shosts-only» que es permitir «.shosts», pero deshabilita «.rhosts».
  • En ssh, el procesamiento de la sustitución% TOKEN se proporciona en la configuración LocalFoward y RemoteForward utilizada para redirigir los sockets Unix.
  • Está permitido descargar claves públicas de un archivo no cifrado con una clave privada, si no hay un archivo separado con una clave pública.
  • Si el sistema tiene libcrypto en ssh y sshd, ahora usa la implementación del algoritmo chacha20 de esta biblioteca, en lugar de la implementación portátil incorporada, que tiene un rendimiento inferior.
  • Se implementó la capacidad de volcar el contenido de la lista binaria de certificados revocados al ejecutar el comando «ssh-keygen -lQf/path».
  • La versión portátil implementa definiciones del sistema en las cuales las señales con la opción SA_RESTART interrumpen la selección;
  • Problemas de compilación resueltos en sistemas HP/UX y AIX.
  • Se corrigieron problemas de compilación para seccomp sandbox en algunas configuraciones de Linux.
  • La definición de la biblioteca libfido2 se ha mejorado y los problemas de compilacion se han resuelto con la opción –with-security-key-builtin.

¿Como instalar OpenSSH 8.3 en Linux?

Para quienes estén interesados en poder instalar esta nueva versión de OpenSSH en sus sistemas, de momento podrán hacerlo descargando el código fuente de este y realizando la compilación en sus equipos.

Esto es debido a que la nueva versión aún no se ha incluido dentro de los repositorios de las principales distribuciones de Linux. Para obtener el código fuente, puedes hacer desde el siguiente enlace.

Hecha la descarga, ahora vamos a descomprimir el paquete con el siguiente comando:

tar -xvf openssh-8.3.tar.gz

Entramos al directorio creado:

cd openssh-8.3

Y podremos realizar la compilación con los siguientes comandos:

./configure --prefix=/opt --sysconfdir=/etc/ssh
make
make install

from Linux Adictos https://ift.tt/2Aco8LC
via IFTTT

WSU GPU, una implementación para dar acceso a aplicaciones gráficas de Linux en WSL

WSL GUI Apps

La semana pasada, los desarrolladores de Microsoft anunciaron diversas mejoras significativas en el subsistema WSL (Windows Subsystem for Linux), que permite que aplicaciones de Linux se ejecuten en Windows. Ya que a partir de la actualización de mayo de Windows 10, la primera instalación del entorno Linux utilizará la capa WSL2 de forma predeterminada.

El entorno WSL2 se ejecuta en una imagen de disco (VHD) separada con el sistema de archivos ext4 y el adaptador de red virtual. El kernel de Linux en WSL2 no se incluirá en la imagen de instalación de Windows, pero Windows lo cargará dinámicamente y lo mantendrá en la forma actual, de forma similar a cómo se instalan y actualizan los controladores de gráficos. Para instalar y actualizar el kernel, se utilizará el mecanismo estándar de Windows Update.

El núcleo propuesto para WSL2 se basa en el lanzamiento del núcleo Linux 4.19, que se ejecuta en un entorno Windows utilizando una máquina virtual que ya está en uso en Azure.

Los parches específicos de WSL2 utilizados en el núcleo incluyen optimizaciones para reducir el tiempo de inicio del núcleo, reducir el consumo de memoria, devolver Windows a la memoria liberada por los procesos de Linux y dejar el conjunto mínimo de controladores y subsistemas necesarios en el núcleo.

Ya es posible ejecutar aplicaciones gráficas en WSL

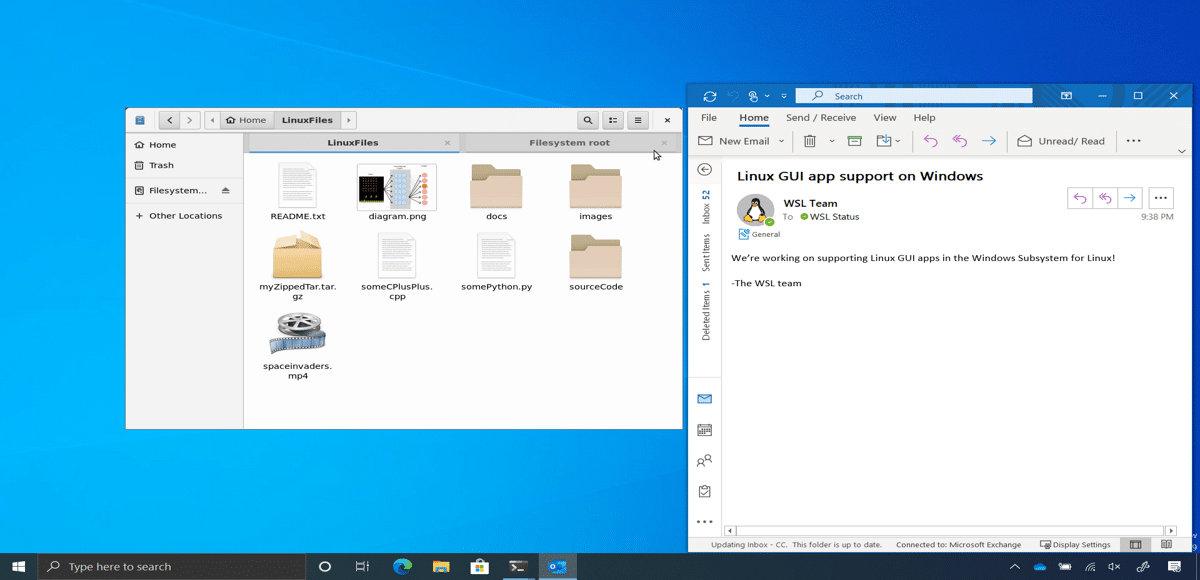
Además de lo mencionado, otra de las novedades que se destaca es el soporte para inicial para aplicaciones de Linux con una interfaz gráfica «WSU GPU».

El soporte se implementa mediante la virtualización del acceso a la GPU y la provisión de controladores a través de los cuales pueden funcionar los subsistemas gráficos regulares de las distribuciones de Linux, incluidos los basados ​​en Wayland. Las aplicaciones gráficas de Linux y Windows pueden ejecutarse lado a lado en el escritorio de Windows.

Se ha preparado un controlador dxgkrnl abierto para el kernel de Linux, que proporciona un dispositivo /dev/dxg con servicios que repiten el modelo de controlador de pantalla de Windows (WDDM) D3DKMT del kernel de Windows. El controlador establece una conexión a la GPU física utilizando el bus VM. Las aplicaciones de Linux tienen el mismo nivel de acceso a GPU que las aplicaciones nativas de Windows sin compartir recursos entre Windows y Linux.

Además, la biblioteca libd3d12.so se proporciona para Linux, que proporciona la API gráfica completa de Direct3D 12.

La biblioteca libd3d12.so está construida a partir del mismo código que la implementación nativa de Windows de Direct3D 12 y es completamente similar en funcionalidad a la biblioteca d3d12.dll.

También se proporciona una versión simplificada de la API DXGI (DirectX Graphics Infrastructure) en forma de la biblioteca DxCore (libdxcore.so). Las bibliotecas libd3d12.so y libdxcore.so son propietarias y se entregan solo en compilaciones binarias (montados en WSL como /usr/lib/wsl/lib), compatibles con Ubuntu, Debian, Fedora, Centos, SUSE y otras distribuciones basadas en Glibc.

El soporte para OpenGL en Mesa se proporciona a través de una capa que traduce las llamadas a la API de DirectX 12. El método para implementar la API de Vulkan aún se encuentra en la etapa de planificación.

En la primera etapa, en entornos WSL, se admitirán CUDA y DirectML, trabajando sobre la API D3D12 (por ejemplo, en un entorno Linux, puede ejecutar TensorFlow con un back-end para DirectML). El soporte de OpenCL es posible a través de una capa que realiza la asignación de llamadas en la API DirectX 12.

Microsoft está desarrollando su administrador compuesto utilizando el protocolo Wayland y basado en la base de código Weston. El administrador compuesto usa RDP-RAIL (Aplicación remota RDP integrada localmente) para organizar la salida de la interfaz de la aplicación Linux al escritorio principal de Windows. RDP-RAIL difiere del backend RDP disponible anteriormente en Weston en que el administrador compuesto no renderiza el escritorio en sí, sino que redirige las superficies individuales (wl_surface) a través del canal RDP RAIL para mostrarlas en el escritorio principal de Windows.

Además de que pronto se admitirá una instalación WSL con el simple comando wsl.exe –install.

Finalmente si quieres conocer mas al respecto, puedes consular los detalles en el siguiente enlace. 

from Linux Adictos https://ift.tt/2XErijp
via IFTTT

Burst Buffers, será una de las nuevas características de Reiser5

Hace ya varios meses hablamos aquí en el blog sobre Reiser5, el cual es un sistema de archivos mantenido por Edward Shishkin y el cual se destaca por incluir la innovación en el escalado paralelo, que se lleva a cabo no a nivel de bloque, sino a través del sistema de archivos.

Reiser5 es una versión sustancialmente revisada del sistema de archivos ReiserFS, en la cual se implementa el soporte para volúmenes lógicos escalables paralelos, lo que permite una distribución eficiente de datos a través de un volumen lógico.

Ahora, en noticias mas recientes, Eduard Shishkin anunció nuevas características que se están desarrollando como parte del proyecto Reiser5.

De las innovaciones recientes, se ha observado que el usuario puede agregar un pequeño dispositivo de bloque de alto rendimiento (por ejemplo, NVRAM), llamado disco proxy, a un volumen lógico relativamente grande compuesto por discos de bajo presupuesto. Esto dará la impresión de que todo el volumen está compuesto por los mismos dispositivos de alto rendimiento que el «disco proxy».

El método implementado se basó en una simple observación de que, en la práctica, la escritura en un disco no se realiza constantemente y la curva de carga de E/S tiene una forma de pico. En el intervalo entre tales «picos», siempre existe la oportunidad de volcar datos de un disco proxy sobrescribiendo todos los datos (o solo una parte) en el almacenamiento principal «lento» en segundo plano. Por lo tanto, la unidad proxy siempre está lista para recibir una nueva pieza de datos.

Inicialmente, esta técnica (conocida como Burst Buffers) se originó en el campo de la informática de alto rendimiento (HPC). Pero resultó ser que también demandaba aplicaciones ordinarias, especialmente para aquellas que imponen altas exigencias a la integridad de los datos (por lo general, este es un tipo diferente de base de datos). Dichos cambios se realizan atómicamente por cualquier aplicación en cualquier archivo, a saber:

  • Primero se crea un nuevo archivo que contiene los datos modificados;
  • Entonces este nuevo archivo se escribe en el disco usando fsync (2);
  • Después de eso, el nuevo archivo cambia de nombre al antiguo, lo que libera automáticamente los bloques ocupados por datos antiguos.

Todos estos pasos, en un grado u otro, causan una disminución significativa en el rendimiento en cualquier sistema de archivos. La situación mejora si el nuevo archivo se escribe primero en un dispositivo dedicado de alto rendimiento, que es exactamente lo que sucede en el sistema de archivos Burst Buffers.

En Reiser5, está previsto enviar opcionalmente no solo nuevos bloques lógicos del archivo al disco proxy, sino también todas las páginas sucias en general. Además, no solo páginas con datos, sino también con metadatos, que se registran en los pasos (2) y (3).

Los discos proxy son compatibles en el contexto del trabajo regular con los volúmenes lógicos Reiser5 anunciados a principios de año. Es decir, el sistema agregado «disco proxy – almacenamiento primario» es un volumen lógico ordinario, con la única diferencia de que el disco proxy tiene prioridad sobre otros componentes del volumen en la política de asignación de direcciones de disco.

Agregar un disco proxy a un volumen lógico no va acompañado de ningún reequilibrio de datos, y su eliminación se produce de la misma manera que la eliminación de un disco normal. Todas las operaciones de disco proxy son atómicas.

Después de agregar un disco proxy, la capacidad total del volumen lógico aumenta en la capacidad de este disco.

El disco proxy debe limpiarse periódicamente, es decir volcar datos de él al almacenamiento principal. Después de alcanzar la estabilidad beta de Reiser5, se planea hacer que la limpieza sea automática (estará a cargo de un hilo especial del núcleo). En esta etapa, la responsabilidad de la limpieza recae en el usuario.

Si no hay espacio libre en el disco proxy, todos los datos se escriben automáticamente en el almacenamiento principal. Al mismo tiempo, el rendimiento general del FS se reduce por defecto (debido a la invocación constante del procedimiento de confirmación de todas las transacciones disponibles).

Fuente: https://marc.info

from Linux Adictos https://ift.tt/3entmDa
via IFTTT

RangeAmp: una serie de ataques CDN que manipulan el encabezado Range HTTP

Un equipo de investigadores de la Universidad de Pekín, la Universidad de Tsinghua y la Universidad de Texas en Dallas dieron a conocer información sobre su trabajo realizado para poder identificar una nueva clase de ataques DoS a los cuales nombraron como «RangeAmp» y los cuales se basan en el uso del encabezado Range HTTP para organizar la amplificación del tráfico a través de la red de entrega de contenido (CDN).

La esencia del método es que, debido a la peculiaridad de procesar encabezados Range en muchos CDN, un atacante puede solicitar un byte de un archivo grande a través de CDN, pero el CDN descargará el archivo completo o un bloque de datos significativamente más grande del servidor de destino para el almacenamiento en caché.

El grado de amplificación del tráfico durante un ataque de este tipo, según la CDN, es de 724 a 43330 veces, lo que se puede utilizar para sobrecargar el tráfico de CDN entrante o reducir el ancho de banda del canal de comunicación final al sitio de la víctima.

El encabezado Range permite al cliente determinar el rango de posiciones en el archivo que se debe cargar en lugar de devolver el archivo completo.

Por ejemplo, el cliente puede especificar «Rango: bytes = 0-1023» y el servidor transmitirá solo los primeros 1024 bytes de datos. Esta característica es muy solicitada cuando se descargan archivos grandes: el usuario puede pausar la descarga y luego continuarla desde la posición interrumpida. Al especificar «bytes = 0-0», el estándar prescribe dar el primer byte en el archivo, «bytes = -1» – el último, «bytes = 1-» – desde 1 byte hasta el final del archivo. Puede transferir varios rangos en un encabezado, por ejemplo, «Rango: bytes = 0-1023.8192-10240».

Además, se propuso una segunda opción de ataque (se llama ataque RangeAmp Overlapping Byte Ranges (OBR), destinada a aumentar la carga de la red cuando el tráfico se reenvía a través de otro CDN, que se utiliza como proxy (por ejemplo, cuando Cloudflare actúa como el frontend (FCDN) y Akamai actúa como el backend (BCDN)). El método se asemeja al primer ataque, pero está localizado dentro de las redes CDN y le permite aumentar el tráfico cuando accede a través de otras CDN, lo que aumenta la carga en la infraestructura y reduce la calidad del servicio.

La idea es que el atacante envíe varios rangos a la solicitud de rango de CDN, como «bytes = 0-, 0-, 0 -…», «bytes = 1-, 0-, 0 -…» o » bytes = -1024,0-, 0 -… «.

Las solicitudes contienen una gran cantidad de rangos «0-«, lo que implica el retorno del archivo desde cero hasta el final. Debido al análisis de rango incorrecto cuando el primer CDN se refiere al segundo, se devuelve un archivo completo a cada banda «0-» (los rangos no se agregan, pero se ordenan secuencialmente) si la duplicación e intersección de rangos están presentes en la solicitud de ataque enviada originalmente. El grado de amplificación del tráfico en dicho ataque varía de 53 a 7432 veces.

El estudio examinó el comportamiento de 13 CDN: Akamai, Alibaba Cloud, Azure, CDN77, CDNsun, Cloudflare, CloudFront, Fastly, G-Core Labs, Huawei Cloud, KeyCDN, StackPath y Tencent Cloud.

«Desafortunadamente, aunque les enviamos correos electrónicos varias veces y tratamos de comunicarnos con sus servicios al cliente, StackPath no proporcionó ningún comentario», dijo el equipo de investigación.

«En general, hemos hecho todo lo posible para informar de manera responsable las vulnerabilidades y proporcionar soluciones de mitigación. Los proveedores de CDN relacionados han tenido casi siete meses para implementar técnicas de mitigación antes de que se publicara este documento».

Todos los CDN revisados ​​permitieron el primer tipo de ataque en el servidor de destino. La segunda versión del ataque CDN resultó estar expuesta a 6 servicios, de los cuales cuatro pueden actuar como una interfaz en el ataque (CDN77, CDNsun, Cloudflare y StackPath) y tres en el papel de un back-end (Akamai, Azure y StackPath).

La mayor ganancia se logra en Akamai y StackPath, que permiten indicar más de 10 mil rangos en el encabezado Rango.

Los propietarios de CDN fueron notificados acerca de las vulnerabilidades hace aproximadamente 7 meses y para el momento de la divulgación pública de información, 12 de 13 CDN resolvieron los problemas identificados o expresaron su disposición a solucionarlos.

Fuente: https://www.liubaojun.org

from Linux Adictos https://ift.tt/2X4NOTj
via IFTTT

El cambio de MIcrosoft hacia el código abierto. La explicación de un ex ejecutivo

El cambio de Microsoft
Cada vez que alguno de los autores de Linux Adictos (creo que soy el que más lo hace) escribe un artículo positivo sobre Microsoft, muchos lectores reaccionan como si estuviéramos sirviendo sopa de ajo en la cena anual de los vampiros. Esto tiene origen en la actitud decididamente hostil de la empresa hacia el código abierto que mantuvo bien entrada la primera década del siglo XXI.

Muchos tenemos en claro cuál fue el motivo del cambio de la empresa, pero, al menos en mi caso, no había entendido la razón de la hostilidad. Después de todo, Linux jamás superó la cuota del 2% del mercado de escritorio.

Ahora Steven Sinofsky, ex responsable de Windows y Office dio una explicación sobre la causa detrás de declaraciones como esta de el ex máximo ejecutivo de la empresa Steve Ballmer:

Linux es un cáncer que se adhiere en un sentido de propiedad intelectual a todo lo que toca.

Sinofsky respondió en su cuenta de Twitter a una afirmación del principal consejero legal de Microsoft quien en una charla en el MIT aseguró:

Microsoft estaba en el lado equivocado de la historia cuando el código abierto explotó a principios de siglo, y puedo decir eso de mí personalmente.

Sinofsky considera que no es tan así, no es que Microsoft estuviera equivocado, si no que tenía un modelo de negocios basado en el software como propiedad intelectual, y que ese modelo tenía sentido cuando la empresa fue fundada.

Hasta no hace mucho tiempo la distribución de software costaba dinero. Pasó bastante tiempo desde la popularización de Internet hasta que todo el mundo (o al menos la mayor parte) tuviera acceso a una conexión decente en su hogar o trabajo. Los más antiguos de nuestros lectores recordarán cuando podías pedirle a Canonical que te mandara gratis un cd de Ubuntu. La otra forma era comprar una revista que regalara el cd o comprarlo en alguna tienda online.

En el sector corporativo, el software era parte de un combo con un costoso hardware que tenías que comprar o alquilar o parte de un servicio de consultoría que tenías que contratar.

Los orígenes del modelo de negocios de Microsoft

El ex responsable de Windows recuerda que a principios de los 70 los entusiastas de la electrónica compraban kits que les permitían armar sus propios proyectos (algo así como bisabuelos de Raspberry Pi o Arduino) que podían programarse. El software para programarlo se compartía libremente.

Bill Gates y su amigo Paul Allen crearon una versión del lenguaje de programación Basic para los equipos Altair. Su creación fue un éxito inmediato. Tan inmediato que su código fuente (impreso) se compartía sin parar.

Esto motivó la queja de Bill Gates quién hizo pública una carta en la que se quejaba de que habían invertido 40000 dólares en tiempo y dinero y solo habían conseguido recuperar una mínima parte por culpa de distribución ilegal.

Estamos hablando del primer producto de Microsoft como empresa.

No es de extrañar que durante 3 décadas la empresa viera como un peligro todo lo que amenazara su modelo de negocios basado en que la gente pague por cada copia del software. Más adelante otras compañías independientes basadas en el desarrollo de software como Corel o Adobe adoptaron un esquema similar y defendieron celosamente su propiedad intelectual.

De hecho, el código abierto no cuestiona el modelo de propiedad intelectual, simplemente aumenta la cantidad de cosas que se autoriza hacer al usuario.

El cambio de Microsoft

En realidad ni Linux ni las alternativas de código abierto fueron un problema para Microsoft en el escritorio. El problema apareció en los servidores.

Dice Sinofsky que Linux fue (y sigue siendo) mucho mejor que WindowsNT en los servidores. Por un tiempo, Microsoft pudo contar con la ventaja de que los clientes corporativos preferían el respaldo de una empresa a montar sus propias soluciones por mejor rendimiento y menos costos que tuvieran.

Todo cambió cuando IBM y otras empresas competidoras de Microsoft (junto a la aparición de licencias abiertas menos restrictivas que la GPL) descubrieron las ventajas de brindar servicios basados en el código abierto, junto a nuevas opciones de comercialización. La única ventaja de Microsoft en el sector más rentable del pastel se había terminado.

Para terminar de complicar la cosa, aparecen Google y Amazon que en lugar de distribuir software venden el servicio de ejecutar el software. ¿Para que ibas a comprar una licencia de Office si puedes usar el procesador de textos o enviar correos electrónicos desde tu navegador?. Y, en muchos casos gratis.

Tampoco vas a comprar la licencia de un sistema operativo para cada una de las computadoras de tu empresa cuando puedes ejecutar ese mismo sistema operativo en una máquina virtual desde cualquier computadora pagando solo por el tiempo que lo usas.

Con un modelo de negocios basado en la venta de licencias sin futuro, a Microsoft no le quedó más remedio que aceptar la realidad y apoyar al código abierto que está mejor preparado para brindar a los clientes lo que necesitan.


from Linux Adictos https://ift.tt/3gprGe9
via IFTTT

¿Cómo ser nativo en Kubernetes? by Markus Eisele

Markus Eisele

Kubernetes es un gran proyecto conocido por todos, especialmente para el despliegue y gestión de apps en contenedores. Y Markus Eisele, EMEA Developer Adoption Lead de Red Hat, tiene algunos detalles importantes para todos los interesados en aprender sobre él.

Y es que el desarrollo empresarial siempre ha sido uno de los grandes retos de la ingeniería informática, y en especial de empresas como Red Hat. Es por eso que en la última década se ha pasado de la arquitectura clásica de 3 niveles a una novedosa arquitectura con microservicios altamente distribuidos para conseguir recursos de infraestructura casi ilimitados para los proveedores de la nube pública. Además, dichos microservicios se pueden especializar en tareas muy específicas y simples, frente a los obsoletos servidores de apps pesados.

Red

Estos microservicios implican una mejor eficiencia en cuanto a recursos consumidos, lo que supone otra gran ventaja. Además, es una de las mejores formas de desplegar estas apps a través de contenedores, como si de pequeñas máquinas virtuales se tratasen. Aunque la principal diferencia entre una MV y un contenedor es que el primero no tiene un sistema operativo, en vez de eso se ejecuta en un espacio de usuario del kernel del sistema operativo host, como si de una app se tratase. Esto también implica mayor seguridad.

Pero no todo iban a ser ventajas, ya que esta arquitectura necesita de muchos contenedores (uno por servicio o más), lo que significa que la forma en la que se gestionan y coordinan podría ser compleja y representar un mayor esfuerzo para el administrador del sistema. Es aquí donde Kubernetes entra en escena y lo hace todo mucho más fácil.

Configuración de un entorno nativo en Kubernetes

Kubernetes logo

Kubernetes facilita la labor de los administradores, posibilitando una gestión de las apps y servicios más automatizada. Buscando una analogía, sería como la autoridad portuaria en un embarcadero, que posibilita que los barcos se muevan de forma simultanea dentro del espacio.  Es decir, en un inicio se podrían comparar las capacidades de Kubernetes con las de Java EE, ya que ambos ejecutan apps en hardware físico distribuido. No obstante, los contenedores se preocupan bien poco de los requisitos de la propia app.

Con Kubernetes se puede configurar un cluster escribiendo archivos de configuración en formato texto (YAML principalmente, aunque también admite JSON). En su interior estarán los parámetros o especificaciones de cada objeto definido para la gestión.

Hardware para la configuración local de Kubernetes

Servidor

Para poder aprovechar las ventajas de la alta escalabilidad y fiabilidad que proporciona un cluster de Kubernetes, los desarrolladores y administradores se deben encargar de dotar al contenedor de suficientes recursos para que se pueda ejecutar.

Si se asume que un cluster tiene dos master nodes con 2 GB de RAM, 4 cores, y 2 worker nodes de 1 GB de RAM y 2 cores, entonces un cluster de Kubernetes necesitará de 6 GB de RAM y 12 cores como mínimo. Unos recursos que no todos los ordenadores de sobremesa pueden suministrar, aunque bien es cierto que este proyecto no está pensado para el escritorio.

No obstante, en la actualidad hay un número de entornos de aprendizaje más pequeños que posibilitan que los desarrolladores puedan desarrollar con Kubernetes en entornos locales. Ejemplos de ellos son MiniKube, MicroK8s, OpenShift CodeReady Cointainers, etc. Todos ellos clusters de 1 solo nodo para poderlos tener en un PC de sobremesa y cuya instalación puede hacerse en unos pocos minutos.

Para probar un servicio de entornos más complejo, normalmente hay que acudir a un cluster verdadero de Kubernetes. Pero la herramienta Code Ready Containers puede facilitar mucho la vida del desarrollador, incluyendo todo el kit de herramientas e instalación de un solo nodo de un cluster de Kubernetes.

La adopción del nativo en Kubernetes es un mundo diferente

Kubernetes ha venido para cambiar toda la experiencia de los desarrolladores, que ven cómo la forma de administrar estos servicios es totalmente diferente e integrada. Por ello, la adopción de Kubernetes se ha transformado en el siguiente paso lógico hacia la simplificación para el desarrollador.

Así mismo, Kubernetes posibilita una mayor flexibilidad, con ayuda y herramientas para el desarrollo productivo de nativo de Kubernetes, y nuevos y fascinantes desafíos…

from Linux Adictos https://ift.tt/2XyYtok
via IFTTT

Llega la primera portátil con componentes AMD y Linux en su interior

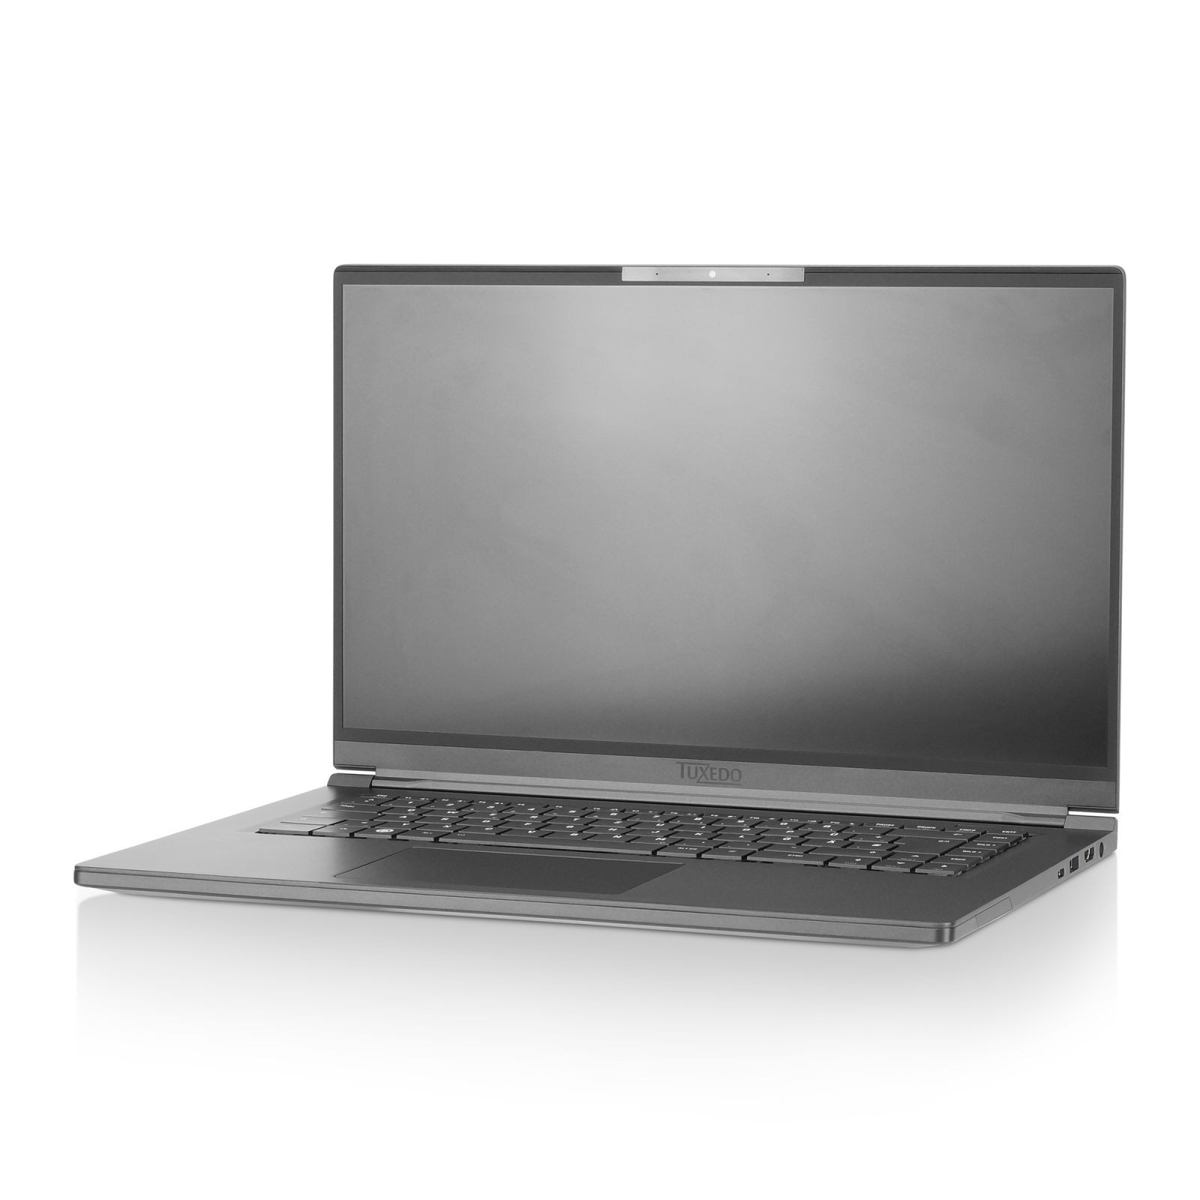
TUXEDO Computers, una de las compañías que está apostando en portátiles con Linux, anuncio esta semana un modelo que viene con características que lo separan del resto de las alternativas.

La TUXEDO Book BA15 esta potenciada por un chip AMD Ryzen 5 3500U y se jacta de ser “la primera portátil Linux que utiliza únicamente componentes AMD”.

La BA15 sobresale en términos de rendimiento de batería, con su unidad de 91.25 Wh puede ofrecer hasta 25 horas por carga en el modo de ahorro.

“Incluso en la situación más cotidiana, la portátil de 15.6 pulgadas dura bastante tiempo, así puedes hacer tu trabajo diario, navegar en la web, escribir correos y muchas otras cosas por al menos 13 horas, incluso con streaming de video a 1080p con el brillo al 50%, el dispositivo obtiene 10 horas de batería”, menciona la compañía.

https://platform.twitter.com/widgets.js

Windows opcional

La portátil tiene una tarjeta grafica integrada Radeon Vega 8 y tres opciones de memoria RAM, todas de la marca Samsung. La opción de punta viene con 32 GB de RAM.

En almacenamiento, el modelo base tiene 250GB, pero se puede actualizar hasta 2TB por un extra.

La pantalla de 15.6 pulgadas tiene una resolución full HD y 300 nits de brillo, mientras que el teclado viene con una super tecla TUX.

En cuanto a los puertos, hay un puerto USB 3.2 Tipo C que puede ser usado como DisplayPort o para cargar, dos puertos USB 3.2 Tipo A, un puerto USB 2.0 Tipo A, así como conexión HDMI, Ethernet, lector de tarjetas y ranura para audífonos.

Tuxedo Computers vende la BA15 con Ubuntu y TUXEO_OS, pero hay muchas otras opciones disponibles. Por ejemplo, la compañía también ofrece una configuración con boot doble con Windows e incluso puede quitar Linux completamente si el cliente lo desea.

from Linux Adictos https://ift.tt/3gjiwjg
via IFTTT

Seedr: el mejor cliente web para descargar torrents que podemos usar en cualquier navegador en 2020

seedr.cc

Desde su aparición hace ya más de 15 años, compartir archivos por la red Torrent (BitTorrent) es una de las opciones más rápidas y seguras. Prácticamente desde sus inicios ha habido clientes torrent disponibles, como lo fueron Azureus (ahora Vuze) u otros más recientes y extendidos como Transmission, del que recientemente han lanzado la v3.0. Pero, ¿qué pasa cuando no podemos instalar software en un equipo? Que una de las mejores opciones es Seedr, un servicio que nos permitirá hacerlo todo desde un navegador web.

Antes de que alguien pregunte por qué podemos necesitar servicios como Seedr, podemos imaginar varias situaciones en las que no podamos descargar un cliente torrent. Por ejemplo, si queremos descargar un torrent en un ordenador que no es nuestro, como puede ser el de nuestra oficina. O, por qué no decirlo, el sistema operativo que usamos restringe este tipo de aplicaciones, algo que pasa en iOS y el recientemente renombrado iPadOS. Seedr funciona incluso en los dispositivos de Apple.

Cómo descargar un torrent con Seedr.cc

Lo peor de Seedr es que sólo funciona con registro, pero es un bajo precio a pagar para poder descargar torrents en cualquier parte o dispositivo. Los pasos a seguir serían los siguientes:

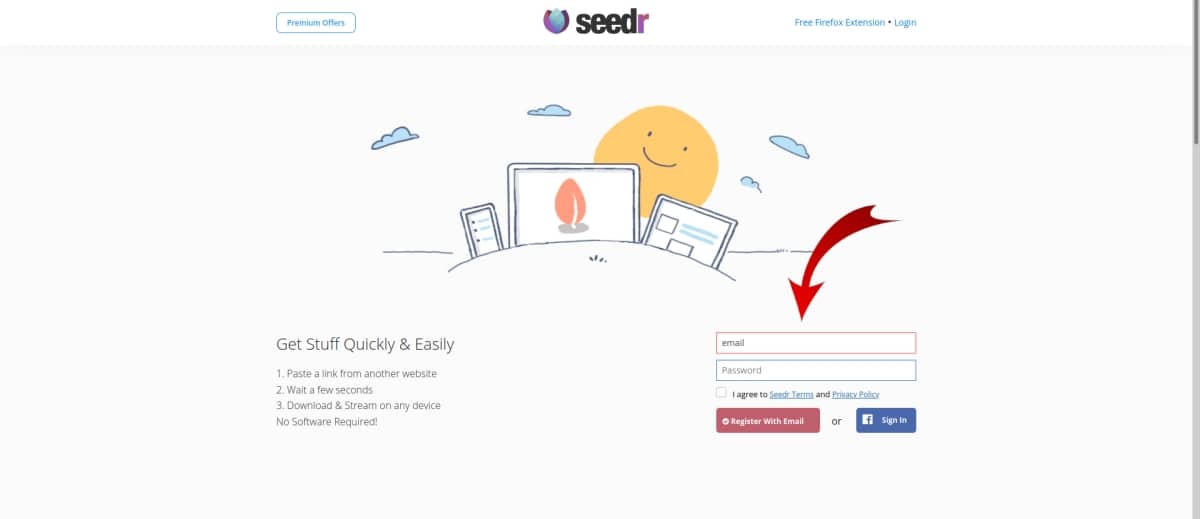
  1. Abrimos un navegador.
  2. Vamos a la página del proyecto.
  3. Añadimos un correo y una contraseña para registrarnos. Importante poner un correo real o, de lo contrario, no podremos completar el registro.

Registrarse en seedr

  1. A continuación, comprobamos la bandeja de entrada del correo, buscamos el mail y completamos el registro. Es probable que tengamos que esperar un rato y en ocasiones puede no llegar. Si se da el caso, hay que escribir un correo al equipo de soporte del proyecto. Los pasos del 1 al 4 ya no tendremos que volver a hacerlos.
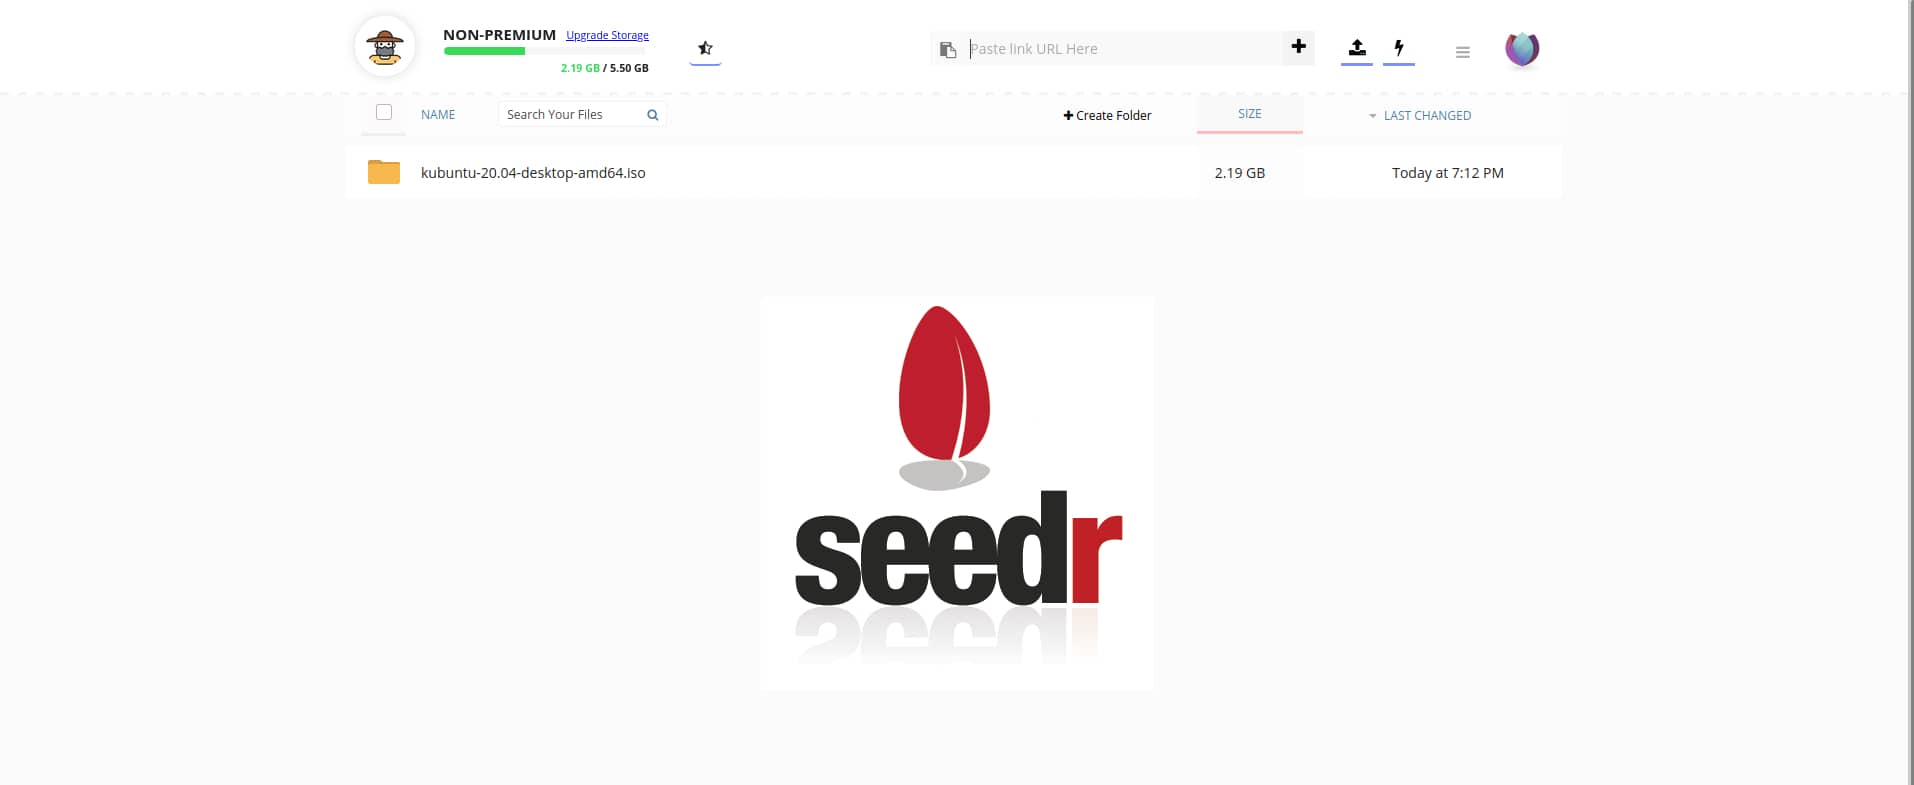
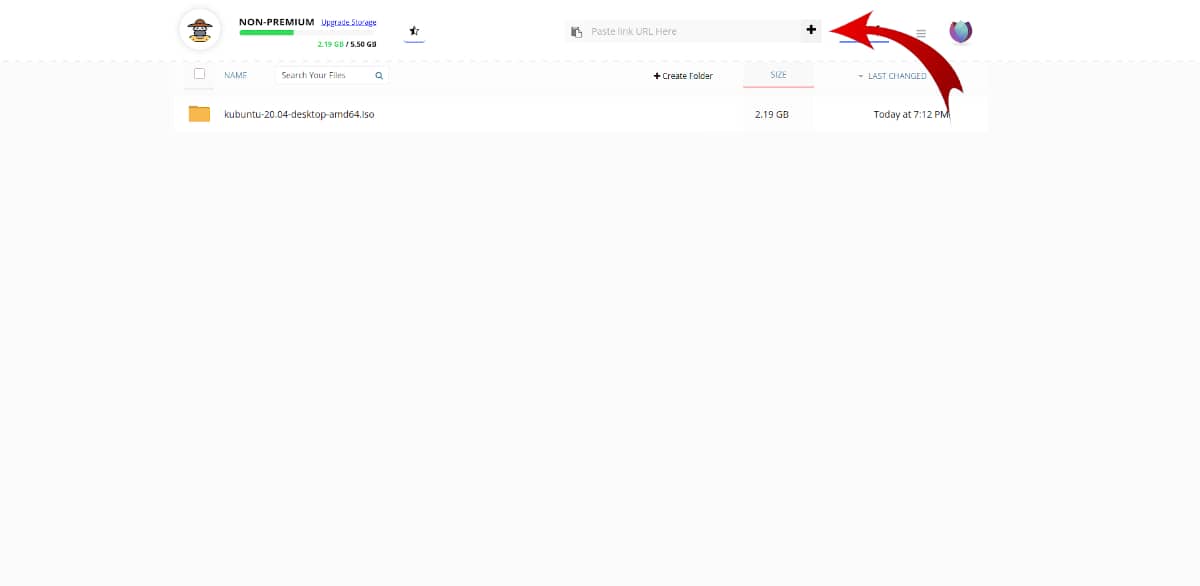
  2. Una vez dentro de la página principal, veremos algo como lo tenéis debajo de estas líneas (sin el archivo añadido). Lo que tenemos que hacer ahora es conseguir un enlace .magnet. Aunque puede haber muchos casos en los que descargar un torrent sea legal, no podemos facilitar webs de búsquedas de enlaces .magnet por un tema legal.
  3. Copiamos el enlace .magnet. Si lo que tenemos es un archivo .torrent, podemos convertirlo a magnet en Torrent2Magnet.
  4. A continuación, volvemos a Seedr, pegamos el enlace en donde pone «Paste link URL Here» y presionamos intro. Se añadirá como tarea. Como veis, yo he añadido el .magnet para descargar Kubuntu 20.04 LTS Focal Fossa.

pegar enlace magnet

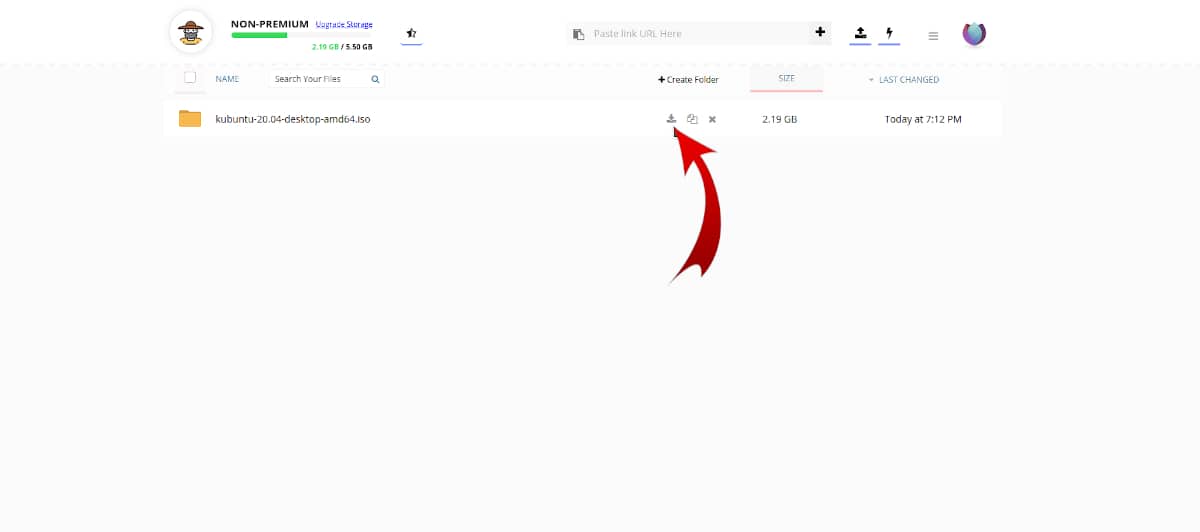
  1. Una vez añadida la tarea, tenemos que empezar la descarga. Movemos el cursor por encima de ella y aparecerán las opciones para descargar, copiar o eliminar. Tenemos que hacer clic en el primer icono. Nos ofrecerá descargar el archivo tal y como descargaríamos cualquier otro archivo de internet.

descargar torrent

  1. Esperamos a que se complete la descarga.
  2. Por último, descomprimimos el archivo, ya que Seedr lo comprime automáticamente en ZIP.

Funciona en cualquier navegador, pero con restricciones

Lo mejor de Seedr es que funciona en cualquier navegador. Así como hay servicios como instant.io o btorrent.xyz que, aunque espero que mejoren, funcionan cuando quieren (casi nunca), Seedr funciona a la perfección en todo tipo de navegadores, incuso los móviles más restringidos. Lo único necesario para que funcione directamente desde el navegador es que éste permita descargar archivos, algo que ya permite hasta el navegador del iPhone.

Lo malo es que tiene limitaciones. La versión gratuita sólo nos permite descargar archivos de hasta 2GB de tamaño, pero esta capacidad se puede aumentar si difundimos la voz e invitamos a gente vía Twitter, correo, Facebook o Pinterest. Si necesitáis eliminar todas las restricciones, podemos hacernos Premium con tres tipos de suscripción diferente:

  • Básico: por 6.95€/mes podremos descargar más rápido, reproducir archivos en HD y subiremos el tope a 30GB.
  • Pro: por 9.95€/mes podremos usar trackers privados, guardar más archivos, descargas más rápidas y 100GB de tope.
  • Master: por 19.95€/mes también podremos montar Seedr como una unidad de red o incluso usar scripts, subiendo el tope hasta 1TB de almacenamiento.

Lógicamente, lo explicado en este artículo no es muy interesante para los que podemos instalar un cliente en nuestro equipo, pero seguro que no opinan lo mismo los que no pueden y harán de Seedr uno de sus servicios web favoritos.

from Linux Adictos https://ift.tt/36qWeaS
via IFTTT

¡Linus Torvalds se pasa a AMD para compilar más rápido!

linustorvalds

Muchas veces se ha rumoreado con la distribución que usa Linus Torvalds, o sus equipos de hardware. Esta vez ha sido el propio Torvalds el que ha hecho una interesante declaración mientras publicaba la nueva versión Linux 5.7-rc7. El texto publicado en la LKML era bastante normal, sin nada destacable, pero aprovechó para hablar de su nuevo equipo…

Linus Torvalds asegura que ahora usa una CPU de AMD, algo que no ocurría desde hace 15 años que lleva usando Intel. No obstante, las aspiraciones de Linus Torvalds, y de muchos, pasan por abandonar x86 y pasarse definitivamente a la eficiente ARM. De hecho, han sido muchas las críticas de Linus a Intel, especialmente por las vulnerabilidades de sus chips. Pero por el momento, x86 es lo que hay para tener un PC potente.

En el comunicado de LKML se podía leer: «Lo más emocionante de esta semana para mi es que actualicé mi máquina principal, y por primera vez en 15 años mi ordenador de escritorio no usa Intel. No, todavía no me he cambiado a ARM, pero ahora estoy disfrutando de un AMD Threadripper 3975X. Mis builds de prueba ‘allmodconfig’ son ahora tres veces más rápidas de lo que solían ser, algo que no importa mucho ahora durante el periodo de calma, pero definitivamente lo notaré durante la próxima ventana de cambios.«.

Estas builds ‘allmodconfig’ de las que habla Linus Torvalds son compilaciones del kernel Linux con todos los módulos habilitados para probar, lo que significa un gran peso a la hora de compilar, y donde la bestia de procesamiento de AMD está ayudando a que se compilen hasta 3 veces más rápido. Y no me extraña, ya que la microarquitectura Zen 2 es una maravilla, y sus 32 núcleos con 64 threads en paralelo no son menos…

Desde la compañía del logo verde seguro que están encantadísimos con la tremenda publicidad que les acaba de hacer nada menos que un gurú como es Linus Torvalds…

from Linux Adictos https://ift.tt/3eiEb9y
via IFTTT