Google desmantela una red de proxies residenciales con 1,3 millones de dispositivos Android


Google ha liderado la operación para desmantelar una extensa red de proxies residenciales que llegó a integrar más de 1,3 millones de dispositivos, en su mayoría decodificadores Android. La investigación apunta a un caso especialmente preocupante: el malware no habría llegado a los equipos por una vulneración externa de la cadena de suministro, sino que habría sido instalado deliberadamente por el fabricante Videostrong.

Según explicó Google en una publicación de su equipo de inteligencia de amenazas, una puerta trasera denominada XCPE permitió incorporar dispositivos a la botnet, cometer fraude publicitario y facilitar la instalación de otros programas maliciosos. La red también ofrecía a terceros acceso al ancho de banda y a las direcciones IP residenciales de los dispositivos afectados.

### Un abuso de confianza desde el origen

Los equipos se comercializaban como productos Android legítimos de un fabricante certificado. Sin embargo, Google sostiene que Videostrong desarrolló el malware, lo incorporó a sus dispositivos y empleó técnicas de ocultación para dificultar su detección. La compañía habría vendido los productos a consumidores y, por otra parte, ofrecido acceso a la red a ciberdelincuentes.

Las redes de proxies residenciales pueden utilizarse para ocultar el origen de actividades maliciosas, lanzar ataques distribuidos de denegación de servicio (DDoS), realizar campañas de robo de credenciales, eludir restricciones geográficas o recopilar información de sitios web a gran escala. No se ha divulgado cuánto habría obtenido Videostrong ni quiénes utilizaron la infraestructura.

Google calificó la conducta como una grave vulneración de la confianza de los usuarios. En la operación participaron también la Agencia Nacional de Policía de Japón, Lumen, HUMAN Security, Plume, Synthient y TrendAI.

### Medidas para desactivar la red

Para interrumpir el funcionamiento de XCPE, Google y sus colaboradores deshabilitaron dominios y servidores usados para controlar la botnet y distribuir módulos maliciosos. También actuaron contra dominios de comando y control asociados con más de una docena de familias de malware que podían instalarse a través de la puerta trasera.

Además, Google prohibió a Videostrong y a sus futuras filiales y empresas vinculadas obtener certificación para fabricar o comercializar dispositivos Android, así como suministrar software a otros fabricantes certificados. La compañía afirmó que también reforzó las comprobaciones de integridad del firmware en dispositivos Android TV certificados.

Google señaló que Videostrong habría aprovechado una brecha en las pruebas de seguridad: el código malicioso se cargaba después del primer arranque del dispositivo, lo que dificultaba su detección durante el proceso de revisión. Como respuesta, la empresa modificó sus controles para reducir el riesgo de incidentes similares.

### Una advertencia para el sector y los consumidores

El caso se suma a otros informes sobre dispositivos Android vendidos con malware preinstalado. No obstante, Google distingue este episodio de aquellos en los que la cadena de suministro habría sido comprometida sin conocimiento ni consentimiento del fabricante. En este caso, la acusación central es que el propio proveedor habría creado y distribuido el software malicioso.

La operación muestra que la certificación de un producto no elimina todos los riesgos y que la seguridad debe mantenerse durante todo el ciclo de fabricación y distribución. Para los consumidores, conviene instalar las actualizaciones disponibles, descargar aplicaciones únicamente de fuentes confiables y prestar atención a comportamientos inusuales, especialmente en dispositivos económicos o de procedencia poco clara.

from Latest from TechRadar https://ift.tt/yWnK3SU
via IFTTT IA

La seguridad de la IA autónoma empieza por saber de dónde viene la información


El 6 de septiembre, el científico jefe de OpenAI, Jakub Pachocki, pareció lanzar una advertencia sobre el ritmo del avance de la inteligencia artificial. En su ensayo «An Alien Mind», sostuvo que las técnicas actuales de alineamiento y supervisión podrían quedarse cortas a medida que los sistemas se vuelvan más capaces. También describió un futuro en el que la IA participe cada vez más en la mejora de la propia IA, reduciendo el tiempo disponible para la supervisión humana y la respuesta institucional.

Buena parte de la investigación sobre seguridad de la IA se centra en el comportamiento: qué puede hacer un sistema, cómo se vigilan sus acciones y en qué momentos debe intervenir una persona. Pero antes de actuar, una IA debe decidir qué información considera fiable. Ese paso previo merece mucha más atención.

## La IA actúa a partir de información cuyo origen no siempre está claro

Antes de enviar un pago, modificar software o recomendar una decisión, un sistema de IA construye una representación del mundo. Para ello puede recurrir a resultados de búsqueda, registros empresariales, artículos de investigación y contenido generado por otros sistemas de IA.

Internet facilita la circulación de la información, pero no siempre conserva su historia. Una afirmación puede aparecer primero en un estudio, pasar a una noticia, resumirse en un blog y terminar meses después en un foro. Cuando una IA la encuentra, reconstruir el camino hasta la evidencia original puede ser difícil.

Además, fuentes de distinta calidad llegan al sistema en un formato parecido: texto. Un estudio revisado por pares, un comunicado empresarial y una publicación anónima pueden combinarse en una respuesta pulida, sin que el usuario perciba con claridad las diferencias entre evidencia, promoción y repetición.

El desacuerdo entre fuentes añade otra dificultad. En ámbitos como las finanzas, la medicina, la política y las tecnologías emergentes, incluso fuentes fiables pueden llegar a conclusiones distintas. Como los sistemas suelen estar optimizados para ofrecer respuestas útiles y directas, pueden condensar el conflicto en una sola afirmación. Así, la incertidumbre desaparece justo cuando convendría hacerla visible.

El riesgo aumenta cuando la IA puede actuar. Un agente puede ejecutar una operación financiera, aprobar una compra, modificar un programa o enviar un mensaje en nombre de una persona. En ese contexto, una afirmación incierta puede convertirse en la base de una acción difícil de revertir.

## La supervisión humana necesita mejores pruebas

La supervisión humana funciona cuando quien revisa dispone de información más completa o de medios fiables para verificar lo que utilizó la IA. Sin embargo, con frecuencia la persona encargada de aprobar una decisión consulta la misma web que el sistema, pero a una velocidad muy inferior. La IA puede analizar miles de páginas mientras el revisor examina un resumen y unos pocos enlaces.

A medida que aumentan las capacidades, la revisión corre el riesgo de convertirse en un trámite, en lugar de una evaluación independiente.

Pachocki señala que la posibilidad de confiar en el monitoreo de la cadena de pensamiento disminuye cuando el razonamiento se vuelve más complejo y los sistemas pueden manipular sus propios procesos de razonamiento. También propone establecer umbrales de seguridad que puedan aplicar auditores independientes, organismos gubernamentales o instituciones internacionales.

Esos mecanismos ayudan a gobernar las capacidades y el comportamiento. Pero la supervisión fiable también requiere un registro de evidencias: qué información sustentó la conclusión, de dónde procede cada afirmación, cuán confiable es la fuente y dónde persisten desacuerdos legítimos. Sin ese registro, el revisor evalúa la respuesta, pero no necesariamente sus fundamentos.

## La IA heredó uno de los hábitos más débiles de Internet

La IA se nutrió de una cultura informativa basada en la velocidad, el alcance y la reproducción de contenidos. Los buscadores, las redes sociales y los agregadores facilitaron el acceso a la información, pero también contribuyeron a que una misma afirmación aparezca cientos de veces y parezca ampliamente respaldada, aunque todas las repeticiones procedan de una única fuente dudosa.

La IA generativa amplifica el problema: los sistemas producen contenido que otros sistemas pueden incorporar después. Una afirmación débil puede generarse, recopilarse, resumirse y volver a publicarse hasta que la repetición le dé apariencia de consenso.

Cada nueva etapa puede alejar el contenido de la evidencia original. Y cuando un agente autónomo lo trata como fiable, la cadena de información pasa a formar parte de la cadena de decisiones. Para un consumidor, esto quizá termine en una recomendación deficiente. Para un banco, una aseguradora o una agencia pública, las consecuencias pueden afectar al dinero, el acceso a servicios, la seguridad o la vida cotidiana de las personas.

## La IA autónoma necesita un sistema de procedencia

Las operaciones financieras importantes dependen de registros que indiquen quién actuó, con qué autorización, bajo qué condiciones y con qué rastro de auditoría. Las instituciones invierten en esos mecanismos porque un resultado plausible no basta para generar confianza. La IA autónoma necesita una disciplina equivalente para la información.

Las afirmaciones deberían conservar su procedencia incluso al copiarse o transformarse. Tanto una persona como un agente deberían poder rastrearlas hasta su origen, examinar las pruebas y entender cómo cambiaron al circular. Los desacuerdos entre fuentes fiables también deberían mantenerse visibles.

Cuando fuentes reputadas discrepan, el sistema debería mostrar las distintas posturas y el nivel de confianza asociado a cada una. En un agente autónomo, la incertidumbre puede ser una señal para investigar más, solicitar aprobación humana o limitar el alcance de la acción.

La responsabilidad debe acompañar a la información. Una afirmación respaldada por una institución identificable y pruebas verificables no debería recibir el mismo trato que una aseveración anónima repetida en decenas de páginas. El objetivo es que la IA pueda evaluar mejor la calidad de la evidencia antes de comprometer recursos o actuar en nombre de alguien.

La gobernanza también debe ser compartida. Los estándares de procedencia, los métodos de verificación y las reglas de responsabilidad necesitan revisión independiente y participación de diversas instituciones, en lugar de depender de las preferencias de un único proveedor.

## Prepararse antes de que la IA actúe

Pachocki advierte que las técnicas actuales de alineamiento y monitoreo podrían limitar la capacidad de los laboratorios para ampliar sus sistemas de forma responsable. También prevé posibles pausas voluntarias mientras se desarrollan umbrales de seguridad compartidos y plantea que la IA podría asumir una parte creciente de su propio desarrollo.

Ante ese panorama, las empresas que construyen sistemas autónomos tienen una tarea fundamental: establecer qué sabe el agente antes de que actúe y hacer que ese conocimiento pueda auditarse.

Las salvaguardas de comportamiento siguen siendo esenciales, al igual que los permisos, las auditorías y la aprobación humana. Su eficacia aumenta cuando la información que sustenta cada decisión incluye procedencia, contexto y responsabilidad. Por eso, la próxima etapa de la seguridad de la IA comienza con la evidencia que recibe un agente, la autoridad que atribuye a cada fuente y la incertidumbre que conserva antes de actuar.

Una autonomía basada en información verificable ofrece a las personas una base más sólida para ejercer control. En cambio, cuando la información es opaca, quienes supervisan deben juzgar decisiones cuyos fundamentos son difíciles de examinar.

Pachocki tiene razón al advertir que el margen para prepararse podría ser limitado. La industria debería aprovecharlo para crear sistemas capaces de mostrar de dónde procede su conocimiento antes de confiarles decisiones que afectan al mundo real.

from Latest from TechRadar https://ift.tt/Uou9iWm
via IFTTT IA
Un solo límite de uso para ChatGPT y Codex: una apuesta que puede inquietar a los suscriptores


OpenAI se prepara para unificar el límite de uso de ChatGPT y su asistente de programación Codex. Según la documentación actualizada de la empresa, los suscriptores de los planes Plus, Pro y Business dispondrán de un único cupo compartido, en lugar de límites separados. Las tareas más complejas consumirán una mayor parte de ese cupo, mientras que las conversaciones habituales en modo Instant no se descontarán.

El cambio llega mientras OpenAI se dispone a integrar en ChatGPT las capacidades más autónomas de ChatGPT Work. Los usuarios podrán encargar proyectos complejos directamente desde una conversación. La comodidad de reunir estas funciones también implica compartir los recursos disponibles, un intercambio que podría frustrar a muchos clientes de pago.

OpenAI afirma que la mayoría de los suscriptores no debería tener que esperar a que se restablezcan sus límites con más frecuencia que ahora. Sin embargo, la compañía no ha precisado el tamaño de los nuevos cupos, lo que dificulta valorar esa promesa. Por el momento, pide a sus clientes que confíen en que sus suscripciones no perderán utilidad cuando cambien las reglas.

La empresa quiere convertir ChatGPT en una plataforma integral tanto para usuarios particulares como para profesionales que recurren a la IA en proyectos importantes. La idea de tenerlo todo en un mismo lugar resulta atractiva, pero OpenAI podría estar subestimando el malestar que provoca reorganizar un servicio conocido para atender necesidades muy distintas.

## Una suscripción, demasiadas expectativas

Para la mayoría, ChatGPT sigue siendo un asistente relativamente sencillo. Probablemente no les interese cuánto consume un agente de programación mientras desarrolla una aplicación. Por eso, el nuevo límite compartido puede resultar incómodo: alguien que usa ChatGPT para investigar y de vez en cuando prueba Codex podría ver cómo ambas actividades compiten por los mismos recursos.

Que las conversaciones en modo Instant queden fuera del cupo es una protección importante. En principio, las conversaciones cotidianas no deberían volverse inaccesibles porque alguien haya usado Codex con intensidad. Pero las tareas de razonamiento más exigentes sí contarán, y son precisamente esas capacidades las que justifican, en parte, pagar una suscripción.

Es posible que el cupo final sea lo bastante amplio como para que la mayoría apenas note el cambio. Algunos usuarios incluso podrían agradecer la flexibilidad de dedicar más recursos a la herramienta que prefieran. Pero, sin cifras claras, los clientes no tienen una forma concreta de saber si están obteniendo una mejor oferta.

Las reacciones de algunos usuarios reflejan que OpenAI ya se ha encontrado con ese problema. Un hilo de Reddit resume el sentir de ciertos suscriptores con el encabezado «La peor decisión de OpenAI». Un usuario escribió: «Definitivamente cancelaré la suscripción por esto; era la principal ventaja de tener un plan de 20 dólares junto al de 200 dólares de Claude».

El enfado expresa una preocupación más amplia: que OpenAI esté dando cada vez más prioridad a las herramientas profesionales de IA, en detrimento de quienes solo quieren usar ChatGPT sin preocuparse por cuánta capacidad de cómputo han consumido.

La frustración es comprensible, sobre todo a la luz de los recientes ajustes en los planes Pro. OpenAI dio marcha atrás en una reducción prevista de los límites de uso de Pro 200 después de las quejas de suscriptores y, al mismo tiempo, aumentó los cupos de otros planes. La respuesta fue positiva, pero no necesariamente inspira confianza cuando ya se avecina otro cambio importante en la forma de contabilizar el uso.

## Primero, las empresas

La pregunta de fondo es qué quiere que llegue a ser ChatGPT. Las capacidades cada vez más ambiciosas de Work están pensadas para ejecutar tareas sustanciales y acercan el producto a una plataforma de productividad profesional. Es un cambio considerable para un chatbot accesible que atrajo a millones de personas gracias a la conversación cotidiana.

OpenAI parece decidida a combinar dos experiencias distintas. El riesgo es que los usuarios comunes terminen usando un servicio cada vez más orientado a los flujos de trabajo profesionales.

La empresa tiene motivos comerciales para seguir ese camino. Las organizaciones están dispuestas a pagar cantidades importantes por una IA capaz de realizar tareas valiosas, mientras que las suscripciones para consumidores afrontan mayor presión para mantener precios asequibles. Reunir ambas experiencias podría animar a más personas a probar funciones avanzadas y, con el tiempo, hacer más atractivos los planes de mayor precio.

Pero quien paga por acceder a capacidades de razonamiento avanzadas debería poder saber, al menos aproximadamente, cuánto puede utilizarlas sin preguntarse si otra tarea ha agotado su cupo. Vigilar el consumo de tokens parece justo el tipo de carga administrativa que la IA prometía eliminar.

Antes de que los cambios entren en vigor en diciembre, OpenAI debería publicar límites comprensibles y explicar cómo afecta cada actividad al cupo compartido. Los clientes no deberían tener que experimentar por su cuenta para averiguar si su suscripción ofrece menos de lo que ofrecía antes.

Hacer que ChatGPT sea más potente puede ser una buena decisión. Hacer que sus usuarios sientan que reciben menos por su dinero sería una forma muy poco acertada de celebrar ese avance.

from Latest from TechRadar https://ift.tt/yVXLrkp
via IFTTT IA

Los robots domésticos podrían ser la nueva puerta de entrada a la IA


Meta estaría desarrollando un robot humanoide de aproximadamente 1,37 metros de altura y 48 kilos, capaz de mirar a las personas a los ojos, imitar expresiones y ayudar en el hogar. La descripción recuerda a otros robots de consumo que desarrollan empresas como Tesla, Unitree, Figure y Boston Dynamics. Pero, según un informe de *The Information*, este tendría una característica distintiva: sería una «encarnación física» de Muse, el asistente de IA de Meta.

Ese detalle ayuda a explicar por qué tantas compañías compiten por llevar robots humanoides a los hogares. No se trata únicamente de automatizar tareas. Los robots también podrían convertirse en una nueva forma de acercar a los consumidores a los sistemas de inteligencia artificial que estas empresas están desarrollando e intentando expandir.

## La IA busca un lugar en casa

La adopción de la inteligencia artificial no está garantizada. En Estados Unidos, el crecimiento de los centros de datos y el impacto de la IA en el empleo, la seguridad de las infraestructuras y la desinformación ocupan un espacio cada vez mayor en el debate público. Muchas personas observan esta tecnología con cautela, y algunas podrían reducir su uso de chatbots y agentes digitales.

La robótica despierta inquietudes propias. La ciencia ficción ha alimentado durante décadas el temor a máquinas fuera de control. Sin embargo, los vídeos de robots que bailan, manipulan objetos con destreza o realizan movimientos atléticos también generan curiosidad. La idea de una máquina incansable que se encargue de las tareas domésticas puede resultar atractiva, incluso para quienes desconfían de la IA.

Lo que a veces queda fuera de esas demostraciones es que la inteligencia artificial impulsa buena parte del progreso reciente en robótica. Los chips, los modelos y la infraestructura informática que hacen posibles estas máquinas conectan directamente el desarrollo de robots con la expansión de la IA y los centros de datos.

Las alianzas entre ambos sectores ya son habituales. Según los informes, el prototipo de Meta utilizaría el chip Jetson Thor de Nvidia, que también está presente en robots de otras compañías. Google DeepMind colabora con Boston Dynamics, mientras que Amazon ha incorporado empresas de robótica para reforzar sus operaciones logísticas. Apple, por su parte, estaría explorando cómo combinar Siri con dispositivos domésticos y proyectos robóticos.

Para las empresas tecnológicas, el hogar representa una oportunidad importante: integrar asistentes de IA en máquinas que no solo responden preguntas, sino que también pueden realizar tareas físicas.

## El coste de un asistente humanoide

Si los robots domésticos llegan a ser realmente útiles, podrían transformar la vida cotidiana. También podrían crear un modelo de negocio basado en suscripciones. Es probable que muchos robots sean demasiado caros para comprarlos directamente, por lo que las compañías podrían ofrecer alquileres mensuales que incluyan mantenimiento, acceso a modelos de IA y servicios digitales.

En lugar de pagar por separado por un chatbot o un asistente virtual, los usuarios pagarían por un servicio doméstico que incluye una máquina capaz de limpiar, organizar o ayudar con otras tareas. La comodidad sería evidente, pero también lo sería la dependencia de una plataforma, sus condiciones de uso y sus costes recurrentes.

## De las demostraciones a la autonomía

Hay, sin embargo, una distancia considerable entre las demostraciones virales y un robot que pueda trabajar de forma segura en una casa. Algunas hazañas que circulan en internet dependen de control remoto, secuencias programadas o condiciones cuidadosamente preparadas. Que un robot pueda caminar, correr o subir escaleras no significa que pueda desenvolverse con fiabilidad en un entorno doméstico impredecible.

Una casa está llena de obstáculos, personas, animales y objetos que cambian de lugar. Para ser útil, un robot tendría que reconocer esas situaciones, actuar con prudencia y evitar causar daños. La seguridad y la autonomía deben ser requisitos fundamentales, no detalles que se añadan después de lanzar el producto.

Es posible que en los próximos años aparezcan robots capaces de realizar tareas domésticas de forma fiable, ayudar a pasear al perro o prestar asistencia cotidiana. Pero su llegada dependerá de avances técnicos y de la confianza de los usuarios, además de que el precio y las condiciones de suscripción sean aceptables.

Los robots humanoides podrían llevar la IA a una nueva etapa: una en la que deje de vivir solo en pantallas y empiece a ocupar espacio en nuestros hogares. La pregunta no será únicamente qué pueden hacer, sino quién controla la tecnología, cuánto cuesta utilizarla y qué compromisos implica. El futuro de la robótica doméstica se acerca; conviene estar preparados tanto para sus posibilidades como para su factura.

from Latest from TechRadar https://ift.tt/yT01LrF
via IFTTT IA

Cómo proteger el contenido de tu sitio web frente al rastreo de IA


OpenAI, Google, Microsoft y Anthropic respaldan una señal compartida para que los sitios web expresen si permiten que sus contenidos se utilicen para entrenar modelos de inteligencia artificial. La señal se configura en el archivo robots.txt, una herramienta conocida por los administradores web que permite comunicar instrucciones a los rastreadores.

La iniciativa responde a una inquietud creciente: las empresas de IA recopilan grandes cantidades de información disponible en internet para desarrollar sus sistemas. Para muchos propietarios de sitios, que sus páginas sean accesibles al público no significa necesariamente que quieran que se incorporen a conjuntos de datos de entrenamiento.

No existe una medida única que impida todo rastreo. Las estrategias funcionan mejor cuando se combinan, aunque ninguna ofrece una garantía absoluta frente a bots que ignoran las instrucciones o intentan eludirlas. Estas son algunas opciones, junto con sus principales limitaciones.

1. Configurar el archivo robots.txt

El archivo robots.txt suele estar en el directorio raíz de un sitio y comunica a los rastreadores qué partes pueden visitar. También puede ayudar a orientar el rastreo y reducir solicitudes innecesarias a los servidores.

Para excluir páginas o el sitio completo, se pueden añadir reglas dirigidas a rastreadores concretos. Por ejemplo:

User-agent: GPTBot
Disallow: /

La regla anterior solicita al rastreador identificado como GPTBot que no acceda a ninguna ruta del sitio. Para limitar el acceso a una sección específica, se puede indicar esa ruta en lugar de /:

User-agent: GPTBot
Disallow: /archivo/

Los nombres de los rastreadores varían según el servicio. Antes de aplicar cambios, conviene consultar la documentación de cada proveedor y revisar el archivo para evitar bloquear por accidente rastreadores que sí se desean permitir. Las instrucciones de robots.txt son voluntarias: los bots que no las respetan pueden seguir intentando acceder al contenido.

2. Exigir una cuenta para acceder

Restringir el contenido a usuarios registrados puede dificultar el rastreo automatizado, especialmente cuando el registro requiere verificación. Sin embargo, esta medida introduce fricción: algunas personas abandonarán el sitio antes de crear una cuenta, y otras preferirán no compartir sus datos personales.

Si el acceso abierto es importante para el tráfico, la difusión o la misión del sitio, se puede reservar el registro obligatorio para contenidos específicos en vez de aplicarlo a todas las páginas.

3. Limitar las solicitudes por dirección IP

Los servicios de alojamiento y seguridad web suelen permitir limitar la frecuencia de las solicitudes procedentes de una misma dirección IP. Por ejemplo, se puede establecer un máximo de peticiones en un intervalo determinado para reducir el impacto de patrones de tráfico excesivos.

Este método puede proteger los servidores, pero no siempre identifica con precisión a los bots. Algunos rastreadores rotan entre varias direcciones IP, mientras que límites demasiado estrictos pueden afectar a usuarios legítimos que comparten una conexión.

4. Utilizar CAPTCHA con moderación

Los CAPTCHA pueden frenar parte del tráfico automatizado al pedir a los visitantes que completen una prueba. Aun así, pueden resultar molestos, plantear barreras de accesibilidad y perjudicar la experiencia de navegación. Además, algunos sistemas automatizados ya son capaces de superar ciertas pruebas.

Por eso, suelen ser más apropiados para situaciones de riesgo o patrones de actividad sospechosos que como requisito constante para todas las visitas.

Una estrategia equilibrada

La señal compartida en robots.txt ofrece a los sitios una forma sencilla de comunicar sus preferencias sobre el uso de contenidos, pero no debe confundirse con una barrera técnica infalible. Combinar reglas claras con controles de tráfico y medidas de acceso proporcionadas puede reducir el rastreo no deseado sin dificultar innecesariamente la navegación.

Antes de aplicar restricciones, conviene valorar qué se quiere proteger, qué rastreadores se desea permitir y cuánto impacto tendría cada medida en los visitantes. El objetivo es defender el contenido y los recursos del sitio sin sacrificar una experiencia útil para las personas.

from Latest from TechRadar https://ift.tt/tgmclx8
via IFTTT IA

Una temporada de tormentas excepcionalmente activa en el Pacífico


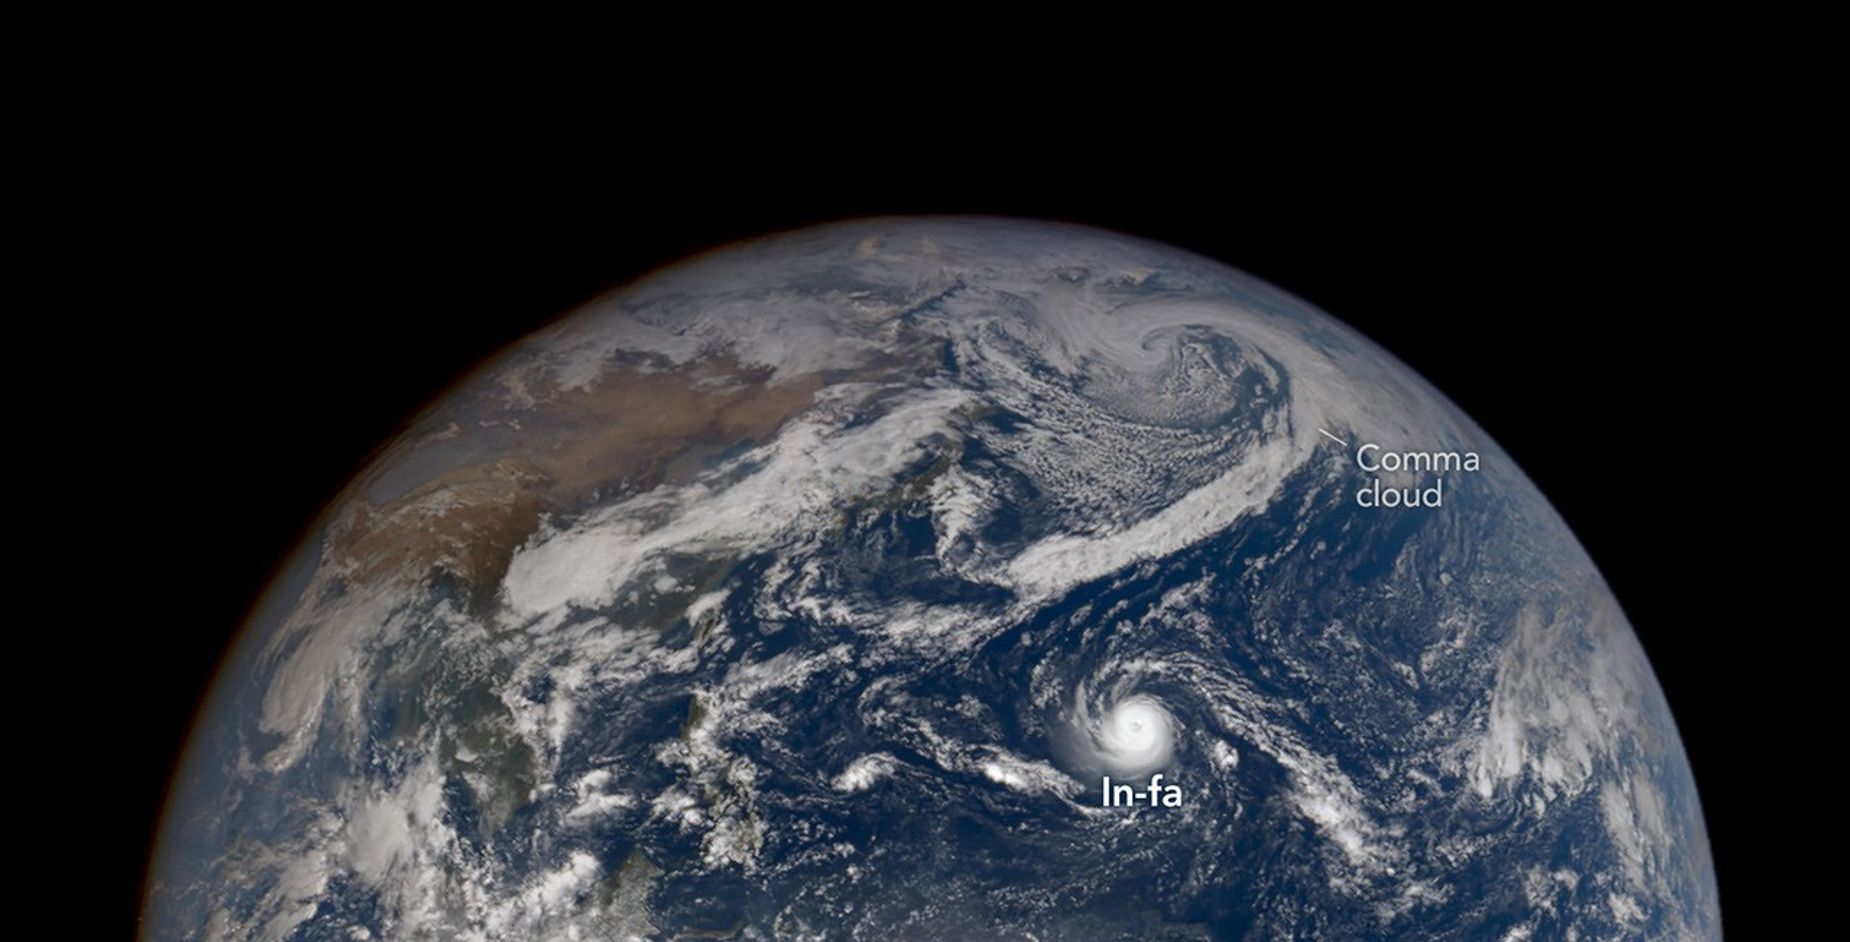
En octubre de 2026, el Pacífico occidental seguía registrando una intensa actividad ciclónica. Una imagen captada por la cámara EPIC, a bordo del satélite DSCOVR, el 29 de octubre mostró dos sistemas muy distintos: el supertifón In-fa cerca de las islas Marianas y los restos del tifón Champi avanzando hacia Alaska.

La escena resume una temporada particularmente activa. Desde abril se habían formado 25 tormentas con nombre en la cuenca del Pacífico noroccidental, después de que el supertifón Sinlaku afectara Micronesia, Guam y las islas Marianas del Norte.

## In-fa: un ciclón de aspecto inusual

El 30 de octubre, el instrumento MODIS del satélite Terra observó In-fa al oeste de las Marianas. El tifón presentaba una forma casi circular y un ojo amplio y bien definido: características asociadas con los llamados ciclones anulares.

Estos sistemas son poco frecuentes. Según un análisis, representan cerca del 4 % de los ciclones tropicales del Pacífico noroccidental. Sus ojos suelen ser más grandes que los de los ciclones convencionales y, en ciertas condiciones desfavorables, pueden conservar su intensidad durante más tiempo. También suelen carecer de las bandas exteriores de lluvia en espiral que caracterizan a muchas otras tormentas; por su forma, a veces se los compara con una dona o un neumático.

In-fa fue el quinto tifón del año en afectar las islas Marianas.

## De tifón a tormenta extratropical

Mientras In-fa continuaba siendo un ciclón tropical, Champi ya había experimentado una transición extratropical al entrar en el mar de Bering. Los ciclones tropicales obtienen energía del calor y la humedad de las aguas cálidas. En cambio, los ciclones extratropicales suelen alimentarse de los contrastes de temperatura entre masas de aire y pueden desarrollar frentes y extensas bandas nubosas curvadas, con forma de coma.

Durante esta transición, el campo de vientos de una tormenta puede expandirse y cubrir una región mucho mayor, aunque los vientos no necesariamente se vuelvan más fuertes. El meteorólogo Gary Partyka, del Centro de Vuelo Espacial Goddard de la NASA, señaló que los restos de Champi probablemente se combinaron con un sistema de latitudes medias y contribuyeron a intensificarlo.

Antes de llegar al norte, Champi había recorrido una larga trayectoria por el Pacífico occidental. Sus vientos sostenidos máximos alcanzaron casi 300 kilómetros por hora. Aunque pasó cerca de Taiwán y Guam, la tormenta provocó vientos dañinos y lluvias intensas en esos lugares, así como en partes de China y Japón. En Alaska, algunas zonas registraron vientos fuertes y precipitaciones de lluvia y nieve, aunque los impactos no alcanzaron la escala de los causados por los restos del tifón Halong en 2025.

Champi fue el cuarto ex-tifón que llegó a aguas de Alaska en 2026, después de Bang-Lang, Dujuan y Choi-wan. Desde 1970, alrededor de 60 ex-tifones han afectado al estado.

## El Niño y la trayectoria de las tormentas

La temporada de 2026 fue especialmente activa en el Pacífico, y el fuerte episodio de El Niño en curso pudo haber contribuido a ese patrón. El Niño se caracteriza por temperaturas del agua superiores a lo habitual en partes del Pacífico ecuatorial y aparece, en promedio, cada dos a siete años.

En el Pacífico noroccidental, esta condición puede favorecer que algunas tormentas se desvíen hacia el norte en lugar de continuar hacia el oeste. Como resultado, aumenta la posibilidad de que se acerquen a Guam, las islas Marianas del Norte, Japón y la península de Corea. La relación entre El Niño y la actividad ciclónica es compleja; por ello, el fenómeno es un posible factor contribuyente, no una explicación única de cada tormenta.

Las observaciones satelitales permiten seguir estos sistemas desde su desarrollo tropical hasta sus cambios de estructura y trayectoria. En conjunto, las imágenes de In-fa y Champi muestran cómo tormentas que nacen sobre aguas cálidas pueden evolucionar de maneras distintas y afectar regiones muy alejadas entre sí.

*Imágenes de NASA Earth Observatory elaboradas por Michala Garrison con datos de DSCOVR EPIC y MODIS, obtenidos a través de EOSDIS LANCE y GIBS/Worldview. Texto original de Adam Voiland.*
from Technology – NASA https://ift.tt/yqYHCFu
via IFTTT

La demanda de macacos para investigación médica crece en medio de una oferta limitada


La inteligencia artificial está acelerando algunas etapas del descubrimiento de fármacos y permite explorar más candidatos terapéuticos. Pero cada posible tratamiento debe superar evaluaciones de seguridad y toxicidad antes de llegar a ensayos clínicos en personas. En ciertos casos, estos estudios incluyen animales, entre ellos macacos, cuya disponibilidad se ha reducido y cuyo precio ha aumentado notablemente.

Según los datos citados en informes recientes, el coste de un macaco pasó de unos 3.000 dólares en 2019 a más de 20.000 dólares en la actualidad. La presión sobre el suministro, sin embargo, comenzó antes de la expansión reciente de la IA en la industria farmacéutica.

### Una propuesta para ampliar la cría en Estados Unidos

Safer Human Medicine, una empresa emergente que cuenta con el respaldo del cofundador de Palantir, Joe Lonsdale, estaría trabajando en un proyecto para crear una gran instalación de cría en Estados Unidos. Su objetivo a largo plazo sería alcanzar una población de hasta 30.000 monos, mediante un crecimiento gradual a lo largo de aproximadamente dos décadas.

La empresa prevé comenzar con entre 500 y 1.000 macacos procedentes de instalaciones de cría de Asia. La iniciativa busca aumentar la producción nacional y reducir la dependencia de los laboratorios estadounidenses respecto de los animales importados.

La necesidad de más animales se vincula, en parte, con el ritmo acelerado de la investigación farmacéutica. La IA puede ayudar a identificar y desarrollar candidatos a medicamentos con mayor rapidez, pero estos deben someterse a pruebas experimentales para evaluar sus efectos biológicos y posibles riesgos. Los macacos se utilizan en algunos estudios por sus similitudes biológicas con los seres humanos, aunque no todas las investigaciones requieren modelos animales.

### Restricciones de suministro y antecedentes de importación

China, que anteriormente representaba alrededor del 60 % de las importaciones estadounidenses de monos para laboratorio, prohibió las exportaciones en 2020. Tras esa decisión, los investigadores buscaron proveedores alternativos. Camboya se convirtió en una fuente importante, pero en 2022 surgieron acusaciones de que algunos animales capturados en estado silvestre se habían presentado como criados en cautividad.

La limitada capacidad de reproducción hace que ampliar la oferta nacional sea un proceso lento. Las hembras de macaco suelen alcanzar la madurez reproductiva alrededor de los cuatro años y, por lo general, tienen una cría al año. Por ello, una nueva instalación necesitaría tiempo antes de poder contribuir de manera significativa al suministro del país.

Se estima que los laboratorios estadounidenses importan unos 20.000 monos al año. Mientras tanto, el precio de los ejemplares procedentes de China se situaría actualmente en torno a los 26.000 dólares, casi nueve veces el nivel registrado en 2019. Estas cifras reflejan tanto la presión sobre el mercado como la vulnerabilidad de los investigadores ante restricciones internacionales.

### Debate sobre bienestar animal y supervisión

El proyecto también ha suscitado críticas de defensores del bienestar animal, preocupados por la cría y el uso de miles de primates en experimentación. Algunos detractores han calificado la propuesta de moralmente inaceptable y han reclamado medidas judiciales. Esas objeciones podrían traducirse en demandas o en otros obstáculos legales que retrasen la construcción o las operaciones.

La propuesta plantea una cuestión compleja: cómo sostener la investigación biomédica y, al mismo tiempo, garantizar que el uso de animales esté justificado, regulado y sujeto a controles estrictos. Su avance dependerá no solo de la capacidad de cría y de la demanda de los laboratorios, sino también de la evaluación regulatoria, las decisiones judiciales y el escrutinio público.

from Latest from TechRadar https://ift.tt/wOzsfRr
via IFTTT IA

Rusia revisa la protección de sus centros de datos ante los ataques con drones


El aumento de los ataques ucranianos contra infraestructuras rusas ha llevado a Moscú a evaluar nuevas medidas para proteger sus centros de datos. Las propuestas abarcan desde redes contra drones y equipos de interferencia de señales hasta sistemas de camuflaje y la construcción de instalaciones subterráneas.

El Ministerio de Desarrollo Digital de Rusia ha elaborado recomendaciones para reforzar la resiliencia de estas instalaciones, esenciales para los servicios en la nube y las operaciones de inteligencia artificial. La protección también contempla medidas frente a las ondas expansivas, con el objetivo de resguardar servidores, fuentes de alimentación y sistemas de refrigeración.

Estas precauciones podrían elevar alrededor de un 10% el coste de cada instalación. Sin embargo, sus defensores sostienen que el gasto es limitado frente a las pérdidas potenciales: una interrupción prolongada podría reducir hasta un 87% el valor de un centro de datos y dejarlo fuera de servicio durante meses.

Una amenaza creciente para la infraestructura digital

Durante 2026, Ucrania ha intensificado sus ataques contra activos industriales rusos. En octubre, cinco centros de datos fueron objeto de ataques, entre ellos la instalación de Balakovo, propiedad de Sberbank y considerada la mayor del país. También fueron alcanzados tres centros de datos de Yandex.

Tras el ataque a Balakovo, Alexander Vedyakhin, primer vicepresidente ejecutivo de Sberbank, afirmó que el centro había sido atacado, pero que los sistemas y servicios del banco continuaban funcionando con normalidad y sin interrupciones.

El periódico ruso Kommersant informó sobre las recomendaciones del Ministerio de Desarrollo Digital, que confirmó que el documento se había enviado a las organizaciones pertinentes. Según la publicación, las directrices comenzaron a circular el 21 de octubre de 2026, en un contexto de creciente preocupación entre empresas y ciudadanos por la vulnerabilidad de la infraestructura de internet.

Protección según la importancia de cada instalación

El plan clasifica los centros de datos en tres categorías: K1 para objetivos estratégicos, K2 para instalaciones de importancia económica y K3 para centros corporativos. Aunque no se han divulgado todos los requisitos correspondientes a cada nivel, es probable que los centros K1 reciban las medidas de protección más amplias.

Entre las opciones consideradas figuran la protección estructural contra ondas expansivas, las redes antidrón, los sensores, los inhibidores de señal y la duplicación de conexiones. El camuflaje y la construcción subterránea también forman parte de las alternativas propuestas, aunque podrían implicar inversiones y desafíos técnicos adicionales.

Roman Chustuzian, director sénior de inversiones de KAMA FLOW, declaró a Kommersant que el coste de refugios, redes, sensores y conexiones redundantes —estimado entre un 5% y un 10% del valor de la instalación— sería menor que el impacto de perder gran parte de su valor y afrontar meses de inactividad.

La revisión refleja un cambio en la forma de entender la seguridad de los centros de datos: ya no basta con protegerlos frente a fallos técnicos o amenazas digitales. En un entorno de ataques físicos, la continuidad de los servicios depende también de la capacidad de resistir daños, mantener la energía y las comunicaciones, y recuperar las operaciones con rapidez.

from Latest from TechRadar https://ift.tt/xPgYRoF
via IFTTT IA

Quordle de hoy, 3 de noviembre: pistas y respuestas del juego #1744


Quordle fue una de las primeras alternativas a Wordle y sigue vigente más de 1.500 partidas después. Aun así, supone un reto considerable. Aquí encontrarás algunas pistas para el Quordle de hoy y, más abajo, las respuestas.

El nuevo tablero aparece a medianoche según la zona horaria de cada jugador, así que algunas personas ya están resolviendo el juego de hoy mientras otras todavía juegan el del día anterior. Si buscas el Quordle del lunes 2 de noviembre, consulta las pistas y respuestas del juego #1743.

¿Te gustan los juegos de palabras? También puedes buscar pistas y respuestas para NYT Connections y NYT Strands, además de la guía diaria de Wordle.

**Aviso: a continuación encontrarás información sobre el Quordle de hoy. No sigas leyendo si no quieres ver las respuestas.**

## Quordle de hoy (juego #1744): pista 1 — vocales

**¿Cuántas vocales diferentes aparecen en las respuestas de hoy?**

Hay **5 vocales diferentes**: A, E, I, O y U. Aquí contamos las cinco vocales estándar, sin incluir la Y.

## Pista 2 — letras repetidas

**¿Alguna respuesta contiene letras repetidas?**

Sí. **Una** de las respuestas de hoy contiene una letra repetida.

## Pista 3 — letras poco frecuentes

**¿Aparece alguna de estas letras: Q, Z, X o J?**

No. Ninguna de las respuestas incluye Q, Z, X o J.

## Pista 4 — letras iniciales

**¿Empiezan varias respuestas con la misma letra?**

No. Las cuatro respuestas empiezan con letras distintas.

## Pista 5 — letras iniciales de cada respuesta

Las respuestas empiezan con: **T, S, L y B**.

Si prefieres conocer las soluciones, están justo a continuación. **No sigas bajando si quieres evitar los spoilers.**

## Respuestas del Quordle de hoy (juego #1744)

Las respuestas son:

– **TRIAL**
– **STAID**
– **LEVEL**
– **BONUS**

La partida de hoy es complicada porque aparecen las cinco vocales. Podría parecer que una de las soluciones incluye una letra poco común, pero no es así: en **LEVEL**, la V ocupa un lugar destacado en una palabra bastante habitual.

## Daily Sequence de hoy (juego #1744)

Las respuestas de la secuencia diaria son:

– **BLAND**
– **CLOSE**
– **MAMBO**
– **TODAY**

## Respuestas recientes de Quordle

– #1743, lunes 2 de noviembre: **EXTRA, AMITY, LUPUS, EAGLE**
– #1742, domingo 1 de noviembre: **DROVE, PRIED, SHELL, BEGIN**
– #1741, sábado 31 de octubre: **ANIME, SWARM, CHALK, RAJAH**
– #1740, viernes 30 de octubre: **ULCER, DIMLY, BRAIN, BEGUN**
– #1739, jueves 29 de octubre: **PRUDE, MINUS, SAVOY, USHER**
– #1738, miércoles 28 de octubre: **DEALT, FLUME, SLEEK, RELIC**
– #1737, martes 27 de octubre: **ANKLE, HAVOC, SULKY, WHITE**
– #1736, lunes 26 de octubre: **ASSAY, GLEAM, MUCUS, WRING**
– #1735, domingo 25 de octubre: **RAINY, BUSED, PROXY, UNDID**
– #1734, sábado 24 de octubre: **TOXIN, SMART, MOUSE, STYLE**
– #1733, viernes 23 de octubre: **BLIMP, HOIST, FRIED, LURID**
– #1732, jueves 22 de octubre: **DECAL, WIDTH, WOKEN, LEVER**
– #1731, miércoles 21 de octubre: **MOIST, VALVE, VERSE, NORTH**
– #1730, martes 20 de octubre: **COYLY, SAUNA, TRIAL, RASPY**
– #1729, lunes 19 de octubre: **EXIST, DECOY, HITCH, FLUID**
– #1728, domingo 18 de octubre: **FLINT, FUROR, WEDGE, RODEO**
– #1727, sábado 17 de octubre: **QUARK, ENEMY, SPASM, BLOCK**
– #1726, viernes 16 de octubre: **SHORT, WORTH, JOIST, SLUNK**
– #1725, jueves 15 de octubre: **STALE, EPOCH, PIANO, CORNY**
– #1724, miércoles 14 de octubre: **TIMID, GROUP, GRILL, EVERY**

from Latest from TechRadar https://ift.tt/JgicXHx
via IFTTT IA

NYT Connections de hoy: pistas y respuestas del martes 3 de noviembre de 2026 (juego #1241)


¡Buenos días! Ya está disponible un nuevo desafío de NYT Connections. El juego propone agrupar 16 palabras en cuatro categorías relacionadas; cada grupo tiene un nivel de dificultad distinto. Si necesitas una ayuda, aquí encontrarás pistas y, más abajo, las soluciones completas.

**Aviso: a continuación hay spoilers.** Si prefieres resolver el rompecabezas por tu cuenta, no sigas leyendo.

## NYT Connections de hoy: palabras del juego #1241

Estas son las 16 palabras de hoy:

– CARRY ON
– CHECK
– ROLLER BAG
– INTERVIEW
– RESUME
– PROFILE
– OFFICE CHAIR
– FOOD
– MENU
– SHOPPING CART
– CREDIT
– CONTINUE
– WHELP
– TAP WATER
– PROCEED
– STROLLER

## Pistas para los grupos de hoy

¿Necesitas una primera orientación? Estas son las pistas para cada categoría:

– **Amarillo:** seguir adelante
– **Verde:** objetos que se pueden mover
– **Azul:** cosas que un camarero o una camarera lleva a la mesa
– **Morado:** palabras ocultas relacionadas con menús de computadora

## Respuestas de los grupos

Si las pistas no fueron suficientes, aquí tienes los nombres de las cuatro categorías:

– **Amarillo:** SEGUIR ADELANTE
– **Verde:** COSAS CON RUEDAS
– **Azul:** COSAS QUE UN CAMARERO LLEVA A LA MESA DE UN RESTAURANTE
– **Morado:** TERMINAN EN TÍTULOS DE LA BARRA DE MENÚS

## Soluciones de NYT Connections de hoy

Las respuestas del juego #1241 son:

– **Amarillo — SEGUIR ADELANTE:** CARRY ON, CONTINUE, PROCEED, RESUME
– **Verde — COSAS CON RUEDAS:** OFFICE CHAIR, ROLLER BAG, SHOPPING CART, STROLLER
– **Azul — COSAS QUE UN CAMARERO LLEVA A LA MESA DE UN RESTAURANTE:** CHECK, FOOD, MENU, TAP WATER
– **Morado — TERMINAN EN TÍTULOS DE LA BARRA DE MENÚS:** CREDIT, INTERVIEW, PROFILE, WHELP

La categoría morada era la más difícil: las palabras terminan con nombres asociados a opciones de una barra de menú, como «Edit», «View», «File» y «Help». El grupo azul, en cambio, resulta especialmente satisfactorio: incluye elementos que se suelen llevar a la mesa, como la comida, el menú, la cuenta y el agua del grifo.

**Dificultad:** fácil. **Resultado:** perfecto.

## Respuestas de NYT Connections de ayer

Si buscabas el juego del lunes 2 de noviembre de 2026 (#1240), estas fueron las soluciones:

– **Amarillo — COSAS QUE LLEVAR A UNA EXCURSIÓN:** BACKPACK, COMPASS, HIKING BOOTS, WATER BOTTLE
– **Verde — ENOJO:** INCENSE, NETTLE, PIQUE, WIND UP
– **Azul — PRODUCTORES DE NIEBLA:** DRY ICE, FOG MACHINE, HUMIDIFIER, WATERFALL
– **Morado — COSAS CON ESPEJOS:** DISCO BALL, DRESSING ROOM, KALEIDOSCOPE, MEDICINE CABINET

## ¿Qué es NYT Connections?

NYT Connections es un juego de palabras del New York Times. El objetivo es encontrar cuatro grupos de cuatro elementos que compartan una característica. Las categorías se distinguen por color y dificultad: amarillo, verde, azul y morado, de la más sencilla a la más compleja.

Se permiten hasta cuatro errores, y puedes resolver el último grupo por eliminación si ya encontraste los otros tres. Aun así, conviene prestar atención a los dobles sentidos, las palabras relacionadas y otros juegos lingüísticos que pueden desviar la atención. El juego está disponible en el sitio de NYT Games, tanto en computadoras como en dispositivos móviles.

from Latest from TechRadar https://ift.tt/EnSx6ym
via IFTTT IA