
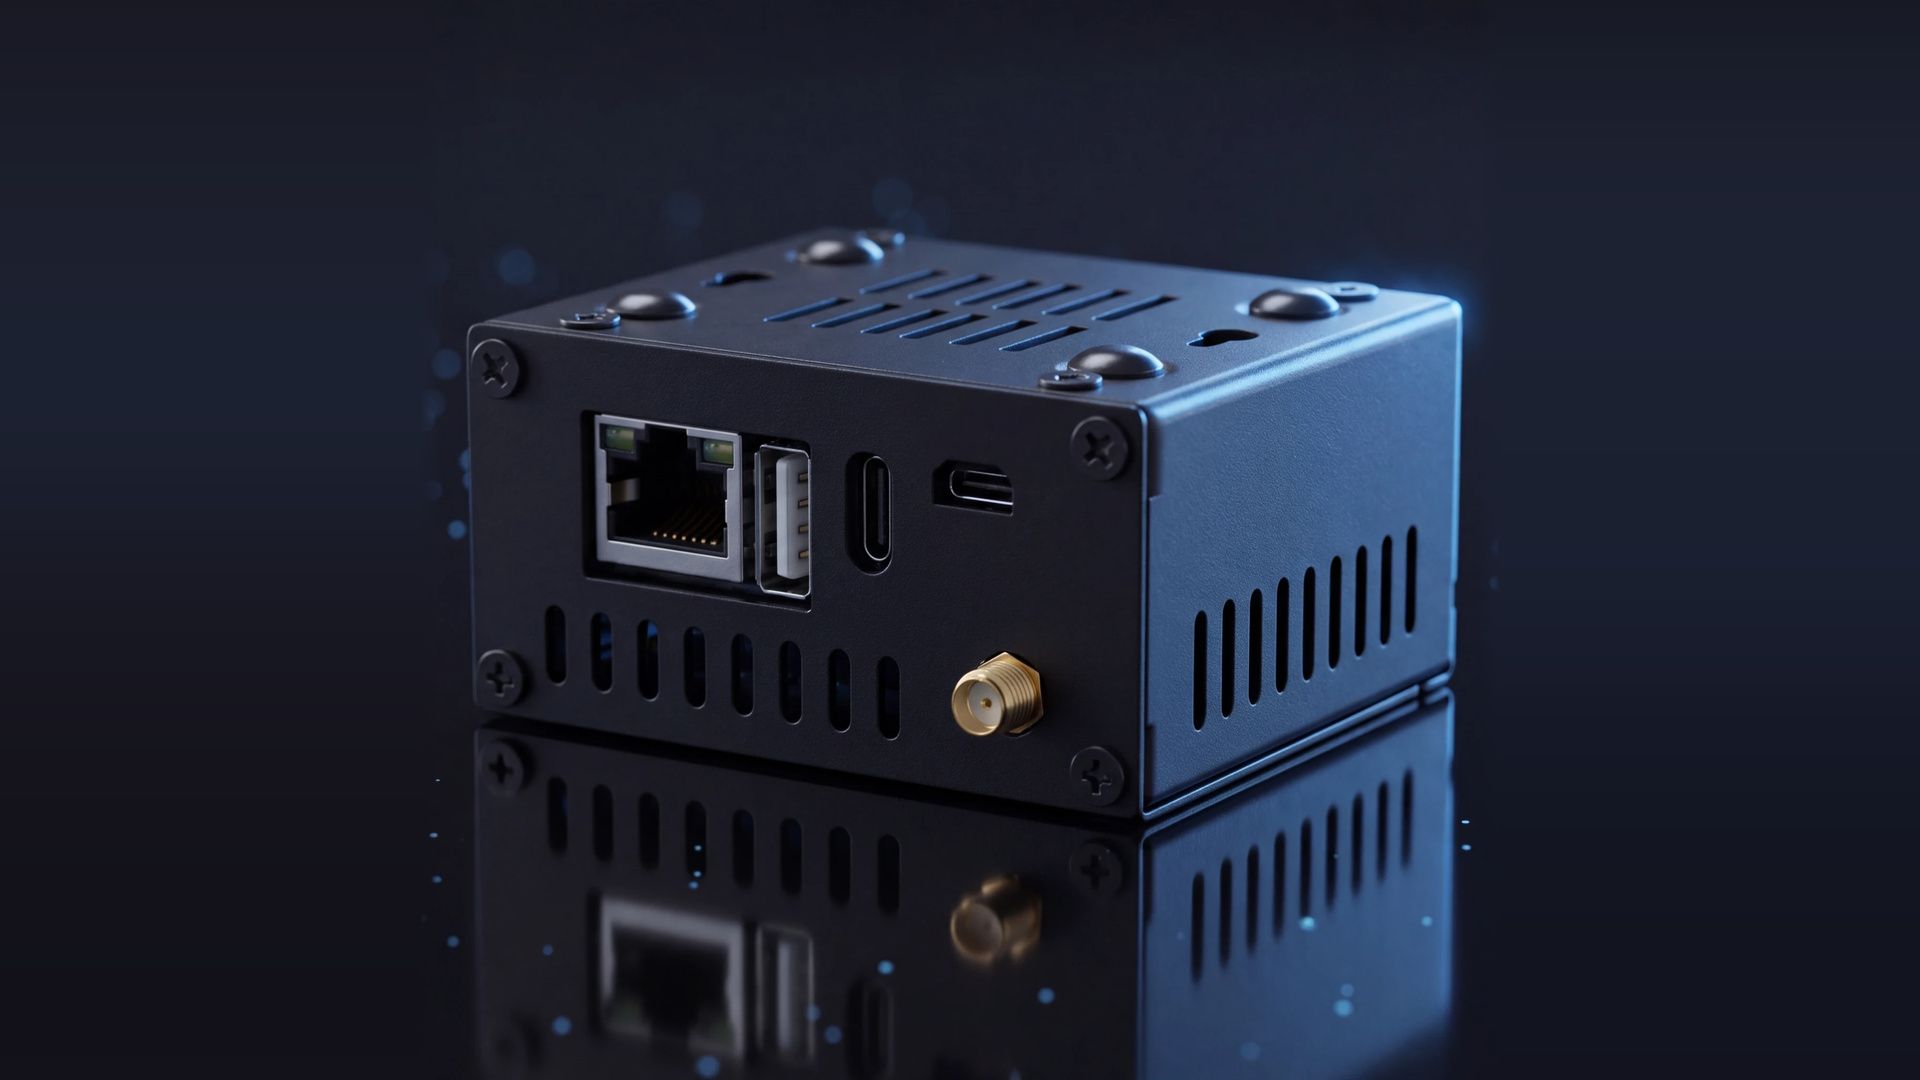
Con los precios de la memoria DDR5 disparados, TradeMAV propone una alternativa a comprar más RAM: aprovechar la que ya está instalada en otros equipos. Su dispositivo RAMDeck, actualmente en campaña de financiación colectiva en Indiegogo, promete conectar PC con Windows, Mac, equipos Linux y teléfonos Android para ejecutar modelos de IA que no cabrían en una sola máquina. El precio anunciado para los primeros patrocinadores es de 109 dólares.
La propuesta llega en un momento complicado para quienes buscan ampliar sus equipos. Los datos de mercado citados por TradeMAV y otras fuentes muestran fuertes aumentos en el precio de la memoria, mientras varios fabricantes anticipan que la escasez podría prolongarse durante años. La empresa afirma, por ejemplo, que un kit DDR5 de 64 GB pasó de costar unos 191 dólares en agosto de 2025 a 1.118 dólares un año después.
## Cómo funciona la agrupación de memoria
Aunque se presenta como una forma de «agrupar RAM», RAMDeck no combina físicamente la memoria de varios dispositivos. En su lugar, distribuye las capas de un modelo entre diferentes máquinas. Cada equipo conserva su parte en la memoria local y, durante la generación de cada token, intercambia resultados intermedios con los demás a través de la red.
El software se apoya en el backend RPC de llama.cpp. Según el repositorio público de TradeMAV, el agente de cada nodo inicia el servidor RPC de ggml de llama.cpp, y un coordinador compatible puede comunicarse con él mediante el protocolo estándar. En otras palabras, la base técnica ya se puede probar sin comprar RAMDeck: llama.cpp ofrece esa funcionalidad de forma gratuita.
La aportación de TradeMAV está en la capa de coordinación. La empresa destaca funciones como el descubrimiento automático de dispositivos, la distribución de capas para priorizar las GPU más rápidas, la recuperación ante fallos, un panel de control y una API compatible con OpenAI. Sin embargo, la documentación pública disponible no detalla las especificaciones del propio hub, como su procesador, memoria, puertos o consumo energético.
## Capacidad a cambio de velocidad
RAMDeck no es la única iniciativa que busca ejecutar modelos de IA en varios dispositivos. El proyecto de código abierto exo ofrece descubrimiento automático y una API para crear clústeres con ordenadores, teléfonos y placas de desarrollo. En el extremo más caro, Apple promociona la conexión de varios Mac Studio mediante Thunderbolt 5 para acelerar la inferencia.
La apuesta distintiva de RAMDeck es la compatibilidad entre plataformas: su documentación menciona combinaciones de PC con CUDA, Mac con Apple Silicon, Mac Intel, equipos Linux y teléfonos Android. Pero esa flexibilidad tiene un coste. TradeMAV reconoce que la memoria agrupada prioriza la capacidad sobre la velocidad y recomienda una GPU con más VRAM a quienes buscan el máximo rendimiento.
Los resultados más llamativos de la empresa se apoyan en un mini PC Beelink con una RTX 3060 y en modelos de mezcla de expertos, que activan solo una parte de sus parámetros para cada token. TradeMAV informa de 39 tokens por segundo con Qwen3-Coder 30B distribuido entre el mini PC y un Mac mini M4, y de 16 tokens por segundo con una variante REAP de 40.000 millones de parámetros. En una prueba de un modelo de 7.000 millones de parámetros, los 43 tokens por segundo se obtuvieron, según la empresa, en la RTX 3060.
Los modelos densos ofrecen una imagen distinta. Un modelo de 27.000 millones de parámetros alcanzó 1,92 tokens por segundo en cuatro dispositivos, mientras que gpt-oss-120b llegó a 1,37 tokens por segundo en un clúster de seis equipos. Otra prueba con un modelo de 120.000 millones de parámetros registró 3,1 tokens por segundo en cinco máquinas, tras unos siete minutos de inicialización. Poder ejecutar un modelo que de otro modo no cabría puede ser útil, pero esas velocidades serán demasiado bajas para muchos usos cotidianos.
## ¿Para quién tiene sentido RAMDeck?
RAMDeck ofrece una manera de experimentar con modelos más grandes usando hardware que ya se tiene, y su interfaz podría resultar atractiva para quienes prefieren una solución guiada a configurar cada componente manualmente. Aun así, el núcleo de la propuesta se basa en software libre que los usuarios más técnicos pueden probar sin coste, y las pruebas publicadas muestran que el aumento de capacidad puede venir acompañado de una reducción considerable de velocidad.
Antes de aportar dinero, conviene comparar las especificaciones y el rendimiento con alternativas gratuitas como llama.cpp en modo RPC y exo. Los 109 dólares anunciados compran, por ahora, la promesa de una experiencia más sencilla, no un producto disponible de inmediato. Como ocurre con cualquier campaña de financiación colectiva, existe el riesgo de retrasos, cambios o de que el producto no llegue a entregarse.
from Latest from TechRadar https://ift.tt/cMGCSB0
via IFTTT IA

