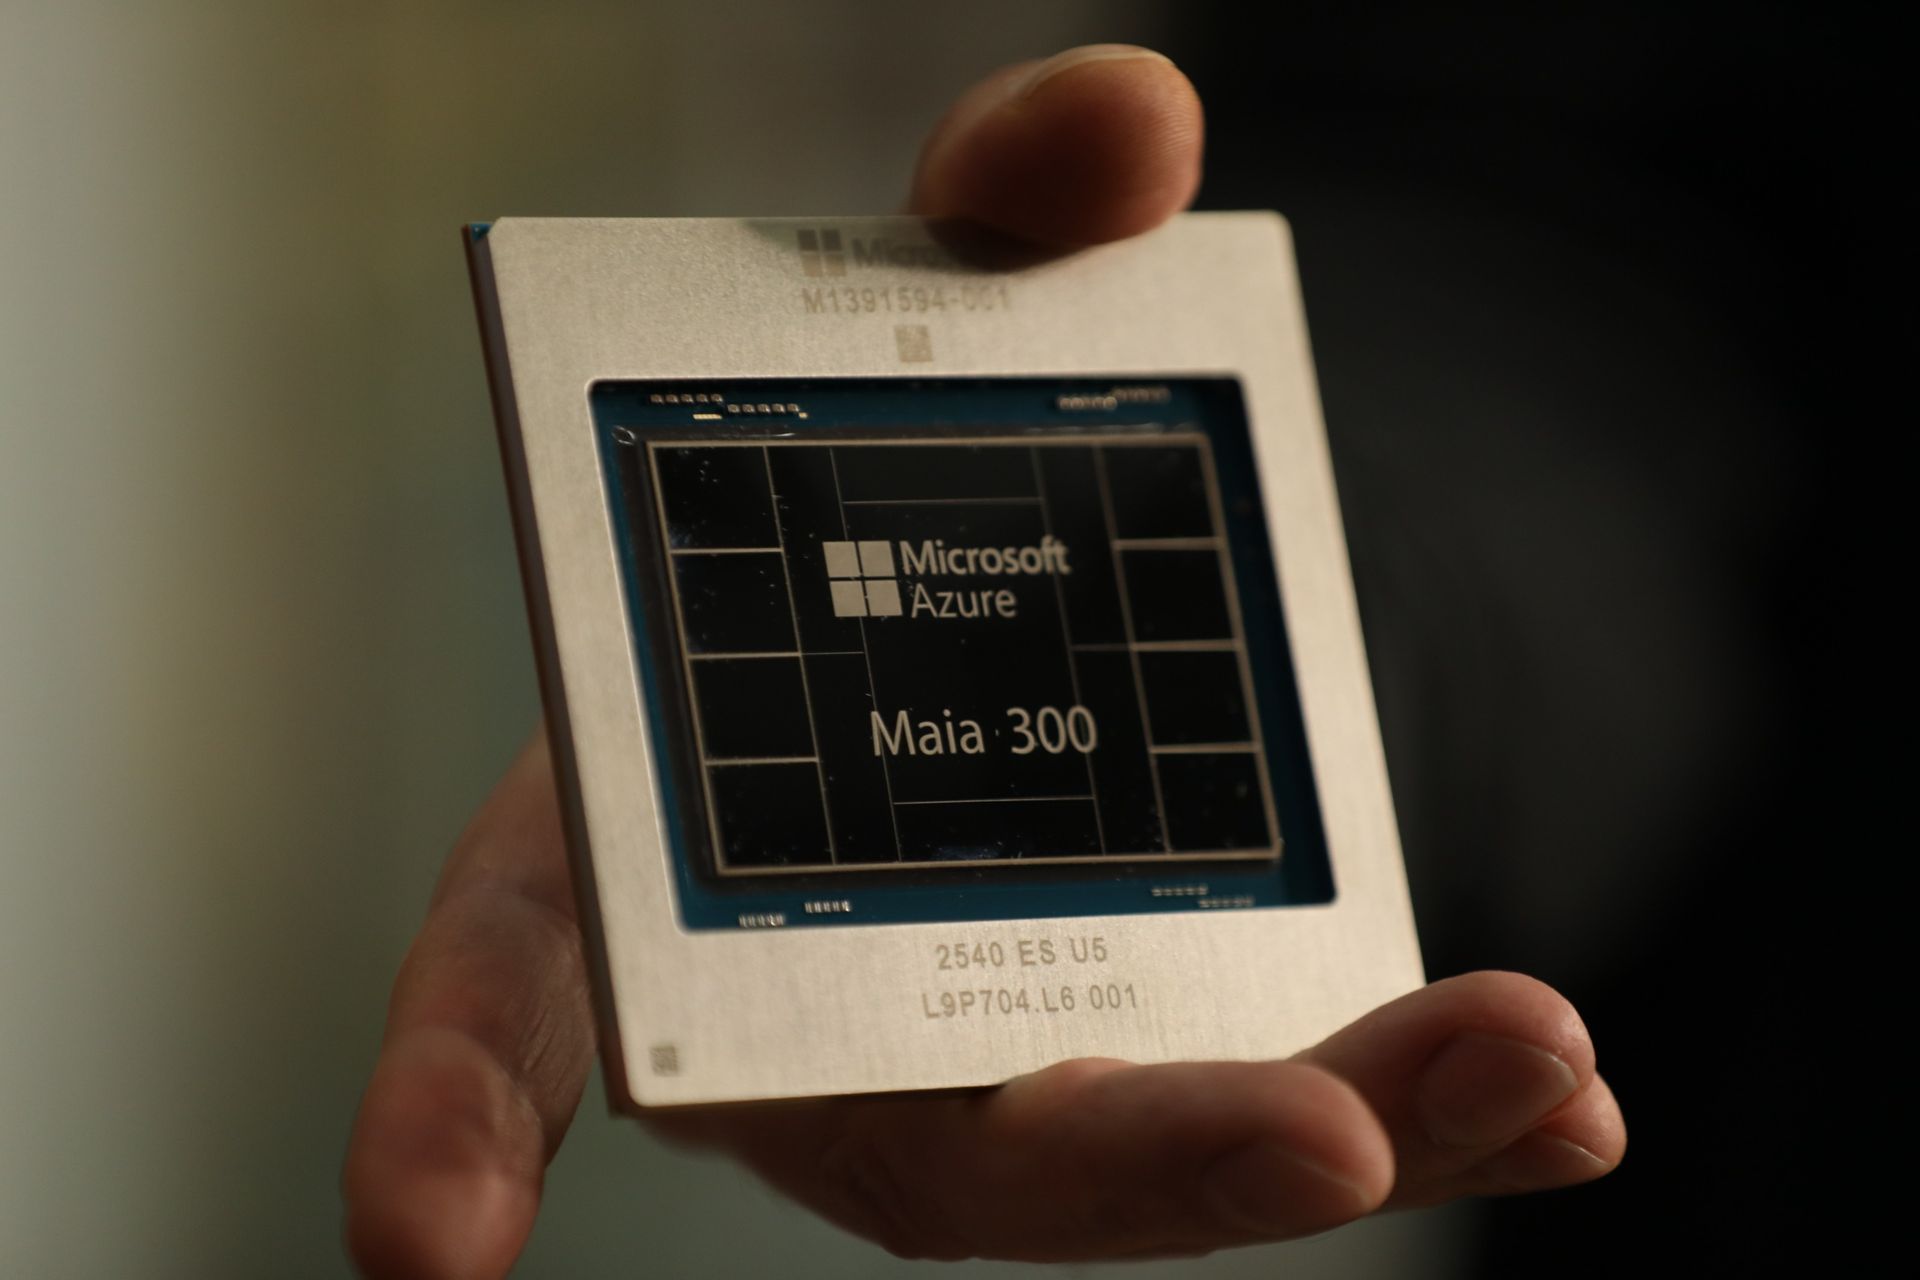
Microsoft ha presentado Maia 300, la próxima generación de su infraestructura de hardware en Azure, diseñada para escalar a despliegues de hasta varios gigavatios. Este lanzamiento enfatiza un enfoque centrado en la inferencia, prometiendo mejoras significativas en eficiencia y rendimiento energético en comparación con las arquitecturas basadas principalmente en GPU. Con despliegue previsto para 2027, Maia 300 apunta a sostener tareas de razonamiento de contexto amplio, IA conversacional sensible y tareas de agente multi‑paso de forma continua.
En una evidencia de su potencia, un rack que alberga 96 aceleradores Maia 300 puede alcanzar hasta siete veces el rendimiento de token por rack en comparación con un rack Maia 200. Este énfasis en la inferencia abre la puerta a una nueva generación de IA integrada en productos y servicios de Microsoft, desde codificación guiada por agentes en GitHub hasta servicios a gran escala a través de Microsoft Foundry. También se espera que mejore las capacidades de inferencia y generación de datos para el equipo de Microsoft AI, afectando a herramientas como Copilot y Cowork, así como a productos individuales como Microsoft Teams.
Maia 300 está diseñado con una arquitectura de inferencia primero, orientada a reducir el movimiento de datos y a utilizar de manera más eficiente los recursos de cómputo, memoria y red. Su enfoque de flujo de datos definido por software, junto con la optimización de kernels asistida por IA, busca mantener los datos cerca de las partes del sistema que los requieren. El diseño sitúa la memoria en el centro, utilizando ocho pilas de HBM4 con un rendimiento pico de 18 TB/s dentro de un presupuesto de potencia de 950 W, y emplea memoria SRAM en chip como área de scratchpad para aliviar la presión de la HBM durante cargas exigentes.
Una novedad clave es la introducción de una arquitectura multi‑chiplet que separa las funciones de cómputo, controlador de memoria y entrada/salida. Los chiplets de cómputo se producirán con el proceso N2P de TSMC. Maia 300 admite formatos de baja precisión, incluido un MXFP4 mejorado, para reducir las demandas de memoria y ancho de banda, permitiendo manejar ventanas de contexto más amplias y aumentar el rendimiento dentro de la misma envolvente de potencia.
La conectividad está integrada en el diseño como parte del flujo de datos del sistema, en lugar de ser una capa separada. Maia 300 emplea conexiones de alto ancho de banda entre aceleradores para paralelismo de tensores y un transporte AI personalizado basado en infraestructura Ethernet. Este enfoque está diseñado para escalar desde un único rack hasta despliegues en centros de datos completos.
Un rack Maia 300 albergará 96 aceleradores dentro de una envolvente de potencia de 167 kW, con una capacidad de HBM de 27,6 TB y un ancho de banda agregado de 1,7 petabytes por segundo. Esta densidad está orientada a atender más interacciones simultáneas de IA y cargas de trabajo más grandes desde cada rack.
El anuncio se apoya en Maia 200, ya en producción y funcionando con cargas como Microsoft 365 Copilot y modelos desarrollados por el equipo de Microsoft AI. Maia 200, por su parte, ofrece hasta 1,7 veces más tokens por vatio que infraestructuras GPU líderes para funciones de IA integradas en Teams, Copilot y Cowork, con Github Copilot y Microsoft Foundry previstas para seguir a finales de año.
En conjunto, Maia 300 representa una pieza estratégica para la visión de Microsoft de ampliar la escala y la eficiencia de sus capacidades de IA, con un énfasis claro en la inferencia de alto rendimiento y en soluciones que pueden integrarse directamente en el ecosistema de Microsoft a través de sus productos y servicios.
from Latest from TechRadar https://ift.tt/VnZP50x
via IFTTT IA

