Huawei está impulsando la expansión de su plataforma Ascend con sistemas de mayor escala destinados a manejar modelos de IA de hasta 10 billones de parámetros. En el centro de esta estrategia se encuentra UnifiedBus, una arquitectura de interconexión diseñada para conectar procesadores, memoria y almacenamiento con una sobrecarga de comunicación reducida. Esta apuesta ofrece una vía adicional para compensar las limitaciones de hardware que han limitado a los aceleradores individuales de Ascend frente a la competencia de Nvidia, al tiempo que facilita que miles de chips trabajen dentro de un entorno de cómputo compartido.
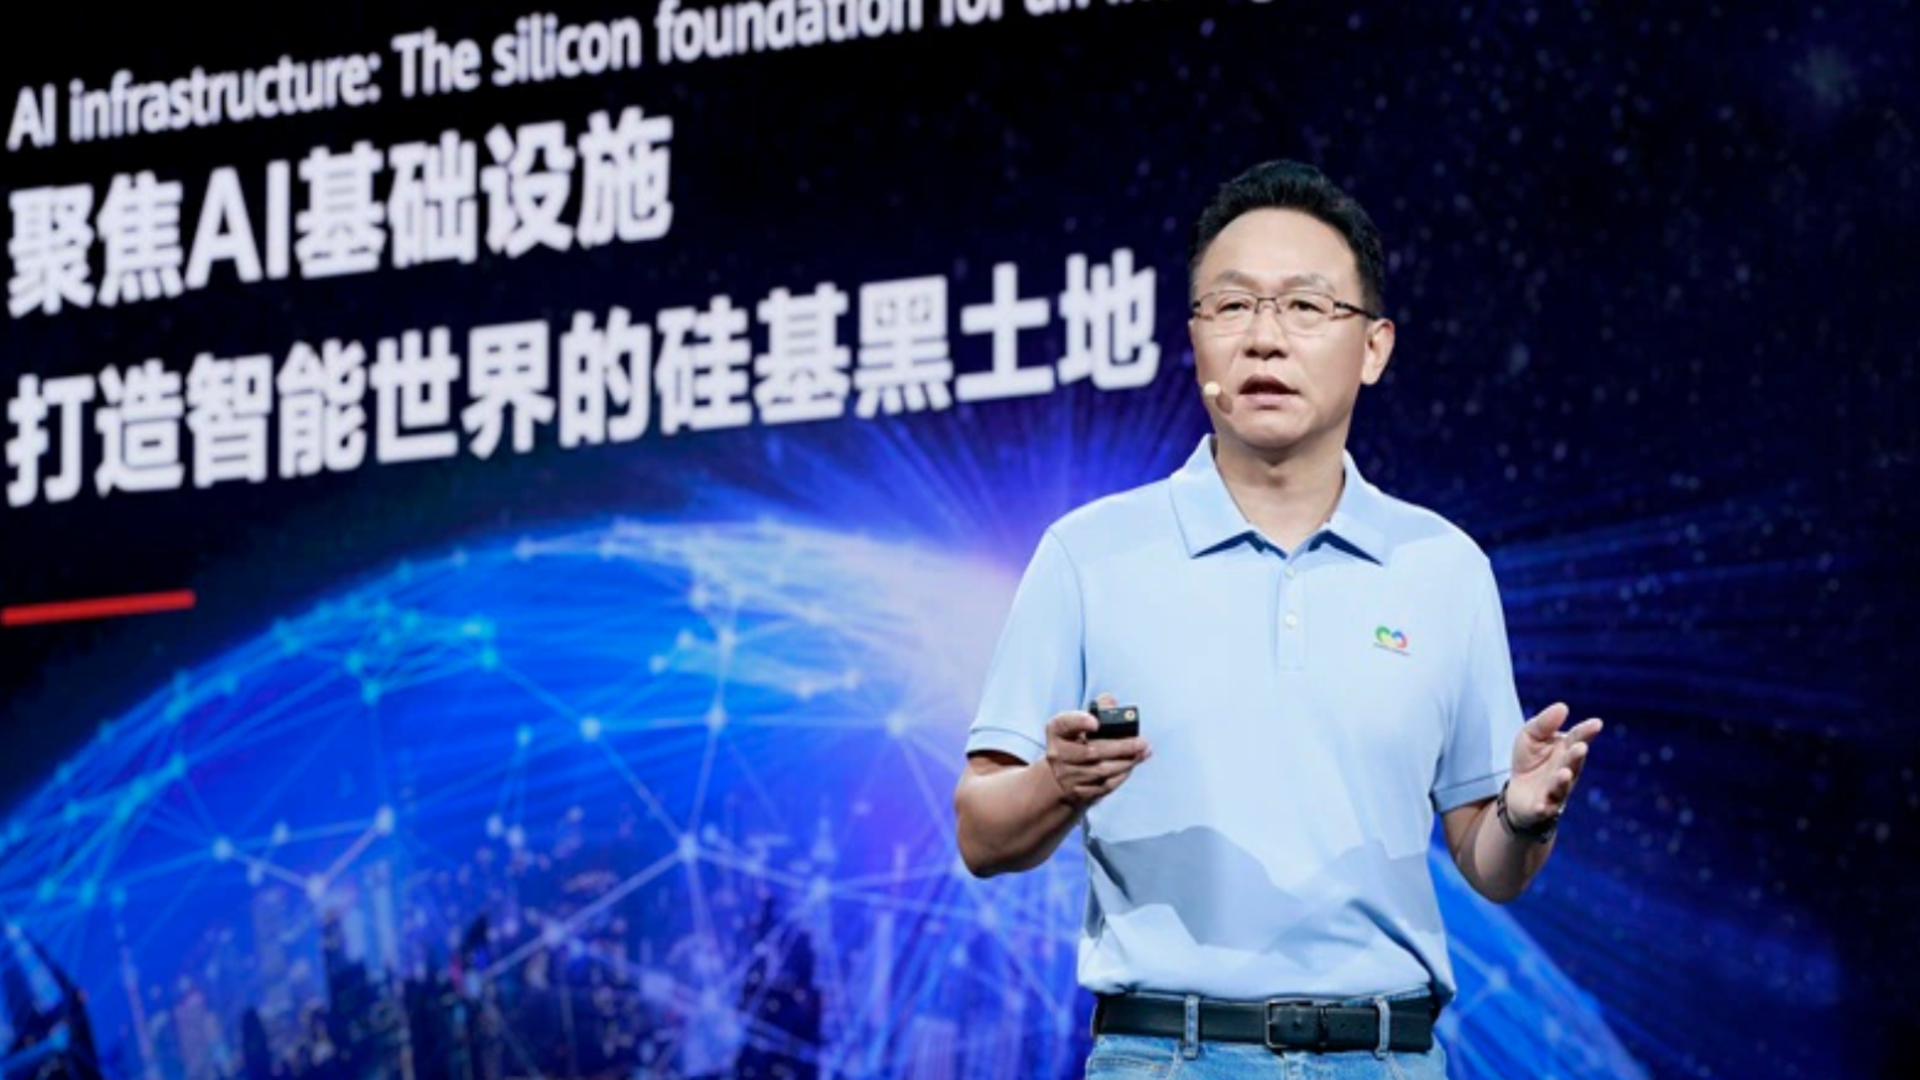
Huawei ha presentado un avance significativo con la expansión del sistema Ascend 960. Según la hoja de ruta del Atlas 960 SuperPoD, se contempla una configuración de hasta 15.488 procesadores Ascend 960, un incremento respecto de la configuración previa de 8.192 procesadores. Este sistema está diseñado para rendir 30 EFLOPS en FP8 y 60 EFLOPS en FP4, con una capacidad de memoria de 4.460 TB y un ancho de banda de interconexión de 34 PB/s. En cuanto a rendimiento de entrenamiento, la empresa apunta a alcanzar 15,9 millones de tokens por segundo. Las versiones 960DT y 960PR están previstas para primeros semestres de 2027 y 2027, respectivamente, con mejoras de rendimiento que, según Huawei, han superado las proyecciones originales. David Wang, vicepresidente y presidente interino de Huawei, ha destacado que la compañía está evolucionando su serie Ascend en un ciclo de un generación por año, con planes para 2028 y 2029 de presentar los chips Ascend 970 y 980, respectivamente, apoyados por la Ley de Escalamiento Tau (τ).
En paralelo, UnifiedBus está detrás de la interconexión de 4.096 NPUs dentro del Atlas 960E, una variante del 960 que proporciona acceso compartido a memoria a través del SuperPoD. Esta arquitectura se complementa con Hi-ONE, una tecnología óptica que extiende conexiones de alta velocidad más allá de los componentes cercanos y utiliza ópticas cercanas a los procesadores (near-packaged optics, NPOs) para mejorar velocidades de transmisión y reducir el consumo energético. Huawei afirma que este enfoque permite mover datos entre miles de procesadores sin depender exclusivamente de enlaces ópticos externos al sistema de cómputo.
La implementación de Atlas 960E promete una reducción sustancial de consumo de energía, estimándose un ahorro de más de 550 kilovatios en el sistema de interconexión de procesadores. En rendimiento, Atlas 960E ofrece 8 EFLOPS en FP8 y admite modelos de hasta 10 billones de parámetros. Además, estos sistemas pueden conectarse a SuperClusters que albergan hasta 512.000 NPUs, con la arquitectura diseñada para configuraciones de millones de procesadores. Este enfoque de mayor cantidad de procesadores con comunicaciones más rápidas busca cerrar la brecha frente a soluciones de Nvidia mediante la ampliación del paralelismo y una conectividad más eficiente.
En resumen, la evolución de Huawei hacia sistemas de gran escala impulsados por UnifiedBus y la familia Ascend 960 representa una estrategia orientada a ampliar la capacidad de cómputo en IA mediante redes interconectadas y soluciones de interconexión avanzadas. Con hitos que incluyen sistemas de hasta 15.488 procesadores, anchos de banda de múltiples petabits por segundo y mejoras continuas en la eficiencia energética, Huawei está posicionando sus plataformas para soportar modelos de IA cada vez más complejos, al tiempo que diversifica su red de interconexión para sostener el rendimiento en tareas de entrenamiento e inferencia de alto nivel.
from Latest from TechRadar https://ift.tt/Rc2vd35
via IFTTT IA
 Pacosite's Blog
